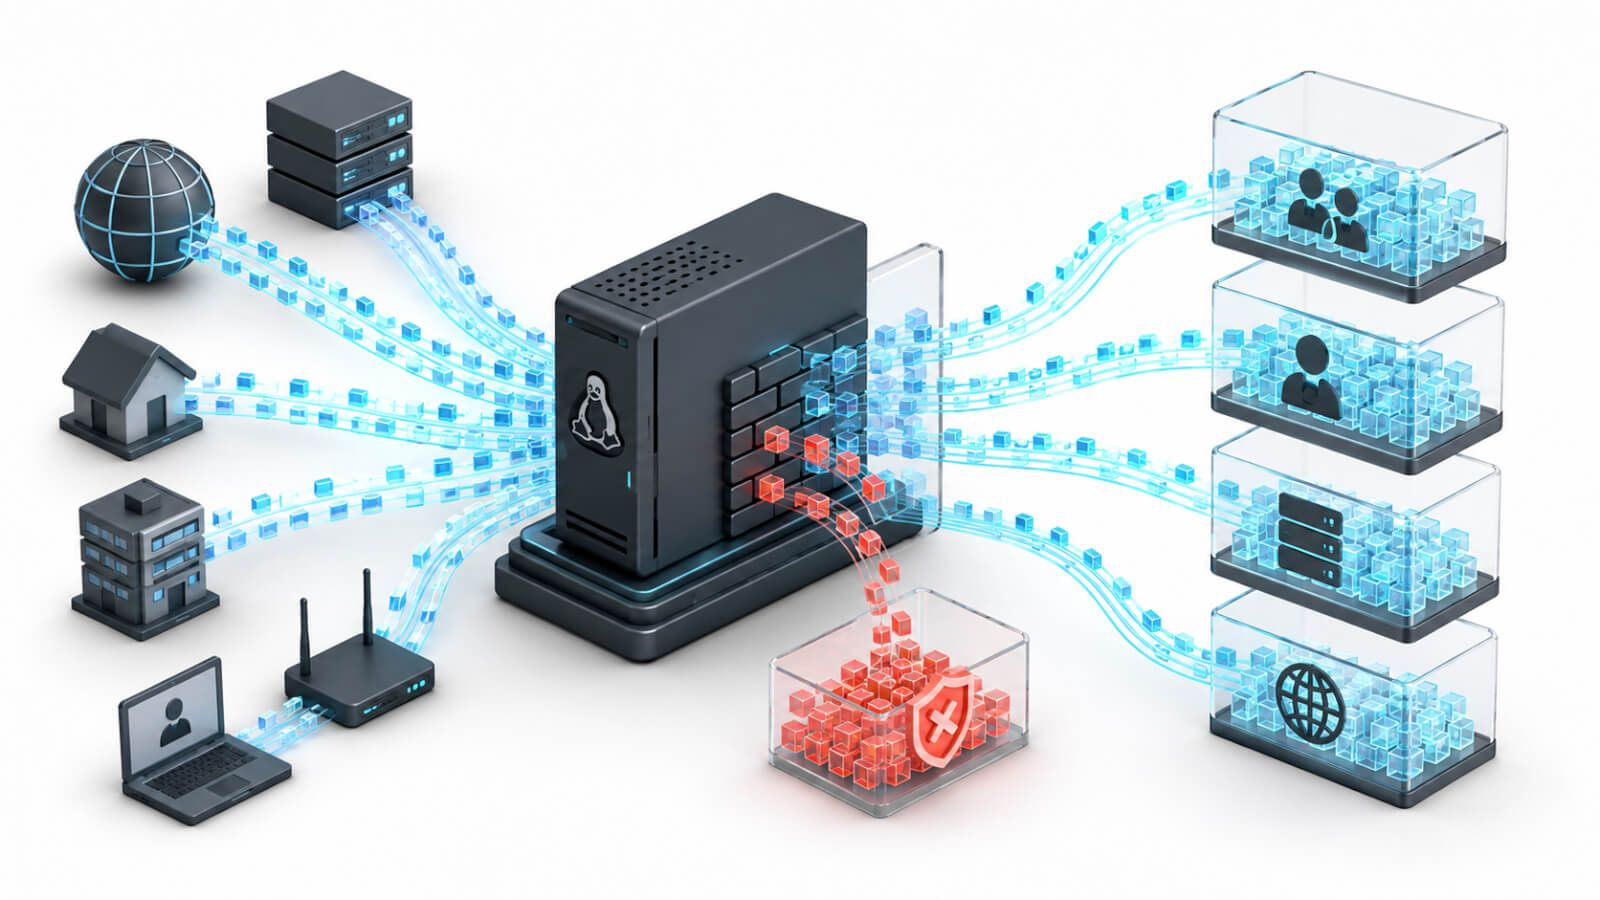
Disaggregated prefill и decode для LLM: как разделить inference между GPU-серверами
Практическое руководство по disaggregated prefill/decode для LLM: разделение GPU-worker pools, перенос KV cache через NIXL, sizing, сеть, метрики и безопасный production rollout.
Андрей Минин, автор блога