Оглавление
- Быстрый вердикт: когда fq_codel действительно помогает
- Где живёт очередь: application, qdisc, NIC или сеть
- Baseline: что снять до первого tc qdisc replace
- Четыре evidence gate: от пути до LLM outcome
- Безопасный canary: меняем одного owner
- Как читать backlog, drops, ECN и requeues
- ECN и drops: сигнал congestion, а не цель настройки
- fq_codel, fq или CAKE: выбор по механизму
- Когда проблема уже в границе контроля инфраструктуры
- Production rollout: persistence, observability и rollback
- Короткий incident runbook без магических параметров
- Нагрузочный профиль: как воспроизвести именно свой bufferbloat
- Частые ошибки, из-за которых canary лжёт
- Вывод: qdisc меняют после доказательства, а не по привычке
Готовы перейти на современную серверную инфраструктуру?
В King Servers мы предлагаем серверы как на AMD EPYC, так и на Intel Xeon, с гибкими конфигурациями под любые задачи — от виртуализации и веб-хостинга до S3-хранилищ и кластеров хранения данных.
- S3-совместимое хранилище для резервных копий
- Панель управления, API, масштабируемость
- Поддержку 24/7 и помощь в выборе конфигурации
Результат регистрации
...
Создайте аккаунт
Быстрая регистрация для доступа к инфраструктуре
Быстрый вердикт: когда fq_codel действительно помогает
LLM API отвечает быстро на тестовом запросе, но под параллельной выгрузкой модели или большим числом streaming-сессий токены начинают приходить рывками. CPU gateway не упирается в потолок, GPU не заполнен, а медиана выглядит терпимо. Зато p99 RTT и паузы между токенами растут вместе с исходящим трафиком. Это характерный, но ещё не доказанный признак очереди на egress.
Рабочий default: не меняйте qdisc, пока не свяжете четыре факта на одном временном окне: фактический сетевой путь, backlog/drops конкретной qdisc, состояние транспорта и пользовательский outcome. Если backlog не растёт, а задержка уже появилась до первого байта, ищите DNS, TLS, proxy queue или GPU scheduler. fq_codel не лечит чужую очередь.
Когда bottleneck действительно находится на Linux egress, fq_codel полезен двумя свойствами: он разводит flows по очередям и применяет Controlled Delay к каждой из них. Большая передача перестаёт безоговорочно стоять впереди короткого интерактивного потока. Это не обещание «ускорить сеть», а способ ограничить стоячую очередь там, где Linux контролирует dequeue.
В этой статье мы строим проверяемый runbook для Linux gateway перед LLM inference. Он дополняет материалы про TCP buffers и HTTP/2 flow control: socket memory и protocol window находятся на других слоях и требуют собственных доказательств.
Где живёт очередь: application, qdisc, NIC или сеть
Начните с owner map. Исходящий ответ LLM проходит userspace proxy, TCP socket, qdisc, драйвер, TX ring и внешний hop. Backlog может возникнуть в любом из этих мест. Команда tc видит только слой traffic control; пустая qdisc не оправдывает приложение, а заполненная qdisc ещё не доказывает, что именно она портит SLO.
На физическом multiqueue-интерфейсе root часто представлен mq, а рабочие qdisc находятся на leaf очередях. На veth и loopback поведение и defaults отличаются; системный net.core.default_qdisc не гарантирует, что уже существующий интерфейс немедленно получил новый leaf. Поэтому вопрос «какой qdisc включён на сервере» слишком общий. Нужен ответ для конкретного egress device и namespace, через который прошёл проблемный flow.
Представьте gateway с двумя интерфейсами: клиентский трафик выходит через bond, а health checks — через management NIC. Наблюдать qdisc на management-интерфейсе удобно и совершенно бесполезно. Сначала зафиксируйте route decision и фактический peer, затем переходите к очереди. Тот же принцип использован в runbook про policy routing и rp_filter.
ip route get 203.0.113.25
ip -details link show dev eth0
tc -s -d qdisc show dev eth0
tc -s class show dev eth0
Baseline: что снять до первого tc qdisc replace
Надёжный baseline — это не один скриншот счётчиков после инцидента. Запишите состояние до нагрузки, во время воспроизводимого burst и после него. Для qdisc нужны как минимум тип и handle, backlog в байтах и пакетах, drops, overlimits, requeues и расширенные fq_codel counters. Для интерфейса добавьте TX errors/dropped и драйверные статистики. Для транспорта — RTT, retransmissions и pacing/cwnd конкретных соединений.
Снимайте дельты, а не абсолютные значения с момента boot. Миллион drops за полгода ничего не говорит о пяти минутах деградации. Практический вариант: два последовательных snapshot с timestamp и идентификатором canary-нагрузки. Если counters доступны в Prometheus, всё равно сохраните raw вывод: он поможет заметить leaf qdisc, которую агрегированный exporter пропустил.
Application gate должен жить рядом с сетевым. Для streaming LLM полезны TTFT, распределение пауз между событиями SSE/gRPC, доля оборванных ответов после headers и полезный throughput. Не сводите всё к requests per second: очередь может почти не менять RPS, но сделать диалог неприятным из-за длинного хвоста задержки.
Проверьте также ip -s -s link и ethtool -S. Если TX ring или драйвер теряет пакеты, смена AQM может изменить картину, но не устранить аппаратный или CPU bottleneck. Связь IRQ, queue и softirq разобрана отдельно в статье про RSS, RPS и IRQ affinity.
date -Is
tc -s -d qdisc show dev eth0
ip -s -s link show dev eth0
ethtool -S eth0 | sed -n '1,120p'
ss -tin dst 203.0.113.25
Четыре evidence gate: от пути до LLM outcome
Gate 1 — effective path. Подтвердите namespace, route, interface и termination point. Если TLS завершается на внешнем load balancer, qdisc backend-узла не управляет клиентским плечом. Если gateway работает в pod, проверьте host network, veth, CNI и node egress: пакет может пройти несколько qdisc.
Gate 2 — queue state. Под нагрузкой backlog должен расти на том же leaf/root, который обслуживает flow. Для fq_codel смотрите не только общий dropped, но и drop_overlimit, ecn_mark, длины new/old flows и текущую задержку, если она доступна в выводе iproute2. Стоячая очередь — это устойчивое состояние, а не короткий burst, который исчезает без заметного application effect.
Gate 3 — transport. Сопоставьте событие очереди с RTT, retransmissions, pacing и состоянием отправителя. Если sender app_limited, он не заполняет доступный путь; тюнинг qdisc вряд ли даст эффект. Если сегмент — QUIC/UDP или трафик уже сформирован upstream appliance, TCP-only интерпретация тоже неверна.
Gate 4 — application outcome. Повторите одинаковую смесь коротких и длинных ответов. Улучшение qdisc counters без снижения межтокенных пауз, tail latency или ошибок не считается успехом. И наоборот: если приложение ускорилось, но qdisc была пустой, найдите фактическое изменение — возможно, canary отличался CPU placement или connection reuse.
Для каждого gate нужен отрицательный контроль. Например, один idle gateway, один поток через другую NIC либо запрос с отключённой большой фоновой передачей. Контроль делает причинность видимой и защищает от удобной, но ложной истории.
Безопасный canary: меняем одного owner
Лучший canary — отдельный gateway-узел с той же версией kernel, iproute2, proxy и драйвера. Направьте на него небольшую репрезентативную долю новых соединений, сохранив baseline-узел неизменным. Для long-lived streaming connections переключение балансировщика не переместит уже открытые flows, поэтому маркируйте тестовые клиенты или создавайте fresh connections.
Перед заменой сохраните полный вывод tc -s -d qdisc. Команда replace удобна, но она меняет live dataplane: задайте stop condition заранее. Например, rollback при росте application errors, падении полезного throughput или неожиданном росте drops на non-ECN клиентах. Не выбирайте универсальный процент — порог должен следовать из вашего SLO и baseline.
Минимальный тест начинается с defaults fq_codel. По upstream man page defaults включают 1024 flow buckets, target 5 ms, interval 100 ms, packet limit 10240 и memory limit 32 MB; ECN включён. Это стартовая точка, не рекомендация для любого RTT или memory envelope. Особенно осторожно меняйте interval: он должен быть порядка худшего RTT через bottleneck, чтобы endpoints успевали отреагировать.
Параметры и их текущая семантика сверены с upstream tc-fq_codel(8); перед rollout всё равно проверяйте man page из версии iproute2, установленной на вашем узле.
tc -s -d qdisc show dev eth0 > /var/tmp/qdisc.before

tc qdisc replace dev eth0 root fq_codel
sleep 2
tc -s -d qdisc show dev eth0

# Rollback example: replace with the baseline captured for this host.
tc qdisc replace dev eth0 root fq

tc -s -d qdisc show dev eth0 > /var/tmp/qdisc.after-rollback
Как читать backlog, drops, ECN и requeues
В fq_codel drop — часть механизма обратной связи, а не автоматический признак поломки. CoDel отслеживает минимальную задержку пакета в очереди на интервале. Когда стоячая задержка остаётся выше target, AQM начинает сигнализировать congestion: ECN-capable packets можно маркировать, остальные — сбрасывать. Цель не нулевой drop, а короткая очередь при приемлемой утилизации.
drop_overlimit означает достижение packet или memory hard limit; это отличается от управляемых AQM drops. Устойчивый overlimit под рабочей нагрузкой требует проверить capacity и выбранный envelope. Простое увеличение limit может лишь спрятать задержку в более глубоком буфере. Снижение limit без canary, напротив, способно превратить burst tolerance в потери.
new_flow_count, new_flows_len и old_flows_len помогают понять активность scheduler, но их нельзя переводить напрямую в число пользователей. FQ использует stochastic hashing: разные потоки могут попасть в один bucket. При огромном числе flows collision risk растёт, однако увеличение flows расходует память и задаётся при создании qdisc.
Requeues — отдельный сигнал. Они могут появляться между qdisc и драйвером, например при busy TX path. Сопоставьте их с BQL, driver counters, CPU softirq и multiqueue leafs. Называть каждый requeue «packet loss» неверно: пакет мог быть возвращён в очередь и позже успешно отправлен.
ECN и drops: сигнал congestion, а не цель настройки
fq_codel включает ECN по умолчанию, но end-to-end эффект зависит от endpoints и middleboxes. Маркировка CE полезна, только если transport sender действительно получает и обрабатывает сигнал. Поэтому после включения не ограничивайтесь ростом ecn_mark: проверьте реакцию congestion control, RTT и application outcome на новых соединениях.
Параметр ce_threshold предназначен для очень мелких очередей и DCTCP-подобных алгоритмов. В обычной интернет-схеме копировать datacenter threshold рискованно: другой RTT, другая ECN negotiation и неизвестные middleboxes меняют результат. Если функция нужна лишь части трафика, upstream поддерживает selector по ECN/Diffserv byte, но это уже отдельный rollout с классификацией и контролями.
Есть и практическая ловушка: offload меняет вид пакетов в разных точках capture. Большой skb до segmentation не равен гигантскому пакету на wire. Если после qdisc change вы видите странные размеры или checksum errors в локальном tcpdump, сначала проверьте GRO/GSO/TSO. Наш отдельный runbook по Linux network offload показывает, где снимать wire-side доказательство.
Для LLM streaming сравнивайте как минимум два класса: короткие интерактивные ответы и длинные генерации рядом с bulk transfer. fq_codel должен защищать latency-sensitive flows от очереди, но не обязан улучшать GPU compute time. Если TTFT определяется scheduler модели, сетевой AQM не изменит его.
fq_codel, fq или CAKE: выбор по механизму
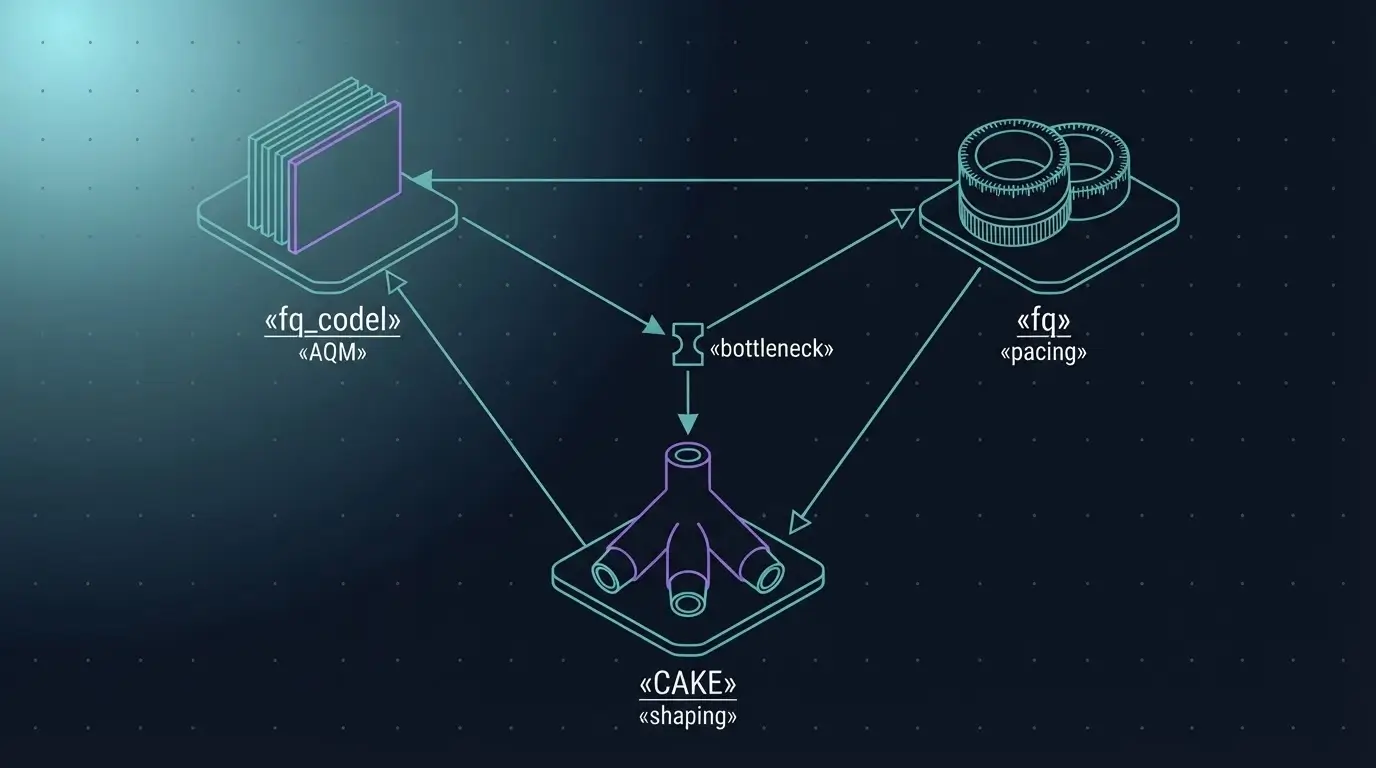
fq_codel — разумный canary, когда Linux контролирует bottleneck queue, flows конкурируют, а standing delay доказан. Он сочетает flow separation и AQM. При этом он не является полноценным bandwidth shaper: если реальная узкая точка находится дальше и буфер там глубокий, локальная очередь может оставаться пустой.
fq ориентирован на fair queueing и pacing локально сгенерированного traffic. Linux TCP может задавать departure time; для gateway, который в основном терминирует и заново создаёт соединения, это релевантно. Для чисто forwarded traffic socket-aware преимущества слабее, и используется fallback hash. Если симптом — burst локального sender без standing queue, fq может быть более точной гипотезой.
CAKE добавляет integrated shaper, isolation modes, Diffserv и overhead compensation. Он полезен, когда вы должны сформировать скорость немного ниже внешнего bottleneck, например канала с известной полосой. Но это большая operational surface: bandwidth, RTT profile, overhead, NAT awareness и ingress strategy должны соответствовать пути. autorate-ingress не умеет оценивать downstream links за собственной точкой наблюдения.
Default для production gateway остаётся скучным и правильным: не мигрировать без доказанной боли. Если baseline выдерживает SLO, новый qdisc создаёт ownership, persistence и on-call debt без подтверждённой выгоды. Сравнивайте механизмы, а не названия.
Для сравнения возможностей полезны upstream manuals tc-fq(8) и tc-cake(8). Они описывают разные механизмы, поэтому заменять один другим только по популярности неверно.
Когда проблема уже в границе контроля инфраструктуры
Иногда canary показывает реальный network control gap. На shared VM вы не управляете физической NIC, host qdisc, очередями гипервизора или upstream shaping; внутри гостя backlog может быть пустым, пока очередь растёт ниже. Тогда дополнительный sysctl или новый qdisc в guest не дают причинного рычага.
Сравнивайте варианты по ownership. VPS подходит, когда нужен быстрый изолированный gateway и предсказуемый guest baseline, а bottleneck контролируется внутри VM. Выделенный сервер оправдан, если нужны стабильные NIC queues, driver/firmware ownership, NUMA placement и воспроизводимый hardware profile. Managed edge снимает часть эксплуатации, но ограничивает низкоуровневую видимость и свободу эксперимента.
Коммерческий критерий здесь не «железо быстрее». Правильный вопрос: сможете ли вы наблюдать и менять тот слой, где доказана очередь, а затем откатить изменение в согласованное окно? Если проблема вызвана client read rate, proxy buffering, connection churn или GPU queue, новая платформа её не исправит. Сначала устраните disqualifier.
Для проверки гипотезы полезен отдельный canary на инфраструктуре с понятной границей контроля. KingServers может дать VPS или выделенный узел как воспроизводимый baseline, но решение о миграции стоит принимать только после A/B/A evidence bundle, а не по одному удачному графику.
Production rollout: persistence, observability и rollback
Успешный canary ещё не означает, что настройка переживёт reboot, смену interface name или пересоздание network namespace. Зафиксируйте owner конфигурации: systemd-networkd, NetworkManager, netplan, orchestration script или CNI. Не оставляйте одновременно несколько механизмов, которые соревнуются за root qdisc.
На multiqueue NIC проверьте root mq и все leaf queues после применения. Глобальный net.core.default_qdisc подходит для qdisc, не требующих параметров, но физический multiqueue обычно использует default на листьях, а virtual devices могут иметь noqueue. Документируйте фактический результат, а не только желаемый sysctl.
В мониторинг вынесите qdisc backlog/drops/ECN, interface drops, transport RTT/retransmissions и application metrics. Alert по ненулевому drop сам по себе создаст шум. Полезнее корреляция: backlog остаётся высоким несколько интервалов, tail latency растёт, а throughput или completion ухудшается. Так on-call видит механизм и ущерб одновременно.
Rollback должен быть симметричным: вернуть baseline qdisc, повторить ту же нагрузку на fresh connections и снять те же counters. Если эффект не исчез, причинность не подтверждена. Такой A/B/A тест иногда кажется избыточным, но именно он отделяет qdisc от случайного прогрева model cache, смены route или уменьшения фоновой передачи.
Поведение net.core.default_qdisc и исключения для multiqueue/virtual devices описаны в документации Linux kernel.
sysctl net.core.default_qdisc
ip -br link
tc -s -d qdisc show dev eth0

# For a multiqueue root, inspect every reported leaf and compare handles.
tc -j -s qdisc show dev eth0
Короткий incident runbook без магических параметров
Во время инцидента сначала подтвердите пользовательский симптом и ограничьте область: один регион, один gateway, один тип клиента или все flows. Затем найдите effective path проблемного соединения. Снимите qdisc/interface/transport counters в одном окне и сравните с healthy control. Не начинайте с target 1ms, увеличения limit или отключения ECN: без механизма это случайные изменения live dataplane.
Если standing queue доказана, выделите canary и примените defaults fq_codel. Повторите смесь нагрузки. Успех требует одновременно более короткой очереди, приемлемой утилизации и улучшения LLM outcome. Если tail latency снизилась ценой заметного падения полезного throughput, эксперимент не прошёл. Если drops выросли, но RTT и application SLO улучшились, это может быть нормальной работой AQM.
После положительного canary выполните rollback и убедитесь, что симптом возвращается на той же нагрузке. Затем снова примените изменение и расширяйте rollout ступенями. Для каждого шага храните before/after bundle, версию kernel/iproute2, topology и stop condition. При любом расхождении вернитесь к последнему доказанному состоянию.
Наконец, проверьте соседние owners. Queue relief может перенести bottleneck в TLS CPU, upstream proxy, egress link или GPU scheduler. Победа — не исчезновение одного красного графика, а устойчивый application SLO без скрытого ухудшения другого ресурса.
Нагрузочный профиль: как воспроизвести именно свой bufferbloat
Синтетический тест должен создавать ту же конкуренцию, что production, а не просто забивать линк одним потоком. Для LLM gateway соберите смесь: короткие ответы с чувствительным TTFT, длинные streaming responses, периодический bulk transfer артефакта и health traffic. Сохраняйте одинаковые prompt lengths, output limits и connection strategy между baseline и canary. Иначе изменение model workload замаскируется под сетевой эффект.
Разделите pre-first-byte и post-first-byte. Первый интервал включает admission, model scheduling, KV-cache и первый участок транспорта. После первого события измеряйте gaps между чанками. qdisc на egress логичнее связывать с post-first-byte паузами под передачей; рост TTFT без backlog чаще ведёт к другому owner. Это не абсолютное правило, а способ быстрее отсеять слабую гипотезу.
Нагрузка должна продолжаться достаточно долго, чтобы отличить burst от standing queue, но длительность задавайте относительно вашего RTT и рабочего паттерна, а не универсальным числом. Синхронизируйте timestamps gateway, load generator и observability. Затем пометьте фазы warm-up, steady state, overload и recovery: усреднение всех фаз в одну линию уничтожит причинность.
Не забывайте о направлении. Egress qdisc gateway управляет отправкой ответов клиенту, но не очередью входящих requests и не downstream buffer за внешним shaper. Для ingress shaping нужна отдельная схема, часто через IFB или edge-устройство; это уже другой риск и другой rollback. Если узкая точка находится у клиента, серверный fq_codel лишь увидит обратную связь транспорта.
Хороший тест заканчивается recovery-фазой. После снятия bulk traffic backlog должен уйти, RTT вернуться к baseline, а streaming gaps нормализоваться. Если очередь опустела, а приложение всё ещё медленно, bottleneck мигрировал или тест обнаружил второй фактор. Зафиксируйте его, прежде чем расширять rollout.
Частые ошибки, из-за которых canary лжёт
Ошибка 1 — сравнить разные paths. Baseline идёт через один load balancer, canary через другой, но результат приписывают qdisc. Зафиксируйте remote peer, route и termination point для каждого теста. Если путь различается, эксперимент проверяет сразу несколько гипотез.
Ошибка 2 — смешать старые и новые соединения. Long-lived SSE, WebSocket или gRPC stream сохраняет прежний peer и congestion state. После изменения распределения запускайте fresh connections с тем же request mix. Старые соединения можно наблюдать отдельно: их поведение важно для drain, но не подходит для чистого A/B.
Ошибка 3 — смотреть среднее. Bufferbloat проявляется в хвосте и у latency-sensitive flows рядом с bulk transfer. Средний RTT может почти не измениться. Сравнивайте p50, p95 и p99, межтокенные паузы, completion rate и полезный throughput. Один красивый percentile тоже недостаточен: сеть и приложение должны рассказать одну историю.
Ошибка 4 — тюнить target, interval и limit одновременно. Тогда невозможно понять, какой механизм дал эффект. Начните с defaults, меняйте один параметр за шаг и повторяйте rollback. interval связан с худшим RTT bottleneck, limit ограничивает очередь, а target задаёт приемлемую standing delay — это разные рычаги.
Ошибка 5 — принять локальный capture за wire truth. GSO/TSO могут показывать крупные skb до segmentation, а checksum offload — «ошибки», которых нет на wire. Для спорной картины снимите трафик на внешнем TAP/peer или временно спроектируйте canary capture с учётом offload. Не отключайте offload во всём fleet только ради более понятного tcpdump.
Ошибка 6 — забыть про memory envelope. Packet limit и memory limit применяются вместе, причём срабатывает более низкий фактический предел. На gateway с большим числом interfaces и namespaces суммарная память очередей важнее одного значения. Проверьте cgroup/RSS, socket buffers и qdisc memory в одном capacity budget.
Вывод: qdisc меняют после доказательства, а не по привычке
fq_codel полезен, когда Linux действительно владеет узкой egress-очередью, конкурирующие flows мешают друг другу, а standing delay виден одновременно в qdisc, транспорте и LLM streaming. Он не заменяет capacity planning, не исправляет slow consumer и не сокращает GPU compute time.
Начните с owner map и baseline, проведите canary на defaults, читайте drops как сигнал AQM, а не как автоматическую аварию. Сравнивайте fq_codel, fq и CAKE только после определения механизма. И обязательно завершите A/B/A rollback: если возврат baseline не возвращает симптом, история ещё не закончена.
Практический следующий шаг прост: выберите один проблемный gateway, соберите четырёхуровневый evidence bundle и прогоните репрезентативную смесь коротких и длинных flows. Если bottleneck окажется в слое, которым текущая площадка не позволяет управлять, тогда уже имеет смысл обсуждать отдельный VPS, dedicated edge или перенос termination point — с измеримым SLO и планом возврата.