Оглавление
- Быстрый вердикт: когда RX ring действительно виноват
- Где находится ring buffer в receive path
- Снимите baseline до любой настройки
- Как отличить hardware drop от softirq и socket bottleneck
- Свяжите RX queue, IRQ, softirq и NUMA
- Ring size и interrupt coalescing: меняйте по одному
- Проведите A/B/A canary с application outcome
- Сделайте настройку постоянной и не потеряйте rollback
- Когда проблема действительно требует другой платформы
- Короткий runbook инцидента с RX drops
- Вывод: ring buffer лечит доказанный burst, а не любой timeout
Готовы перейти на современную серверную инфраструктуру?
В King Servers мы предлагаем серверы как на AMD EPYC, так и на Intel Xeon, с гибкими конфигурациями под любые задачи — от виртуализации и веб-хостинга до S3-хранилищ и кластеров хранения данных.
- S3-совместимое хранилище для резервных копий
- Панель управления, API, масштабируемость
- Поддержку 24/7 и помощь в выборе конфигурации
Результат регистрации
...
Создайте аккаунт
Быстрая регистрация для доступа к инфраструктуре
Быстрый вердикт: когда RX ring действительно виноват
Увеличивать RX ring имеет смысл только после трёх совпавших сигналов: растёт driver-level счётчик потерь на нужной receive queue, рост совпадает по времени с нагрузочным burst, а приложение видит ошибки, ретрансляции или ухудшение TTFT. Если есть лишь высокий общий RX dropped, это ещё не диагноз. Счётчик мог накапливаться неделями, принадлежать виртуальному интерфейсу или отражать другой уровень стека.
Для LLM API gateway типичный false-green выглядит так: GPU utilization нормален, HTTP health-check зелёный, но новые streaming-соединения периодически начинают ответ с задержкой или обрываются. Команда увеличивает socket buffers, затем net.core.netdev_max_backlog, но пользовательский эффект не меняется. Причина может находиться раньше: аппаратный RX descriptor ring заполняется быстрее, чем драйвер и NAPI успевают его освобождать.
Обратная ситуация встречается не реже. NIC counters стоят на месте, зато одна CPU перегружена NET_RX, растёт time_squeeze, proxy медленно читает сокеты или inference backend держит очередь. Здесь большой ring только добавит глубины и скроет симптом на несколько секунд. Procurement default простой: не меняйте платформу и не заказывайте «NIC помощнее», пока не доказан bottleneck на конкретном hop.
Граница темы важна. Настройку RSS/RPS и IRQ affinity подробно разбирает отдельный runbook KingServers по сетевому CPU, а влияние GRO/GSO/TSO — материал по network offload. Здесь фокус уже: как доказать переполнение RX ring, провести один canary и подтвердить результат через application outcome.
Где находится ring buffer в receive path
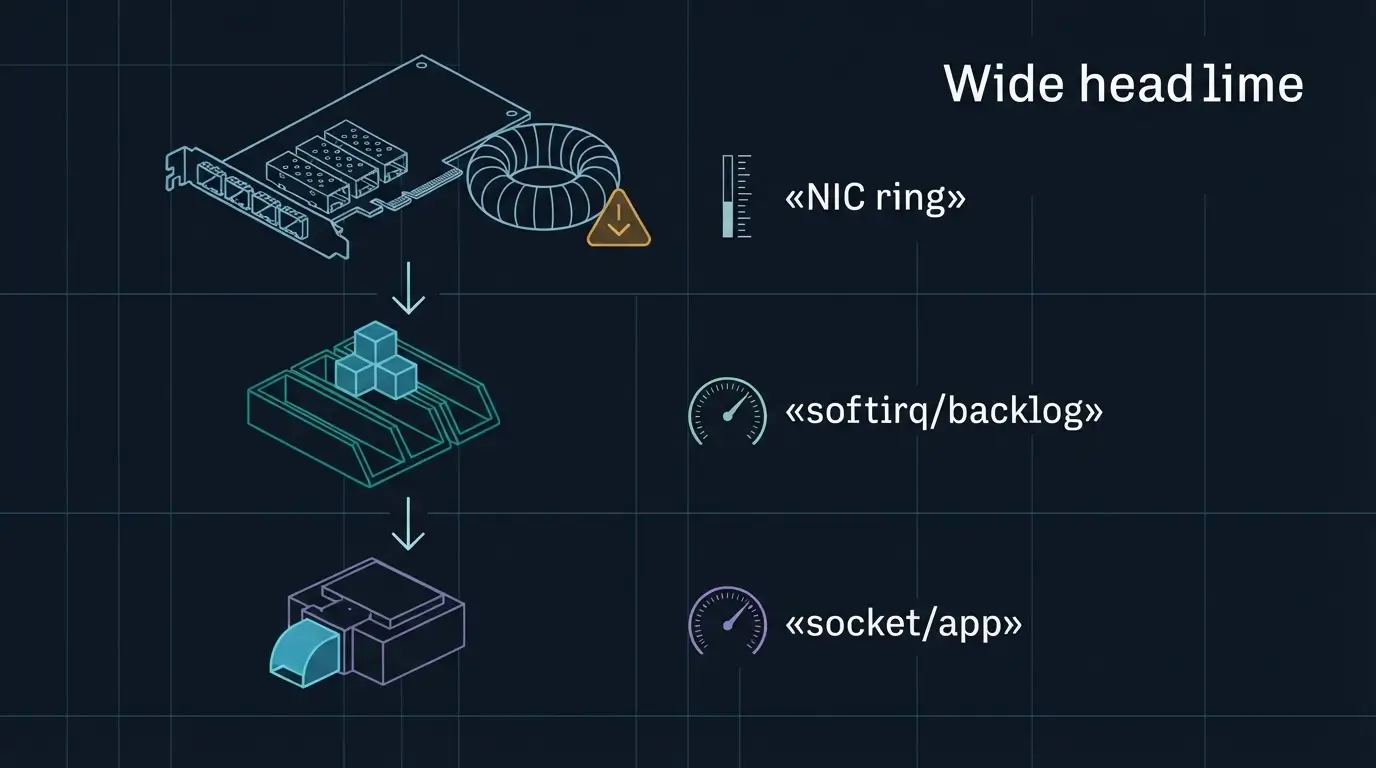
Пакет приходит в физическую NIC, карта размещает descriptor в RX ring и через interrupt сообщает драйверу о работе. NAPI poll забирает пакет, создаёт sk_buff и передаёт его выше: в softirq, IP/TCP, socket queue, proxy и наконец в процесс LLM gateway. Потеря на первом участке уже не видна приложению как «переполненный ring»; чаще она проявится таймаутом, TCP retransmission или новым соединением.
Официальная документация Red Hat описывает RX ring как общий круговой буфер NIC и драйвера: он хранит входящие пакеты, пока драйвер не обработает их через SoftIRQ. Это полезная модель, но реальная реализация зависит от драйвера, числа queues и режима устройства. Поэтому слово ring в выводе ethtool -g не следует смешивать с netdev_max_backlog, receive socket buffer или очередью запросов Envoy.
Представьте утренний burst после запуска batch-клиентов. NIC принимает десятки коротких TLS-соединений одновременно. Если CPU освобождает descriptors достаточно быстро, глубина ring почти не важна. Если один IRQ попал на занятый core, очередь заполняется и NIC начинает отбрасывать кадры ещё до TCP. Но если кадры прошли в kernel и застряли у медленного consumer, увеличение RX descriptors не решает причинную цепочку.
Для каждого инцидента рисуйте owner map: физический порт и driver, RX queue и IRQ, CPU/softirq, socket, proxy worker, backend connection и GPU queue. Переходите дальше только после доказательства предыдущего слоя. Такой порядок не самый эффектный, зато он не позволяет одному растущему counter стать универсальным объяснением.
Снимите baseline до любой настройки
Baseline нужен не как архив команд, а как синхронный снимок одной нагрузки. Запишите время в UTC, effective interface, network namespace, driver и firmware, текущие и максимальные ring parameters, channels, coalescing, offload и per-queue counters. Рядом сохраните application metrics: долю 5xx/499, connect errors, retransmissions, TTFT p50/p95/p99 и число активных streaming-соединений.
Не начинайте с фильтра по одному знакомому имени. Вывод ethtool -S driver-specific: у разных карт встречаются rx_missed_errors, rx_no_buffer_count, rx_queue_N_drops, rx_discards_phy и десятки близких полей. Снимите полный вывод дважды через контролируемый интервал, затем считайте delta. Абсолютное число после долгого uptime почти бесполезно.
На хосте с контейнерами сначала найдите реальный datapath. eth0 внутри pod может быть veth, а физическая очередь принадлежит ens5f0 на node. На bond или VLAN проверьте нижележащие устройства. На SR-IOV различайте PF и VF: возможность менять ring у VF и набор доступных counters зависят от драйвера и политики хоста.
DEV=ens5f0
date -u
ip -details link show dev "$DEV"
ethtool -i "$DEV"
ethtool -g "$DEV"
ethtool -l "$DEV"
ethtool -c "$DEV"
ethtool -k "$DEV"
ethtool -S "$DEV"
cat /proc/interrupts
cat /proc/net/softnet_statПовторите тот же набор на healthy-узле под сопоставимой нагрузкой. Это negative control: если одинаковый counter растёт и там без ухудшения API, он не объясняет инцидент. Если же рост локален для одной queue и совпадает с application failure, у вас появляется рабочая гипотеза.
Как отличить hardware drop от softirq и socket bottleneck
Первый evidence gate — driver/NIC. Ищите delta по queue-level drop, discard, missed или no_buffer counters и сверяйте семантику с документацией драйвера. На этом уровне важна корреляция с входящим packet rate и распределением по queues. Одна горячая queue при спокойных соседях чаще указывает на hash entropy, RSS indirection или single-flow hotspot, а не на слишком маленький ring всего интерфейса.
Второй gate — softirq/backlog. /proc/net/softnet_stat хранит данные по CPU; поля нужно декодировать с учётом версии ядра, а не читать как одну глобальную строку. Рост dropped или time_squeeze вместе с высокой %soft означает, что давление уже находится в software receive path. Тогда проверяйте IRQ placement, NAPI budget и backlog. Увеличение hardware ring может дать запас, но владелец ограничения останется CPU path.
Третий gate — socket/application. Если NIC и softirq стабильны, смотрите ss -tinm, proxy buffering, event-loop delay, worker saturation и backend queue. Особенно коварны длинные SSE-потоки: быстрый приём запроса не гарантирует быстрое чтение ответа клиентом. Для этого слоя полезен отдельный runbook по TCP buffers и backpressure.
Пример: у gateway растёт p99 TTFT, но driver drops равны нулю. softnet_stat показывает time_squeeze на CPU 14, где одновременно сидит IRQ горячей RX queue и TLS worker. Ring не виноват напрямую. Сначала разнесите ownership и повторите fresh-connection probe; только затем проверяйте глубину descriptors.
Свяжите RX queue, IRQ, softirq и NUMA
RX ring существует не в вакууме: каждая hardware queue обслуживается драйвером и обычно имеет связанный MSI-X interrupt. Linux kernel documentation рекомендует распределять receive interrupts между CPU и учитывать memory domain. Если queues меньше, чем cores, RPS может распределить дальнейшую обработку; если RSS уже даёт очередь на каждый нужный CPU, лишний RPS способен добавить IPI без пользы.
Сначала посмотрите ethtool -l, затем найдите IRQ нужного интерфейса в /proc/interrupts. Сравните configured и effective affinity. На системах с irqbalance ручная mask может быть изменена после старта сервиса или hotplug. На bare metal дополнительно сопоставьте PCI device с NUMA node и placement proxy workers. Удалённый memory access сам по себе не доказывает drop, но вместе с горячим core и queue imbalance делает гипотезу сильнее.
DEV=ens5f0
ethtool -l "$DEV"
ethtool -x "$DEV"
grep -i "$DEV" /proc/interrupts
for q in /sys/class/net/"$DEV"/queues/rx-*; do
  printf '%s rps=%s\n' "$q" "$(cat "$q/rps_cpus")"
done
devpath=$(readlink -f /sys/class/net/"$DEV"/device)
cat "$devpath/numa_node"
mpstat -P ALL 1Проверяйте эффект на новых соединениях. Existing keepalive и streaming sessions сохраняют прежний flow-to-queue mapping, поэтому мгновенное сравнение после изменения RSS может ложно показать «ничего не изменилось». Контрольный запрос должен открыть fresh TCP/TLS connection, пройти тем же маршрутом и получить содержательный ответ inference, а не только HTTP 200 от health endpoint.
Если после выравнивания queue/IRQ исчезли driver drops, не увеличивайте ring «для надёжности». Вы уже нашли owner. И наоборот, если locality здорова, CPU имеет запас, но bursts всё равно переполняют ring, canary большей глубины становится обоснованным.
Ring size и interrupt coalescing: меняйте по одному
ethtool -g DEV показывает current и pre-set maximums, а ethtool -G DEV rx N меняет число RX ring entries, если драйвер поддерживает операцию. Максимум — ограничение устройства, а не рекомендация. Больше descriptors дают запас на burst, но требуют памяти и могут увеличить время ожидания пакета в очереди. Для latency-sensitive LLM API важен не только throughput: следите за TTFT и tail latency.
Interrupt coalescing — соседний, но отдельный рычаг. Он определяет, как долго или сколько пакетов NIC ждёт перед interrupt. Более агрессивная агрегация снижает interrupt rate и CPU cost, но может увеличить latency; слишком частые interrupts перегружают CPU. Net DIM умеет динамически менять moderation по bandwidth, packets и events, причём алгоритм отдаёт приоритет bandwidth. Это значит, что автоматический профиль не обязан оптимизировать именно ваш p99 TTFT.
Нельзя одновременно увеличить ring, изменить rx-usecs, число channels и IRQ affinity: положительный результат станет неразбираемым, а откат — рискованным. Начните с одного изменения на одном узле. Если гипотеза про короткий burst, увеличьте RX ring на один разумный шаг между current и maximum, сохранив coalescing. Если bottleneck постоянный и CPU горячий, сначала чините queue distribution.
DEV=ens5f0

# Сохраните фактический baseline из ethtool -g.
ethtool -g "$DEV"
ethtool -c "$DEV"

# Пример canary; значение выбирают из current/max и возможностей драйвера.
sudo ethtool -G "$DEV" rx 1024

# После теста верните исходное значение, например 512.
sudo ethtool -G "$DEV" rx 512
ethtool -g "$DEV"Числа в примере не являются универсальным tuning profile. На вашей NIC current и maximum могут отличаться, а изменение способно кратко прервать связь. Официальный RHEL guide прямо предупреждает о возможном interruption при смене ring parameters. Поэтому выполняйте операцию через out-of-band доступ или на узле, который можно убрать из балансировки.
Проведите A/B/A canary с application outcome
Хороший canary отвечает не на вопрос «уменьшился ли counter», а на вопрос «исчез ли пользовательский симптом из-за этого изменения». Возьмите два одинаковых gateway: A остаётся baseline, B получает новый RX ring. Подайте сопоставимый traffic mix, включая короткие запросы, новые TLS handshakes и длинные streaming responses. Снимайте deltas counters, CPU/softirq, retransmissions, TTFT и error rate в одном временном окне.
Stop condition задают до запуска. Например: немедленный rollback при росте p99 TTFT, сбросе link, driver reset, новых errors или миграции bottleneck в socket/application queue. Не продолжайте тест только потому, что driver drops стали ниже: глубокая очередь может скрыть потери ценой задержки. Для LLM API это особенно неприятно, потому что пользователь воспринимает паузу до первого токена как отказ.
После положительного B верните старое значение A на том же узле и повторите workload. Если drops и application failure возвращаются, причинность становится намного убедительнее. Затем снова включите B и проверьте воспроизводимость. Этот A/B/A цикл защищает от случайного совпадения с уменьшившимся трафиком, прогревом caches или сменой backend pool.
Сохраните evidence bundle: timestamps, kernel и driver versions, interface/PCI identity, до/после ethtool -g/-c/-S, IRQ map, softnet deltas и application graphs. Такой пакет полезнее скриншота «ошибки пропали»: по нему другой инженер сможет повторить эксперимент или оспорить вывод.
Сделайте настройку постоянной и не потеряйте rollback
ethtool -G меняет runtime state. После reboot, driver reload, смены kernel, пересоздания VM или обновления firmware значение может вернуться к default. Способ persistence зависит от дистрибутива и владельца сети. В NetworkManager современные профили поддерживают ethtool ring properties; в RHEL официальный пример использует nmcli connection modify PROFILE ethtool.ring-rx N. В других системах применяют systemd unit или сетевой orchestrator, но он должен выполняться после появления интерфейса.
Не переносите значение между разными моделями NIC как «корпоративный стандарт». Устройства отличаются maximums, размером descriptors, количеством queues и driver behavior. Политика должна задавать условие и проверку: применить значение только к конкретным driver/device IDs, затем прочитать фактический state и поднять alert при несовпадении.
В Kubernetes node — такой же хост. DaemonSet с привилегиями может настроить NIC, но увеличивает blast radius и часто скрывает ownership. Для managed cluster часть physical settings недоступна; на SR-IOV поведение PF/VF разделено. Сначала договоритесь, кто отвечает за host networking, maintenance window и возврат node в pool. Не используйте pod lifecycle как механизм случайного изменения физической карты.
PROFILE="gateway-uplink"
DEV=ens5f0

nmcli connection modify "$PROFILE" ethtool.ring-rx 1024
nmcli connection up "$PROFILE"

# Проверка фактически применённого state
ethtool -g "$DEV"Rollback тоже должен быть persistent. Запишите исходное значение в change record и подготовьте обратную команду для того же механизма. Если canary требует ручного доступа после link flap, считайте это частью риска до rollout, а не неприятной деталью после него.
Когда проблема действительно требует другой платформы
Инфраструктурный upgrade оправдан, когда вы доказали control gap: текущая платформа не даёт нужных NIC queues, driver/firmware ownership, NUMA placement, telemetry или безопасного change window. В таком случае dedicated server может быть ценнее не «большей скоростью», а предсказуемым physical path и правом управлять параметрами. Для виртуального gateway важны гарантии провайдера по vNIC, CPU scheduling и наблюдаемости host-level drops.
Однако новое железо не исправляет poor RSS entropy, single-flow hotspot, неверную IRQ affinity, proxy buffering, retry storm или GPU queue. Если на wire и NIC всё чисто, коммерческий bridge нужно остановить: покупка ресурса без доказанного owner только переносит инцидент. По той же причине не смешивайте эту тему с защитой handshake path; для SYN backlog и cookies есть отдельный SYN runbook.
При сравнении VPS, dedicated и managed edge задайте пять вопросов: кто владеет NIC и firmware, кто видит per-queue counters, можно ли закреплять CPU/NUMA, как проходит maintenance, и насколько быстро выполняется rollback. Эти ответы формируют operational cost. «До 40 Гбит/с» без queue telemetry и воспроизводимого baseline не является доказательством пригодности для вашего LLM gateway.
Для KingServers-проекта разумный следующий шаг — принести evidence bundle, traffic profile и требуемую границу контроля. Тогда инфраструктуру можно сопоставить с нагрузкой предметно: оставить gateway на VPS, вынести network edge на dedicated node или разделить proxy и GPU inference по failure domains.
Короткий runbook инцидента с RX drops
Сначала зафиксируйте пользовательский симптом и временное окно. Затем определите effective interface и снимите deltas driver counters. Если они не растут, не трогайте ring: переходите к softirq, socket и application. Если растут, сопоставьте конкретную queue с IRQ и CPU, проверьте RSS distribution и healthy control.
Когда queue/CPU path здоров, сравните current и maximum ring. Подготовьте canary на одном выведенном из общего пула узле, меняйте только RX ring и возвращайте трафик постепенно. Оценивайте одновременно driver drops, softnet_stat, CPU, retransmissions, TTFT и ошибки gateway. Положительный результат обязан пережить A/B/A.
Если improvement есть только в counter, но приложение не меняется, откатите настройку и продолжайте поиск. Если улучшились и low-level state, и fresh-connection outcome, закрепите значение через host network management, задокументируйте device/driver boundary и добавьте drift check. Наконец, проверьте, не мигрировал ли bottleneck в TLS, proxy, backend connection pool или GPU scheduler.
Не используйте production traffic как единственный генератор истины. Сохраните небольшой воспроизводимый workload с тем же packet/connection shape. Throughput-only тест крупными потоками может не воспроизвести burst из коротких запросов, который и заполняет RX descriptors.
Вывод: ring buffer лечит доказанный burst, а не любой timeout
RX ring — нижний и очень конкретный слой receive path. Он становится виновником только тогда, когда per-queue driver counters, queue/IRQ evidence и application outcome складываются в одну временную цепочку. Без этой цепочки увеличение descriptors превращается в удобный ритуал: потери могут временно скрыться, а latency и operational debt вырастут.
Практический порядок короткий: снимите baseline, найдите owner, выровняйте queue-to-CPU path, измените один параметр на одном узле, выполните A/B/A и закрепите только воспроизводимый результат. Сохраните rollback рядом с persistence-конфигурацией. Для следующего maintenance window начните с десятиминутного сбора deltas — он часто экономит часы слепого tuning.
Если evidence показывает, что вам не хватает контроля над физической NIC, queues или NUMA, обсуждайте платформу через эти требования. Если же bottleneck находится в proxy или GPU queue, оставьте ring в покое и чините реального владельца. Так сеть перестаёт быть общим подозреваемым и становится измеряемой частью inference path.