Оглавление
- Быстрый verdict: когда подозревать MTU, а когда нет
- Почему WireGuard меняет допустимый размер пакета
- Соберите baseline до изменения MTU
- Gate 1: измерьте PMTU снаружи туннеля
- Gate 2: измерьте внутренний путь через wg0
- PMTUD black hole: проверьте ICMP, firewall и cloud ACL
- Исправление 1: задайте MTU осознанно
- Исправление 2: MSS clamp — страховка, а не замена PMTUD
- Linux tcp_mtu_probing: когда включать
- Canary rollout для private LLM API
- Production-чеклист: как не вернуть black hole через месяц
- Вывод: лечите путь, а не симптом
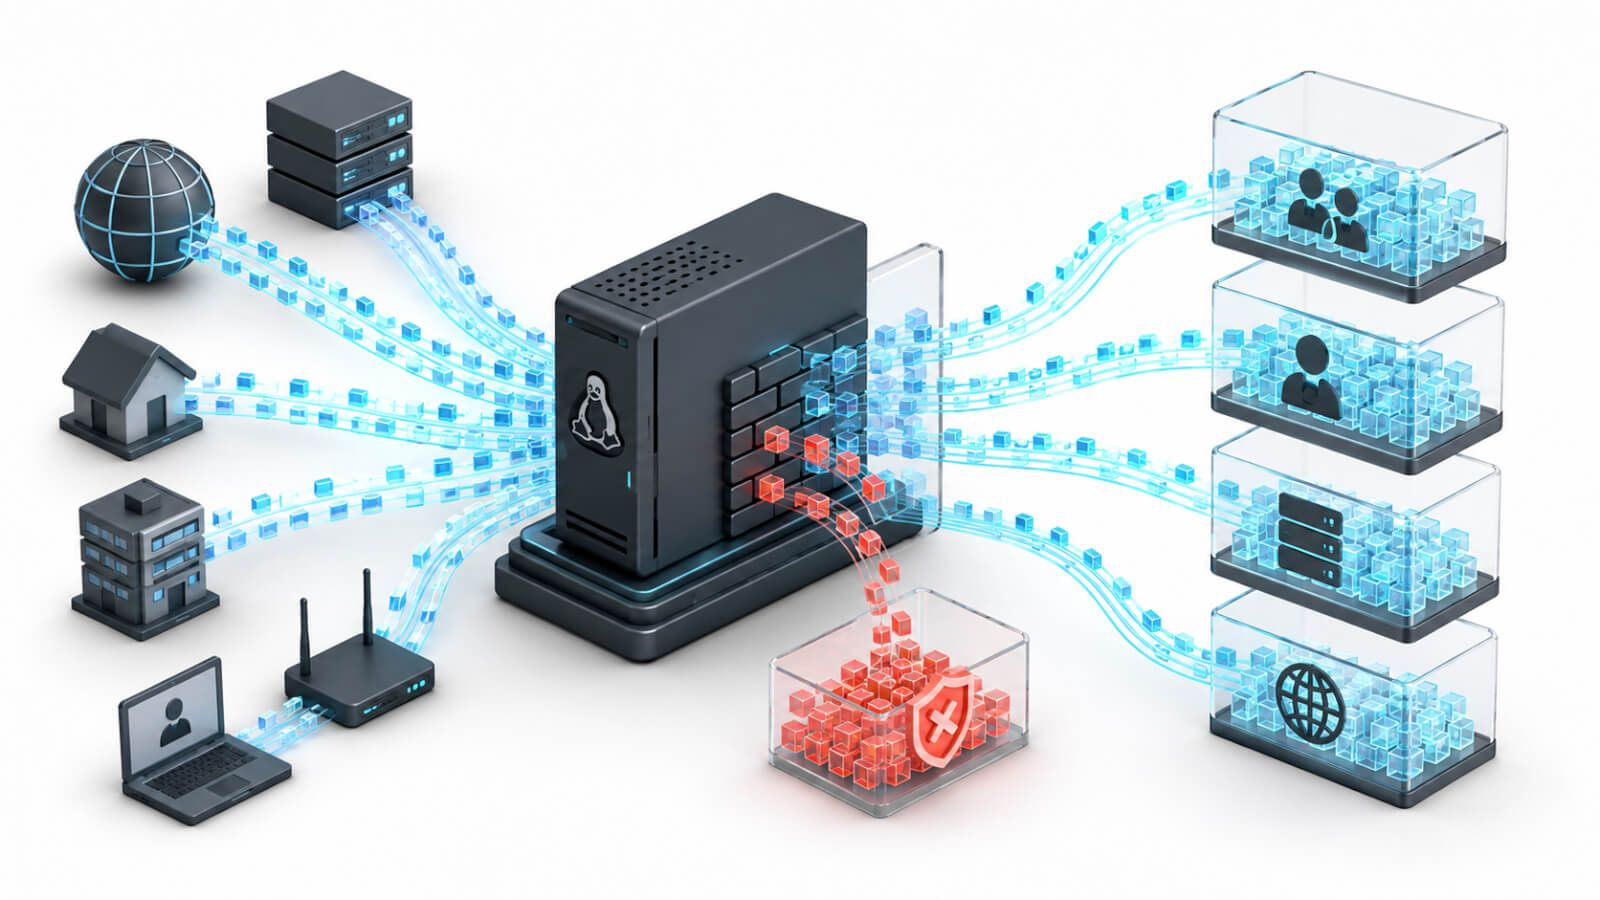
Healthcheck зелёный, WireGuard-handshake есть, короткий запрос к private LLM API проходит — а длинный streaming-ответ внезапно замирает после первых данных или вообще не доходит до клиента. В такой ситуации легко обвинить GPU, reverse proxy или сам inference-сервер, хотя проблема может находиться ниже: пакет помещается в локальный интерфейс, но не помещается в реальный path MTU после инкапсуляции WireGuard. Если ICMP, необходимый для Path MTU Discovery, где-то отфильтрован, получается классический PMTUD black hole: соединение устанавливается, а крупные пакеты исчезают без полезной обратной связи. Ниже — production-runbook, который отделяет MTU-проблему от похожих симптомов, измеряет underlay и tunnel отдельно, а затем выбирает минимальный фикс вместо случайного уменьшения MTU. Все изменения проверяем canary-трафиком и симметричным rollback, чтобы не превратить сетевой тюнинг в новую причину простоя.
Готовы перейти на современную серверную инфраструктуру?
В King Servers мы предлагаем серверы как на AMD EPYC, так и на Intel Xeon, с гибкими конфигурациями под любые задачи — от виртуализации и веб-хостинга до S3-хранилищ и кластеров хранения данных.
- S3-совместимое хранилище для резервных копий
- Панель управления, API, масштабируемость
- Поддержку 24/7 и помощь в выборе конфигурации
Результат регистрации
...
Создайте аккаунт
Быстрая регистрация для доступа к инфраструктуре
Быстрый verdict: когда подозревать MTU, а когда нет
MTU стоит проверять не потому, что «VPN иногда тормозит», а когда симптом зависит от размера данных. Типичный профиль: ICMP echo маленького размера проходит, TCP handshake завершается, TLS устанавливается, короткий JSON-ответ приходит, но передача заметно более крупного ответа или длинного SSE-потока останавливается. Ещё один сильный сигнал — один и тот же сервис стабилен напрямую, но воспроизводимо ломается через WireGuard или через конкретный site-to-site маршрут.
Для private LLM API это коварно: первый токен может прийти, а затем поток начинает висеть, потому что сетевой стек собрал более крупный сегмент или на пути появился пакет, который уже не помещается после внешней инкапсуляции. Но сам факт высокого TTFT ничего не доказывает. Если задержка одинаково воспроизводится вне VPN, GPU загружен, очередь запросов растёт или inference endpoint возвращает те же паузы по локальному интерфейсу, MTU — слабая гипотеза. Сначала отделите network-path symptom от application symptom.
То же относится к протоколу. MSS clamp влияет на TCP SYN и не исправляет произвольный UDP/QUIC path. Если проблема проявляется только в QUIC, исследуйте UDP PMTU и ICMP отдельно. Если же ломается TCP-трафик через VPN, у вас есть четыре независимых доказательства: underlay PMTU, effective MTU wg0, видимость ICMP «слишком большой пакет» и application canary. Пока хотя бы одно из них не измерено, не меняйте MTU по совету из чужой конфигурации.
Если вы только выбираете VPN-механизм, сначала полезно свериться с материалом «Какой VPN-протокол выбрать?». Здесь задача уже другая: WireGuard выбран и работает, но нужно доказать, почему конкретный production path теряет крупные пакеты.
Почему WireGuard меняет допустимый размер пакета
У интерфейса wg0 есть собственный MTU, но физически пакет едет не «внутри wg0». WireGuard берёт внутренний IP-пакет, шифрует его и отправляет через UDP поверх внешнего маршрута. Значит, внутренний пакет обязан оставить место для внешней оболочки. Если underlay действительно допускает 1500 байт, безопасный tunnel MTU будет ниже; если в underlay уже есть PPPoE, VXLAN, GRE, второй VPN или облачный overlay, реальный запас может оказаться ещё меньше.
Современный wg-quick умеет автоматически выбирать MTU, если параметр не задан. В текущем Linux-скрипте wg-quick выбор опирается на MTU маршрута до endpoint и затем оставляет консервативный запас; это хорошая отправная точка, но не доказательство end-to-end PMTU. Маршрут до endpoint на локальном хосте может выглядеть как 1500, а узкое место находиться дальше — у провайдера, в туннеле поверх туннеля или на асимметричном обратном пути.
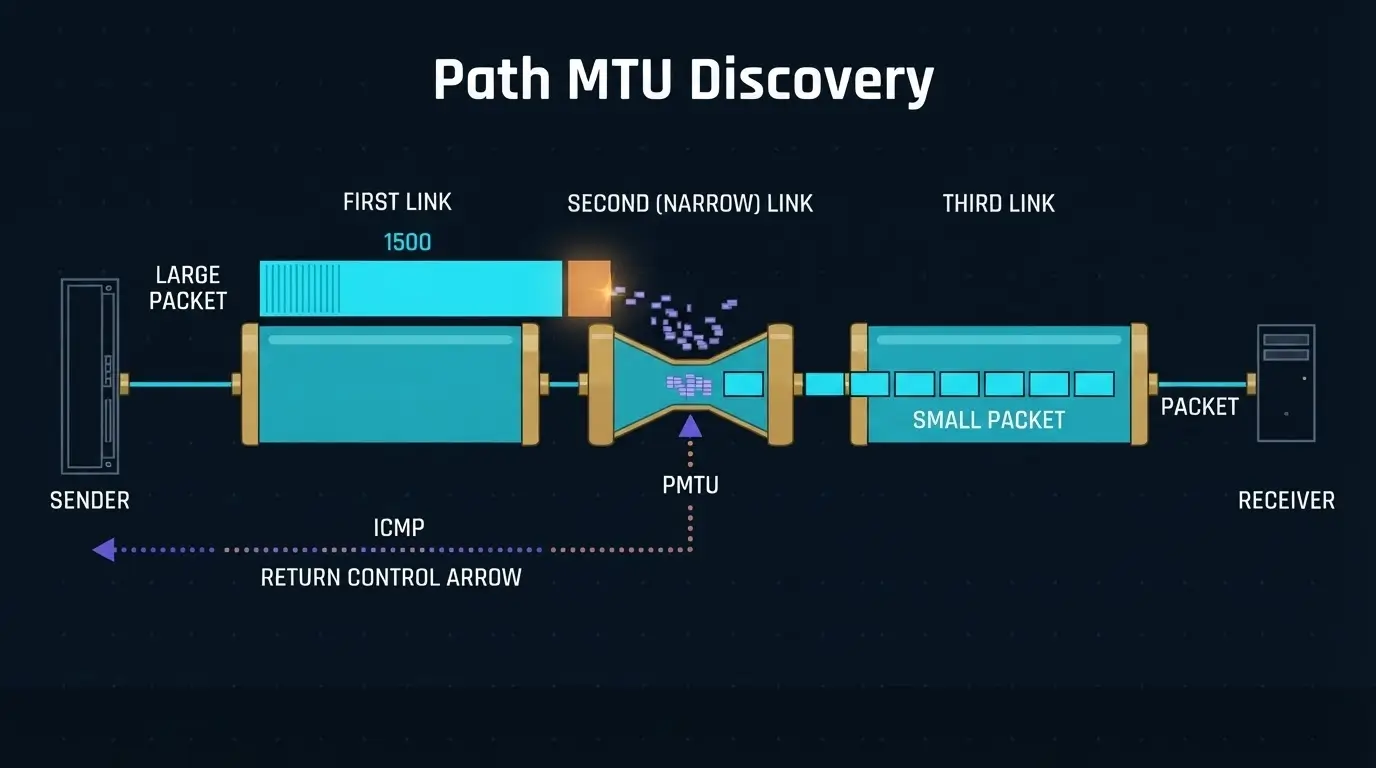
Поэтому полезно держать в голове два числа. Interface MTU — что локальный интерфейс согласен принять для отправки. Path MTU — максимальный пакет, который реально пройдёт весь путь без фрагментации там, где она недопустима или нежелательна. PMTUD нужен именно для второго числа. Если обратная служебная информация не возвращается к отправителю, локальная настройка может выглядеть корректно, а приложение будет зависать на определённом размере трафика.
Практический disqualifier: если wg0 уже существенно меньше измеренного PMTU, но симптом не меняется при контролируемом уменьшении payload и одинаково виден на прямом маршруте, не продолжайте «резать MTU». Ищите L7 timeout, proxy buffering, перегрузку inference или иной bottleneck. Для архитектуры между площадками полезно держать рядом runbook по WireGuard site-to-site: там рассматривается топология и маршрутизация, а здесь — конкретная граница размера пакета.
Соберите baseline до изменения MTU
Сетевой тюнинг без baseline быстро превращается в гадание. До первого ip link set сохраните topology evidence: MTU интерфейсов, endpoint WireGuard, реальный маршрут до endpoint, маршрут до внутреннего peer и состояние TCP-соединения. Особенно важно записать, где находится фактический sender для проблемного потока. Если TLS завершается на reverse proxy, именно proxy может отправлять большие TCP-сегменты клиенту; если L4 passthrough сохраняет соединение до inference-сервера, граница другая.
Этот шаг защищает от типичной ошибки: MTU меняют на GPU-сервере, хотя узкий путь находится между VPN-gateway и клиентом. Для LLM streaming разделяйте pre-first-byte и post-first-byte. Если connection/TLS/TTFT проходят, а stall начинается уже после первого байта, сетевой hypothesis сильнее. Если первый байт не появляется вообще, сначала проверьте admission, upstream connect и timeout reverse proxy. Сравнение Nginx, Caddy и Traefik и их operational trade-offs есть в отдельном материале про reverse proxy.
Снимайте baseline на обеих сторонах туннеля. В production полезно прикрепить вывод команд к incident ticket: через час после временного фикса он будет ценнее памяти инженера о том, «кажется, там было 1500». Не публикуйте в тикете private keys: для диагностики достаточно peer endpoint, маршрутов, MTU и счётчиков.
ip -br link show
ip link show dev wg0
wg show wg0
ip route get
ip route get
ss -ti dst В выводе ss -ti смотрите не на одну «магическую» цифру, а на контекст: retransmissions, negotiated MSS и динамику соединения во время воспроизведения. Один snapshot не доказывает PMTU black hole, но помогает связать сетевой механизм с реальным application stall.
Gate 1: измерьте PMTU снаружи туннеля
Первый gate — underlay, то есть путь от WireGuard endpoint до WireGuard endpoint без внутреннего трафика. tracepath умеет оценивать PMTU по пути, а ping с режимом -M do позволяет отправлять IPv4 probe с DF и менять размер полезной нагрузки. Не превращайте 1472 в универсальную константу: это лишь удобный тест гипотезы о 1500-байтовом IPv4 path, потому что к payload добавляются заголовки IPv4 и ICMP.
Начните с ожидаемого верхнего значения, затем уменьшайте payload до устойчиво проходящего размера. Повторите тест с другой стороны: асимметричный маршрут способен дать разные результаты. Для IPv6 PMTUD является обязательной частью модели передачи: маршрутизатор не фрагментирует пакет за отправителя, а сообщает о слишком большом пакете через ICMPv6 Packet Too Big. Базовая логика описана в RFC 8201; для IPv4 классическое описание PMTUD — RFC 1191.
tracepath -4
ping -4 -M do -c 3 -s 1472
ping -4 -M do -c 3 -s 1400

tracepath -6
ping -6 -M do -c 3 -s 1452 Если 1472 не проходит, а 1400 стабилен, это ещё не повод поставить MTU 1400 везде. Вы доказали только наличие границы между этими значениями. Найдите устойчивый PMTU, учтите внешнюю инкапсуляцию WireGuard и только потом выбирайте MTU wg0. Если tracepath показывает одно, а реальный TCP flow ведёт себя иначе, проверьте policy routing, ECMP и тот ли destination вы измеряете.
Gate 2: измерьте внутренний путь через wg0
Следующий gate проверяет уже внутренний пакет. Сначала прочитайте effective MTU интерфейса wg0, затем вычислите максимальный ICMP payload, который должен помещаться внутрь этого MTU. Для IPv4 из MTU вычитаются заголовки IP и ICMP; для IPv6 заголовок IP больше. Эти расчёты нужны не для «тюнинга по формуле», а чтобы probe совпал с фактическим интерфейсным лимитом.
WG_MTU=$(cat /sys/class/net/wg0/mtu)
V4_PAYLOAD=$((WG_MTU - 28))
V6_PAYLOAD=$((WG_MTU - 48))

ping -4 -I wg0 -M do -c 3 -s "$V4_PAYLOAD"
ping -6 -I wg0 -M do -c 3 -s "$V6_PAYLOAD" Положительный результат означает только то, что этот probe проходит. Обязателен отрицательный контроль: увеличьте payload на несколько байт в отдельном тесте и убедитесь, что граница вообще наблюдаема, либо используйте меньший размер, чтобы увидеть, что symptom исчезает. Если любой размер внутри wg0 теряется, проблема может быть не MTU: проверьте AllowedIPs, routing, firewall и peer state.
На production-пути не стоит генерировать агрессивный flood. Нескольких повторяемых probe достаточно, а дальше нужен application canary. Цель — связать механизм с пользовательским симптомом: уменьшение внутреннего packet size должно менять сетевой результат, а корректный MTU — восстанавливать тот же LLM stream без изменения модели, proxy timeouts и GPU-параметров.
PMTUD black hole: проверьте ICMP, firewall и cloud ACL
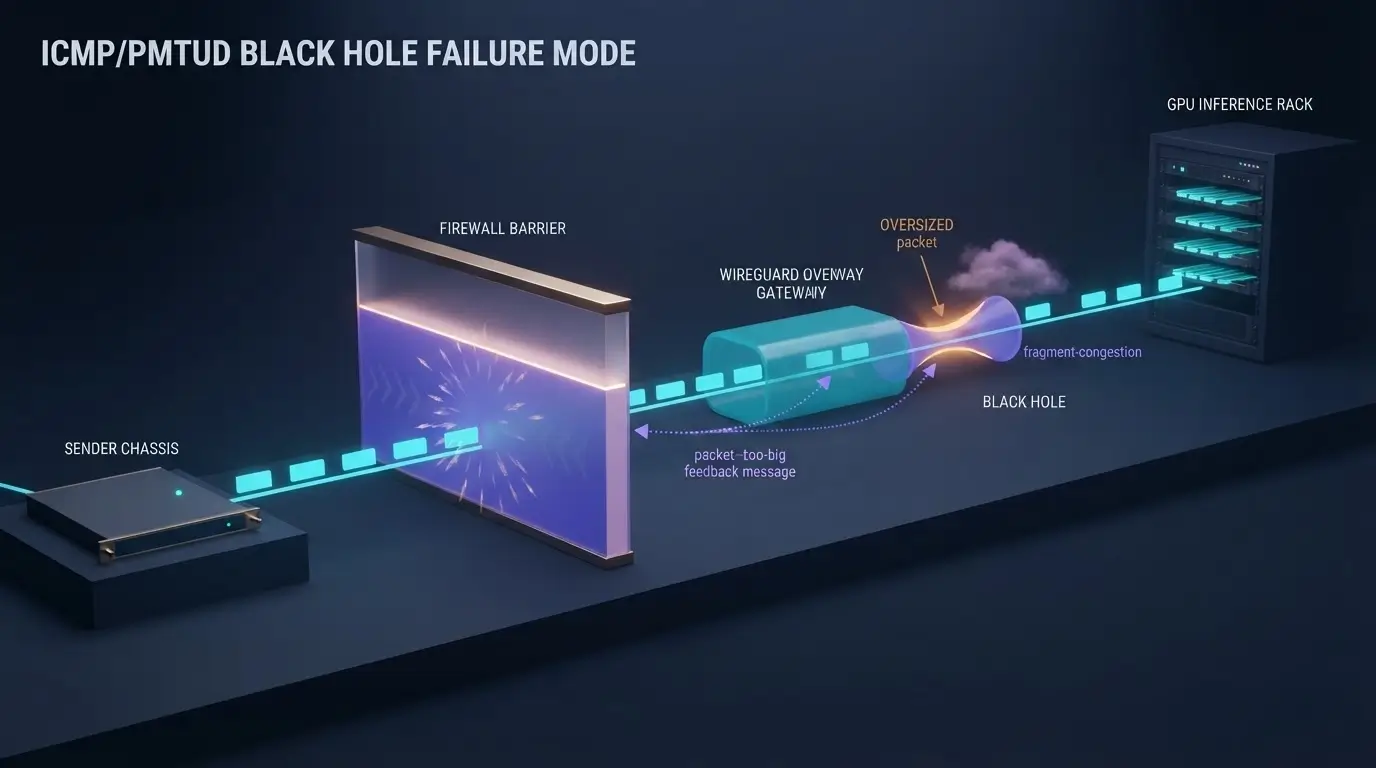
PMTUD black hole возникает, когда отправитель посылает слишком большой пакет, промежуточный узел не может его передать как есть, но служебное сообщение о проблеме не доходит обратно. Именно поэтому соединение может казаться «почти рабочим»: handshake и маленькие сегменты проходят, а более крупная передача застывает. Этот класс проблем описан ещё в RFC 2923, и он по-прежнему встречается в современных overlay-сетях.
Проверяйте не правило «ICMP разрешён вообще», а конкретный путь и конкретный тип сообщения. На Linux capture на обеих сторонах часто быстрее любого чтения firewall-конфига: вы увидите, появляется ли ICMP/ICMPv6 на одном интерфейсе и исчезает ли на другом. Одновременно посмотрите counters wg0. Если ошибка возникает до шифрования, картина будет отличаться от ситуации, когда outer UDP дошёл до удалённого endpoint, но обратный control path пропал.
tcpdump -ni any 'icmp or icmp6'
nft list ruleset
ip -s link show dev wg0В облачной или распределённой сети проверьте все policy layers: host firewall, security group/ACL, edge firewall, DDoS-политику и промежуточный VPN/router. Опасная практика — «для безопасности запретить весь ICMP». ICMP не является одним бесполезным ping-протоколом; часть сообщений нужна сетевому стеку для корректной работы path discovery. Если политика требует фильтрации, разрешайте необходимые типы осознанно и документируйте владельца правила.
Отрицательный контроль здесь очень полезен: временно воспроизведите тот же запрос по path, где PMTUD feedback заведомо доходит. Если проблема исчезает без изменения LLM stack, вы локализовали слой. Если не исчезает — не расширяйте firewall «на всякий случай».
Исправление 1: задайте MTU осознанно
Если underlay gate доказал меньший PMTU, а tunnel probe воспроизводит границу, самый прямой фикс — снизить MTU wg0 так, чтобы внутренний пакет гарантированно помещался во внешний path. Не копируйте 1420, 1380 или 1280 из форума: эти числа могут быть правильными для чужой топологии и неверными для вашей. Сначала получите собственный PMTU, затем оставьте консервативный запас под WireGuard outer transport и проверьте оба направления.
Текущий Linux wg-quick при автоматическом выборе MTU резервирует 80 байт относительно найденного underlay MTU. Эту логику удобно использовать как ориентир при диагностике, особенно когда endpoint может идти по IPv6. Но если вы вручную измерили реальный end-to-end PMTU, применяйте рассчитанное значение как canary, а не как мгновенный глобальный rollout.
# Пример: 1460 здесь — измеренный ВАМИ underlay PMTU, а не универсальное число
UNDERLAY_PMTU=1460
WG_MTU=$((UNDERLAY_PMTU - 80))

ip link set dev wg0 mtu "$WG_MTU"
ip link show dev wg0После успешного canary закрепите проверенное целое значение через MTU = ... в конфигурации wg-quick и отдельно протестируйте restart. Не полагайтесь на временный runtime state: после reboot он исчезнет. Сохраните старое значение как rollback target и повторите те же probes после отката. Если application SLO не возвращается к baseline при возврате старого MTU, причинность не доказана.
Слишком маленький MTU тоже имеет цену: больше пакетов и выше packet-processing overhead. Цель — не «сделать поменьше, чтобы наверняка», а найти наибольшее устойчивое значение для вашего пути с достаточным запасом под реальную инкапсуляцию. В инфраструктуре с несколькими локациями полезно держать profile по каждому path вместо одного глобального числа.
Исправление 2: MSS clamp — страховка, а не замена PMTUD
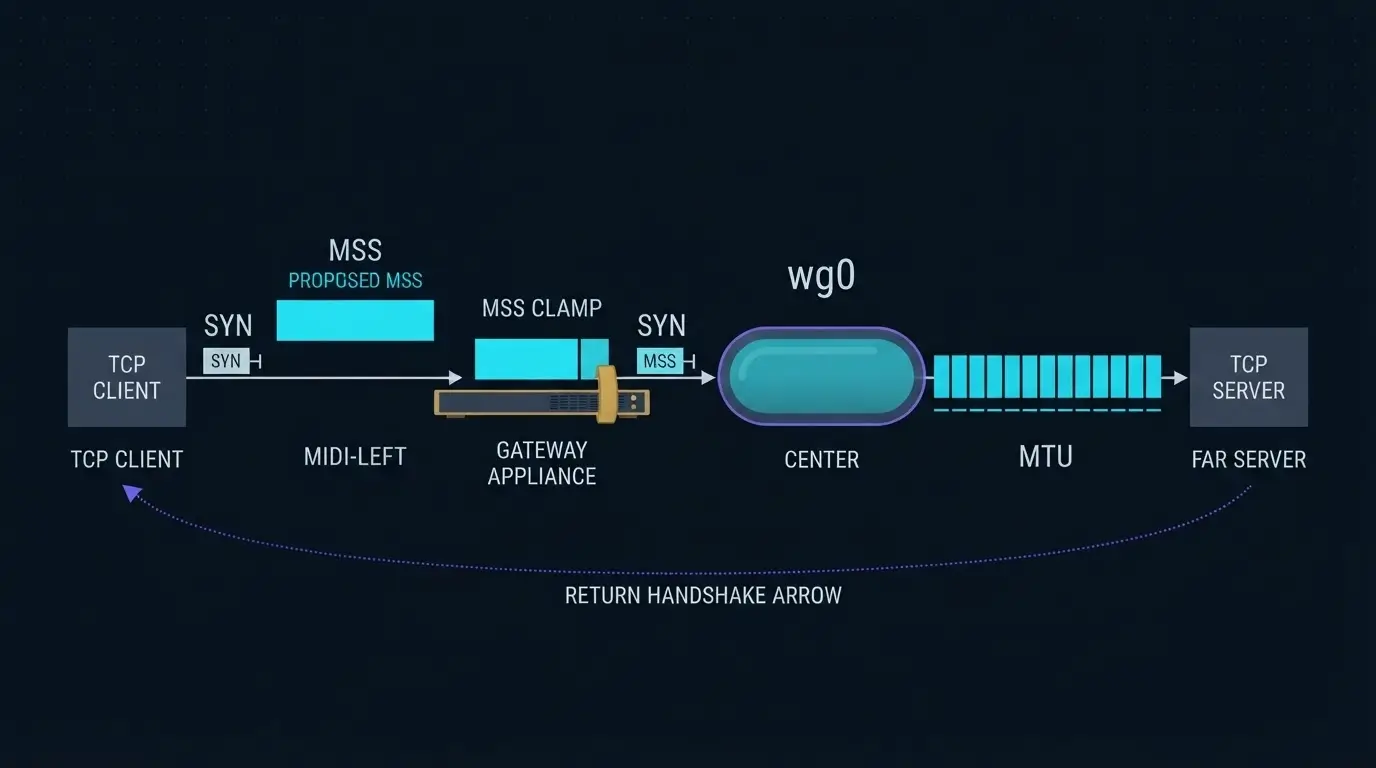
MSS clamping уменьшает Maximum Segment Size, который TCP стороны объявляют в SYN. Это позволяет с самого начала формировать сегменты, лучше соответствующие path MTU. При VPN и старых сетях метод полезен, когда вы контролируете gateway, а корректный ICMP feedback невозможно гарантировать. Но важно понимать границу: MSS существует только в TCP. UDP, QUIC и уже установленные соединения не получают волшебного исправления.
В nftables route MTU можно использовать как источник для корректировки MSS. Пример ниже предполагает, что таблица и chain уже существуют; в вашей системе имя таблицы, family и hook могут отличаться. Проверьте правило через тестовую конфигурацию и убедитесь, что оно применяется к SYN в нужных направлениях.
nft add rule ip filter forward tcp flags syn tcp option maxseg size set rt mtu
nft add rule ip6 filter forward tcp flags syn tcp option maxseg size set rt mtuЕсли используется iptables-совместимый стек, цель TCPMSS с --clamp-mss-to-pmtu решает похожую задачу; man page прямо описывает её как workaround для «браузер подключается, затем висит» при сломанном PMTUD. Но у route-based clamp есть caveat: асимметричный forward/reverse path способен иметь разные MTU. Поэтому после правила всё равно нужны captures и application tests, а не только отсутствие retransmission на одном соединении.
Правильная последовательность такая: сначала починить PMTUD там, где вы владеете сетью; затем применять MSS clamp как documented compatibility layer для TCP-path, который вы не можете полностью контролировать. Если clamp внезапно «лечит всё», это ещё один сигнал вернуться и найти потерянный ICMP feedback.
Linux tcp_mtu_probing: когда включать
Linux умеет включать TCP MTU probing при обнаружении ICMP black hole. Актуальная документация kernel для net.ipv4.tcp_mtu_probing описывает три режима: 0 — выключено, 1 — включать probing при обнаружении black hole, 2 — всегда использовать probing с начального базового MSS. Для production-разбора разумно начинать с текущего значения и, если механизм действительно нужен, тестировать режим 1 как ограниченную страховку, а не сразу включать 2 глобально.
sysctl net.ipv4.tcp_mtu_probing

# Временный canary: включать probing при обнаружении black hole
sysctl -w net.ipv4.tcp_mtu_probing=1

# Rollback
sysctl -w net.ipv4.tcp_mtu_probing=0Документация ядра: IP sysctl — tcp_mtu_probing. Важно: этот sysctl не «чинит WireGuard». Он меняет поведение TCP stack, когда обнаруживается проблема с packet size. Если root cause — заблокированный ICMP, неправильный MTU интерфейса или дополнительный overlay, инфраструктурный дефект остаётся.
Проверяйте effective state на том же host/process path, который обслуживает трафик. В контейнеризированной среде отдельно убедитесь, какой network namespace формирует TCP connection и на каком узле применён sysctl. После canary повторите тот же запрос и тот же packet-size test. Если улучшения нет, откатите параметр и не оставляйте глобальный sysctl «на всякий случай».
Canary rollout для private LLM API
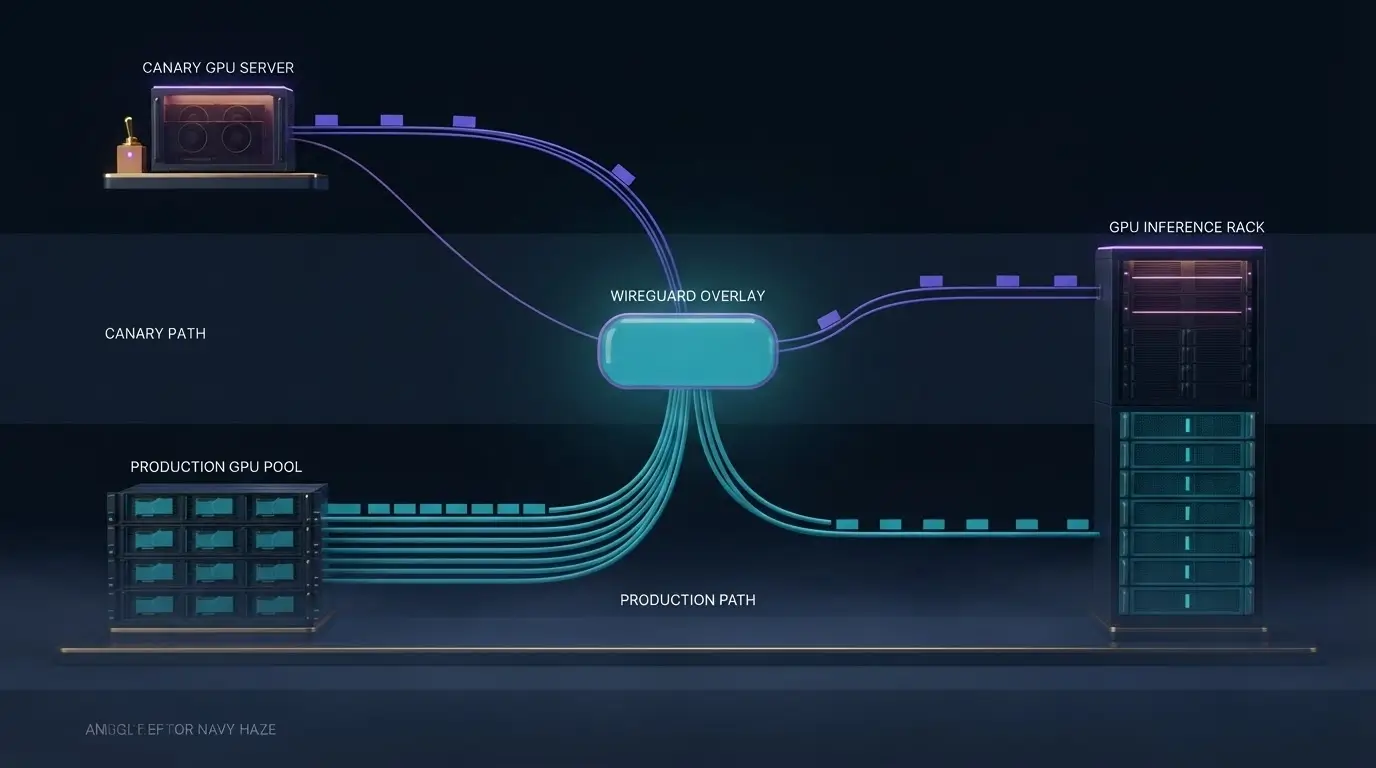
Сетевой фикс считается готовым не тогда, когда ping прошёл, а когда application outcome восстановлен. Для private LLM API соберите один воспроизводимый запрос с достаточно длинным streaming-ответом и прогоняйте его по одному и тому же маршруту до и после изменения. Одновременно наблюдайте TCP/ICMP и метрики proxy. Не меняйте модель, prompt, timeout и MTU в одном эксперименте: иначе вы не узнаете, что именно помогло.
Если API построен как внутренний аналог OpenAI-compatible endpoint, полезно заранее разделить access path, gateway и inference pool; архитектурный контекст есть в материале про Private AI API на своих серверах. Здесь нас интересует только один canary route. На первом шаге направьте через новый MTU профиль малую долю клиентов или отдельный peer, затем сравните completion success, stream stalls, retransmissions и жалобы на timeout с baseline.
curl -N --http1.1 https:///v1/chat/completions \
  -H 'Content-Type: application/json' \
  -H "Authorization: Bearer $LLM_TOKEN" \
-d @request.json --http1.1 здесь нужен не как рекомендация навсегда, а как способ зафиксировать protocol variant для эксперимента. Если production использует HTTP/2, повторите canary отдельно через HTTP/2 и сравните. Секрет не вставляйте прямо в shell history: используйте переменную окружения или безопасный secret injection.
Stop condition должна быть определена заранее: рост ошибок, потеря connectivity peer, ухудшение latency или новый класс stall — немедленный rollback к прежнему MTU/sysctl/rule. После успешного canary перезапустите туннель или узел в контролируемом окне и повторите те же gates. Это проверяет не только runtime tweak, но и то, что конфигурация переживает lifecycle.
Production-чеклист: как не вернуть black hole через месяц
MTU-инциденты часто возвращаются после изменения внешнего маршрута, миграции в другой ЦОД или добавления ещё одного overlay. Поэтому фикс должен стать частью network profile, а не знанием одного инженера. Зафиксируйте, какой underlay PMTU измерен для каждой пары локаций, какой MTU выставлен на WireGuard и почему, где допускается MSS clamp и какой мониторинг должен сработать при повторном symptom.
- Ownership: кто владеет wg0, firewall и provider ticket, если PMTU меняется вне вашей зоны.
- Evidence: сохранённые tracepath/ping results и дата измерения.
- Config: MTU закреплён в deployment/config management, а не только runtime-командой.
- Negative control: direct path без VPN и заведомо небольшой payload остаются частью incident playbook.
- Application probe: длинный LLM streaming-request запускается после сетевых изменений.
- Rollback: старое значение MTU и правила firewall можно вернуть одним контролируемым change.
Если инфраструктура распределена между офисом, облаком и dedicated-серверами, MTU следует рассматривать как свойство конкретного path class. Один peer может идти напрямую по 1500-byte Ethernet, другой — через provider overlay, третий — через дополнительный IPsec. Одна глобальная константа для всех туннелей удобна только на бумаге.
Коммерческий смысл выделенного узла здесь не в обещании «меньшего ping», а в границе контроля. На dedicated/VPS, где вы управляете WireGuard endpoint, firewall, routing и change window, проще воспроизвести baseline, выполнить canary и откатить изменение. Если endpoint или middlebox находится у внешнего владельца, заранее включите его в runbook — иначе network ownership будет выясняться уже во время инцидента.
Вывод: лечите путь, а не симптом
WireGuard MTU problem становится управляемой, когда вы перестаёте начинать с числа «1420» и строите цепочку доказательств. Сначала подтвердите, что symptom зависит от размера трафика и действительно появляется на VPN-path. Затем измерьте PMTU внешнего маршрута, отдельно проверьте внутренний путь через wg0, убедитесь, что ICMP/Packet Too Big не теряется, и только после этого выбирайте MTU, MSS clamp или TCP probing.
Для private LLM API финальный gate всегда application-level: тот же streaming-request должен стабильно завершаться после изменения и снова воспроизводить старое поведение при контролируемом rollback, если вы хотите доказать причинность. Ping и tracepath объясняют механизм, но пользовательский поток доказывает результат.
Если ваш WireGuard path проходит через несколько провайдеров, overlay или площадок, сохраните этот runbook как повторяемый checklist и прогоняйте его после сетевых миграций. А если нужен отдельный VPS, dedicated gateway или GPU-инфраструктура, где можно зафиксировать network profile и провести canary без воздействия на весь production, начинайте с небольшого воспроизводимого контура — он даст больше информации, чем очередной глобальный sysctl.