Оглавление
- Короткий ответ: TCP PLB нужен не каждому gateway
- Как работает TCP PLB и где заканчивается его зона ответственности
- Сначала докажите path-specific congestion, а не общий timeout
- Проверьте prerequisites от switch до congestion-control
- Разберите параметры PLB до изменения значений
- Запустите A/B/A canary с одним owner и одинаковой нагрузкой
- Докажите rehash на wire и свяжите его с LLM outcome
- Failure modes, инфраструктурная граница и rollback
- Production checklist перед расширением rollout
- Вывод: PLB — точечный control для доказанного ECMP hotspot
Готовы перейти на современную серверную инфраструктуру?
В King Servers мы предлагаем серверы как на AMD EPYC, так и на Intel Xeon, с гибкими конфигурациями под любые задачи — от виртуализации и веб-хостинга до S3-хранилищ и кластеров хранения данных.
- S3-совместимое хранилище для резервных копий
- Панель управления, API, масштабируемость
- Поддержку 24/7 и помощь в выборе конфигурации
Результат регистрации
...
Создайте аккаунт
Быстрая регистрация для доступа к инфраструктуре
Короткий ответ: TCP PLB нужен не каждому gateway
TCP Protective Load Balancing имеет смысл, когда один длительный TCP-поток LLM API попал на перегруженный путь внутри IPv6 ECMP/WCMP fabric, а остальные равнозначные пути здоровы. Обычный ECMP уже сделал выбор по хешу и продолжает держать соединение на неудачном next hop. PLB использует накопленный congestion signal, меняет txhash и IPv6 Flow Label, после чего сеть может выбрать другой путь для того же соединения.
Но default здесь строгий: не включать PLB, пока не доказан path-specific hotspot. Если растёт TTFT из-за очереди inference, gateway упирается в CPU, клиент читает SSE медленно или proxy буферизует ответ, смена ECMP-пути не устранит причину. Сначала отделите сетевой hop от application queue, иначе получится аккуратная настройка не того слоя.
Qualifying condition выглядит так: один и тот же класс запросов на одинаковых gateway-узлах даёт разные ECN, retransmission и RTT-профили; paired capture связывает различие с конкретным fabric path; backend load и GPU queue при этом сопоставимы. Только после этого PLB становится кандидатом для canary.
Материал дополняет разбор Linux ECMP resilient nexthop: там речь о стабильности bucket mapping при изменении состава next hops, здесь — о sender-side repath существующего TCP-соединения по сигналу устойчивой перегрузки. Это разные механизмы и разные поисковые задачи.
Как работает TCP PLB и где заканчивается его зона ответственности
Поддержка TCP PLB появилась в Linux 6.2. Актуальная документация Linux IP sysctl фиксирует четыре ограничения. Функция выключена по умолчанию; congestion-control должен поддерживать PLB, и в документации приведён DCTCP; transport должен получать пригодную оценку congestion, например из ECN; текущая реализация меняет IPv6 Flow Label и для обычного IPv4 header является no-op.
Цепочка короткая, но каждый её элемент обязателен. Switch маркирует перегрузку ECN, DCTCP формирует оценку доли маркированных пакетов, PLB считает последовательные congested rounds и вызывает rehash. Новый Flow Label влияет на ECMP/WCMP hash только если поле участвует в политике коммутатора. Если fabric хеширует лишь фиксированный 5-tuple или outer tunnel header не меняется, sysctl может быть включён без фактического repath.
При отсутствии packets in flight PLB может сменить путь после меньшего числа congested rounds: риск reordering ниже. Forced rehash во время активной передачи ждёт дольше, потому что пакеты старого и нового пути могут прийти не по порядку. После RTO механизм временно приостанавливает repath, чтобы не метаться в сторону настоящего black hole.
Изменение Flow Label подтверждает механизм, но не пользовательский результат. Итоговый gate — TTFT, межтокенные паузы, completion rate и cancellation на свежих контролируемых запросах. Проверяли ли вы, что ECN виден именно sender-side gateway, а не только на switch telemetry?
uname -r
sysctl net.ipv4.tcp_plb_enabled
sysctl net.ipv4.tcp_plb_idle_rehash_rounds
sysctl net.ipv4.tcp_plb_rehash_rounds
sysctl net.ipv4.tcp_plb_suspend_rto_sec
sysctl net.ipv4.tcp_plb_cong_thresh
sysctl net.ipv4.tcp_congestion_control
sysctl net.ipv4.tcp_available_congestion_control
sysctl net.ipv4.tcp_ecn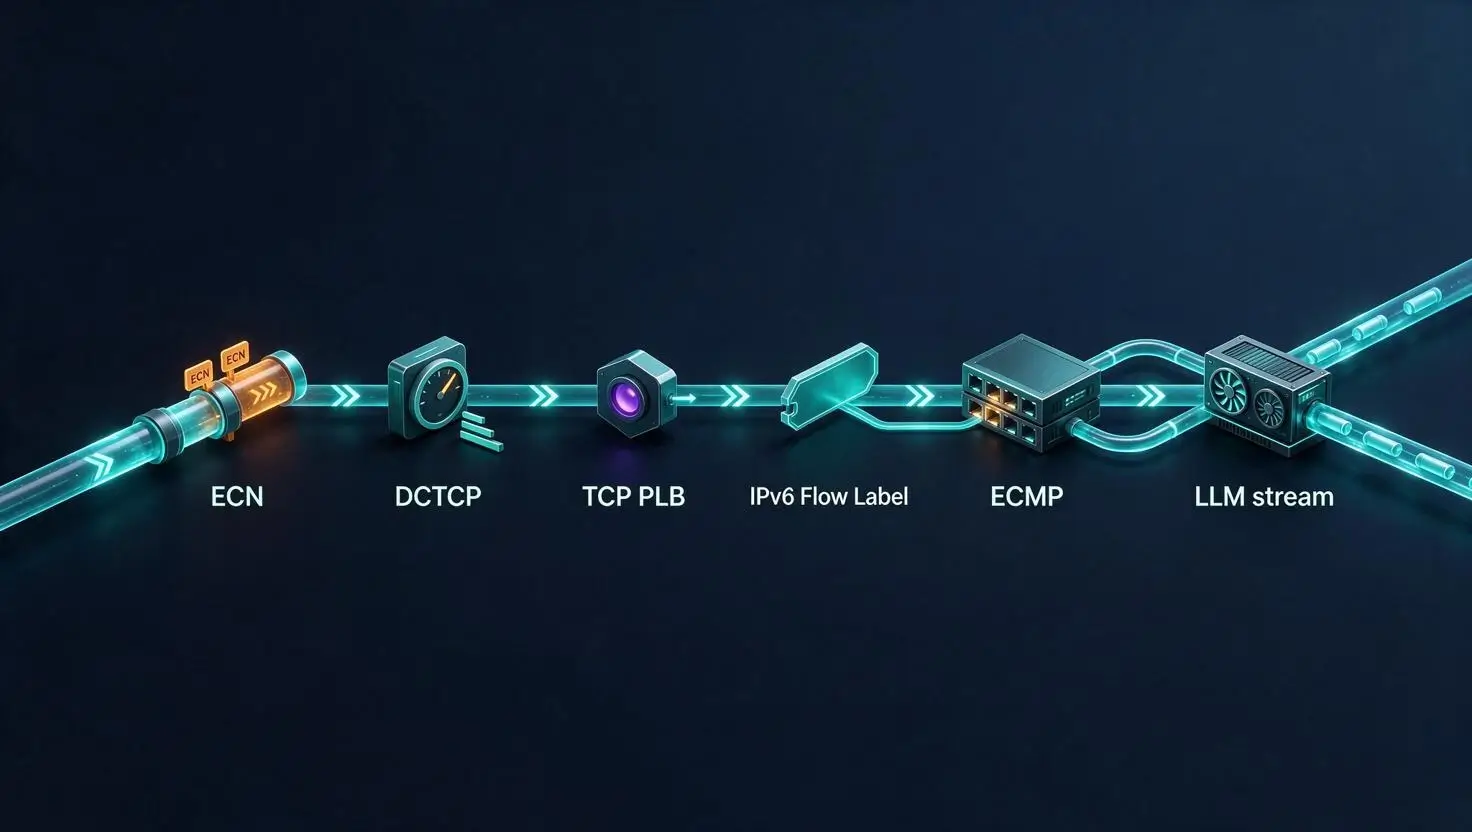
Сначала докажите path-specific congestion, а не общий timeout
Начните с одной проблемной сессии и одного healthy control. Запишите effective network namespace, локальный и удалённый IPv6-адреса, порт, route lookup, интерфейс и termination point. Для LLM gateway это критично: клиентское соединение может завершаться на внешнем load balancer, а TCP-плечо до inference backend создаёт proxy. PLB на backend hop не изменит client-facing path и наоборот.
Разделите четыре evidence gate. Path: какой next hop и Flow Label реально уходят в fabric. Transport: RTT, retransmissions, delivery rate, ECN negotiation и DCTCP state на конкретном socket. Wire: видят ли paired capture одинаковые потери и CE marks до и после предполагаемого bottleneck. Application: как ведут себя TTFT, pauses, завершение stream и cancellation для того же prompt class.
Абсолютный счётчик ничего не доказывает. Возьмите delta за одинаковое окно и нормализуйте по завершённым запросам, байтам или токенам. Сравните suspected path и healthy path при сопоставимой backend queue. Если ECN растёт у всех путей, PLB лишь перераспределит перегрузку.
Если ECN нет, а есть локальные RX drops, сначала используйте runbook по NIC ring buffers и RX drops. Если capture чистый, а softnet и per-queue counters указывают на CPU pressure, нужен анализ RSS, RPS и IRQ affinity, не PLB.
ip -6 route get 2001:db8:42::20 from 2001:db8:10::15
ss -tin dst '[2001:db8:42::20]'
ip -s link show dev eth0
nstat -az | grep -E 'Tcp|Ip6|ECN|PLB'
ethtool -S eth0 | grep -Ei 'drop|miss|timeout|ecn'Проверьте prerequisites от switch до congestion-control
PLB — не отдельный балансировщик, который включается одной строкой. Это последняя ступень цепочки signal → decision → path change. Switch должен маркировать congestion, а не только дропать пакеты. ECN должен сохраниться через tunnel и middleboxes. На sender работает congestion-control, экспортирующий PLB-совместимый congestion measure. Наконец, ECMP policy обязана учитывать изменяемый IPv6 Flow Label.
Наличие sysctl подтверждает интерфейс, но не поддержку вашим congestion-control или fabric. Linux documentation на дату запуска описывает DCTCP как пример поддерживаемого алгоритма. Не переносите синтаксис из experimental tree: сверяйте документацию установленного kernel package и vendor backports.
Для Kubernetes или containerized gateway повторите чтение внутри effective netns. Настройка root namespace может не совпасть с namespace, где создаётся socket. Если TLS завершается в sidecar, owner outgoing TCP socket — sidecar, а не приложение. Вопрос «где включить PLB?» решается по socket owner.
Отдельный disqualifier — IPv4-only fabric. Документация говорит: смена sk_txhash отражается на IPv6 Flow Label, но для IPv4 header это no-op. Encapsulation или дополнительные host/switch изменения требуют отдельного дизайна и проверки; это не автоматическая функция Linux sysctl.
Разберите параметры PLB до изменения значений
tcp_plb_enabled открывает возможность PLB; default — disabled. tcp_plb_cong_thresh задаёт долю marked packets за RTT в шкале 0–256. Значение 128 соответствует половине пакетов. Ноль означает repath каждый RTT независимо от congestion и в документации оставлен только для экспериментов.
tcp_plb_idle_rehash_rounds — число последовательных congested rounds перед rehash, когда packets in flight отсутствуют; default 3. tcp_plb_rehash_rounds — порог forced rehash во время активной передачи; default 12. Малое значение повышает риск retransmissions из-за reordering. Для SSE forced branch может встречаться чаще, чем для коротких запросов с idle gaps.
tcp_plb_suspend_rto_sec задаёт базовое время приостановки PLB после RTO; фактическая пауза рандомизируется между 1x и 2x, чтобы connections не rehash одновременно. Default 60 секунд. Подбирайте значение по времени ремонта failed link, а не по желаемой скорости реакции.
Хороший canary начинает с vendor defaults. Меняйте один owner за раз: сначала enable при неизменных порогах, затем при необходимости один параметр. Для изменения заранее запишите stop condition: рост out-of-order или retransmission, отсутствие path change, ухудшение completion либо миграция bottleneck в gateway CPU или GPU queue.
Запустите A/B/A canary с одним owner и одинаковой нагрузкой
Не включайте PLB сразу на всём gateway pool. Выделите один узел или netns, который получает малую, но репрезентативную долю streaming requests. Baseline и canary должны иметь одинаковые kernel build, NIC/driver, ECMP policy, congestion-control, backend pool и prompt class.
Сначала A: PLB выключен. Зафиксируйте route, Flow Label distribution, ECN/DCTCP signal, retransmissions, RTT, TTFT, межтокенные паузы, completion и cancellation. Затем B: включите PLB с default parameters только в canary namespace. Не меняйте routing weights и proxy timeout. Наконец A: верните исходное значение и повторите probes на свежих connections.
Держите две когорты: long-lived streams, переживающие congestion window, и новые requests после этапа. Старый keepalive может скрыть изменение listener, а новый socket — потерять исследуемый hotspot. Обе картины нужны вместе.
Если baseline stream попал на leaf-2 и получает CE marks, canary rehash перевёл его на leaf-3, TTFT уже произошёл до события. PLB может улучшить post-first-byte pauses, но не прошлый TTFT. Измеряйте lifecycle по фазам, как в материале про HTTP/3 для AI API.
BASE=$(sysctl -n net.ipv4.tcp_plb_enabled)
printf 'baseline_tcp_plb_enabled=%s
' "$BASE"
sysctl -w net.ipv4.tcp_plb_enabled=1
# После окна B:
sysctl -w net.ipv4.tcp_plb_enabled="$BASE"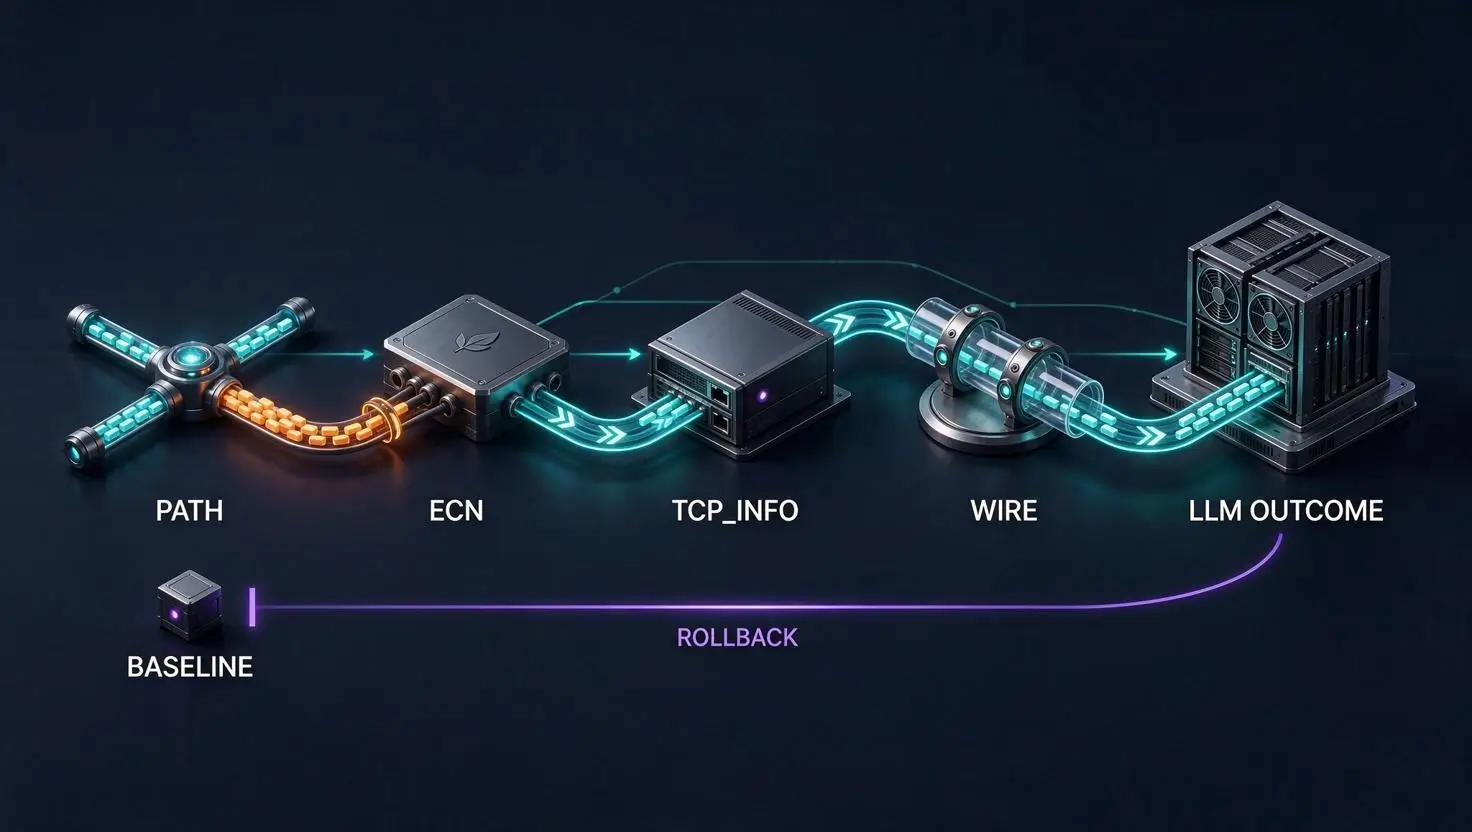
Докажите rehash на wire и свяжите его с LLM outcome
Успешный sysctl -w не означает, что соединение сменило путь. Сравните TCP_INFO и SNMP counters до и после congestion window. Patch series добавил PLB rehash telemetry, но отображение в ss, nstat или exporter зависит от user space и vendor build. Если поле не выводится, не подменяйте его общим retrans counter.
На wire нужен paired capture. Снимайте исходящий IPv6 header на gateway и fabric egress points. Изменение Flow Label без перехода на другой next hop означает, что ECMP policy не использует поле или outer encapsulation скрывает его. Переход без улучшения CE/retransmission указывает на fabric-wide congestion.
Разделите application outcome на pre-first-byte и post-first-byte. PLB, сработавший в середине stream, скорее влияет на pauses, goodput и completion, чем на прошедший TTFT. Короткий запрос может завершиться раньше, чем наберётся нужное число congested rounds: это mismatch workload и control.
Healthy-path negative control не должен часто rehash после enable. Если начинает, вероятны низкий threshold, шумный ECN signal или общий fabric pressure. Canary надо остановить даже при красивом среднем latency: механизм создаёт churn без точной причины.
nstat -az | grep -Ei 'PLB|ECN|Retrans'
ss -tin dst '[2001:db8:42::20]'
tcpdump -ni eth0 -vv 'ip6 and tcp and host 2001:db8:42::20'
Failure modes, инфраструктурная граница и rollback
Первый failure mode — «enabled, но ничего не произошло». Причины идут по цепочке: congestion-control не поддерживает PLB, ECN не согласован, CE marks теряются, threshold не достигнут, трафик IPv4-only, ECMP hash игнорирует Flow Label или tunnel выбирает path по неизменному outer header. Идите слева направо; уменьшение rounds лишь добавит reordering.
Второй — rehash есть, но стало хуже. Новый путь может иметь больший RTT, а пакеты старого и нового пути приходят вперемешку. Stop condition — рост retransmission или out-of-order вместе с ухудшением pauses либо completion. Верните tcp_plb_enabled=0 в canary netns и повторите path, transport, wire и application probes.
Третий — средние метрики улучшились, но streams обрываются. Проверьте proxy idle timeout, cancellation propagation, drain и retry policy. PLB не создаёт безопасный mid-stream retry и не переносит application state. Четвёртый — bottleneck мигрировал в TLS/softirq, admission или GPU memory. Rollout продолжают только при сохранённом SLO и понятном новом owner.
PLB не аргумент автоматически покупать сервер. VPS достаточен, если есть нужный kernel profile и наблюдаемость fabric. Выделенный gateway оправдан, когда нужны versioned kernel/NIC baseline, собственное окно drain/reboot, paired capture и согласованная ECN/ECMP policy. Ценность — контроль и rollback, не обещание скорости. Общую схему сверяйте с руководством по Private AI API.
Production checklist перед расширением rollout
Перед расширением canary соберите evidence bundle, который другой инженер проверит без устных пояснений: kernel и user-space versions, effective sysctl, congestion-control, ECN negotiation, topology и ECMP policy, route/Flow Label captures, per-socket transport deltas и application metrics. Добавьте время шагов и идентификатор change window.
Сохраните negative controls. Healthy path не должен часто rehash. IPv4 flow не является доказательством PLB. Запрос с искусственно высокой GPU queue должен показать, что PLB не исправляет application bottleneck. Forbidden control защищает от красивой корреляции.
Rollout делите ступенями: один netns, один gateway, небольшой pool, весь failure domain. Между ступенями выдерживайте окно для длинных streams и типичного congestion episode. Не увеличивайте долю только потому, что в спокойный час не было ошибок.
Назначьте owners: Linux/networking отвечает за socket и sysctl, fabric team — за ECN/ECMP, gateway team — за stream lifecycle, inference team — за GPU queue. Если A/B/A не воспроизводится после возврата baseline, причинность не доказана и rollout следует остановить.
Вывод: PLB — точечный control для доказанного ECMP hotspot
TCP PLB полезен в узкой ситуации: длительный IPv6 TCP stream LLM API закреплён за перегруженным ECMP-путём, sender получает качественный congestion signal, а fabric умеет выбрать другой next hop после смены Flow Label. В остальных случаях механизм либо не сработает, либо перенесёт внимание мимо настоящей очереди.
Правильный порядок не начинается с sysctl. Сначала effective path и socket owner, затем ECN/DCTCP signal, rehash telemetry и paired capture, после этого — TTFT, pauses, completion и cancellation. Canary меняет одного owner и заканчивается симметричным A/B/A rollback. Только совместный PASS transport и application gates оправдывает rollout.
Следующий шаг: возьмите один проблемный stream, соберите baseline командами из статьи и заполните canary checklist. Если для проверки не хватает контроля над kernel, NIC или fabric policy, сформулируйте controls как требования к VPS или выделенному gateway. Так решение останется проверяемым и обратимым.