Оглавление
- Быстрый verdict: flowtable нужен не каждому gateway
- Как flowtable меняет путь пакета
- Сначала зафиксируйте effective path и baseline
- Безопасная конфигурация software flowtable
- Как доказать, что offload работает и приносит пользу
- Исключения fast path: NAT, MTU, fragments и закрытие TCP
- A/B/A rollout без потери наблюдаемости
- Software и hardware offload: где проходит граница инфраструктуры
- Частые ошибки диагностики
- Production-чеклист владельца gateway
- Вывод: ускоряйте доказанный hop, а не архитектуру на глаз
Готовы перейти на современную серверную инфраструктуру?
В King Servers мы предлагаем серверы как на AMD EPYC, так и на Intel Xeon, с гибкими конфигурациями под любые задачи — от виртуализации и веб-хостинга до S3-хранилищ и кластеров хранения данных.
- S3-совместимое хранилище для резервных копий
- Панель управления, API, масштабируемость
- Поддержку 24/7 и помощь в выборе конфигурации
Результат регистрации
...
Создайте аккаунт
Быстрая регистрация для доступа к инфраструктуре
Быстрый verdict: flowtable нужен не каждому gateway
Короткий ответ: включать nftables flowtable имеет смысл только на Linux-хосте, который действительно маршрутизирует заметный объём TCP или UDP между интерфейсами и тратит измеримый CPU на classic forwarding path. Если TLS завершается на этом же хосте, запрос попадает в локальный Envoy или Nginx, а затем уходит к GPU через другой сокет, offload не обойдёт userspace и не сократит время генерации модели. Он ускоряет конкретный L3/L4 hop, а не весь LLM request.
Типичный false green выглядит убедительно: после изменения загрузка одного ядра падает, а команда conntrack -L показывает [OFFLOAD]. Но p95 time-to-first-token остаётся прежним, streaming продолжает замирать, а очередь inference растёт. В таком случае сетевой fast path сработал технически, однако пользовательская проблема жила в TLS, buffering, retry storm или GPU scheduler. Для production это не успех, а перенос внимания.
Начинайте с procurement default: не меняйте платформу и не включайте hardware offload, пока не доказан bottleneck на routed path. Shared VM, VPS и dedicated gateway различаются контролем NIC, kernel, driver и change window, но ни один вариант не исправит неверный route, MTU black hole или медленного клиента. Если вы ещё не локализовали сетевой CPU, сначала полезнее пройти runbook по RSS, RPS и IRQ affinity.
Как flowtable меняет путь пакета
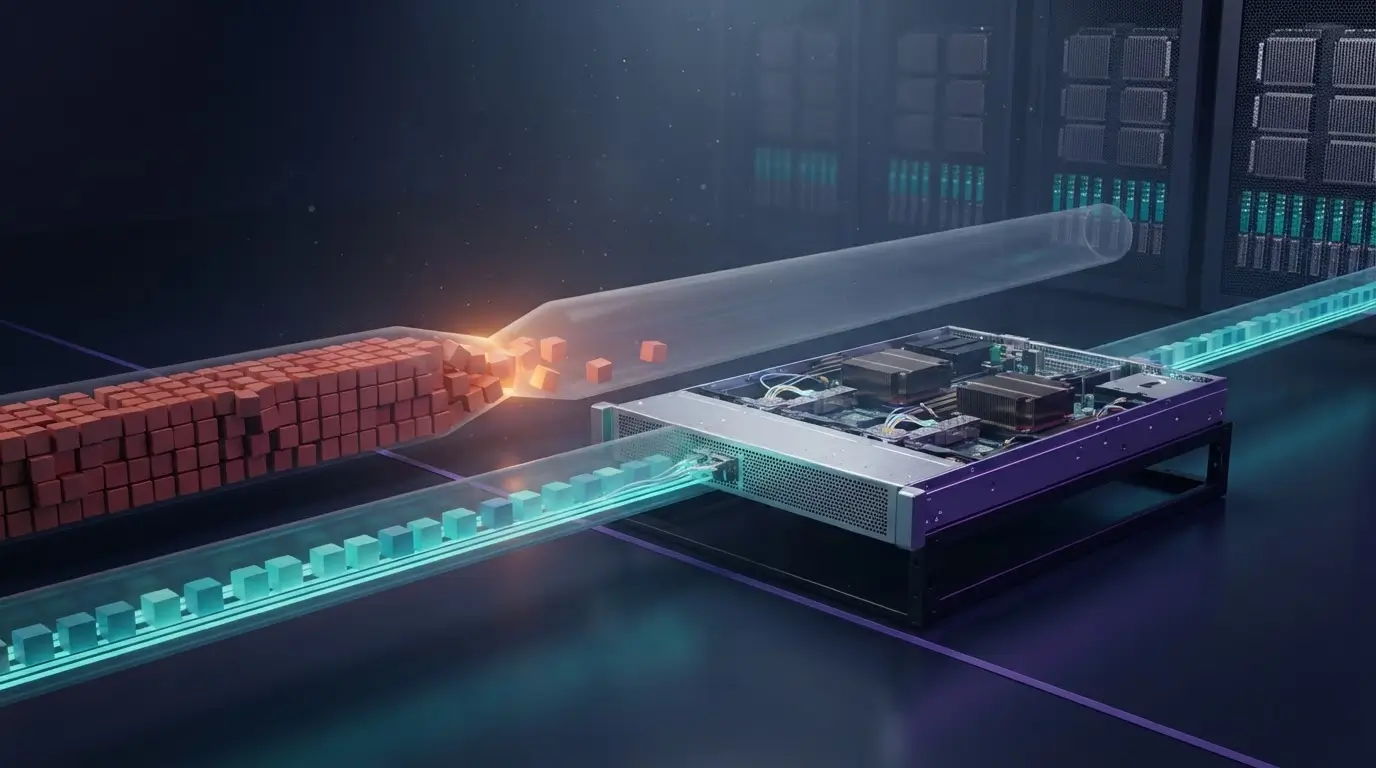
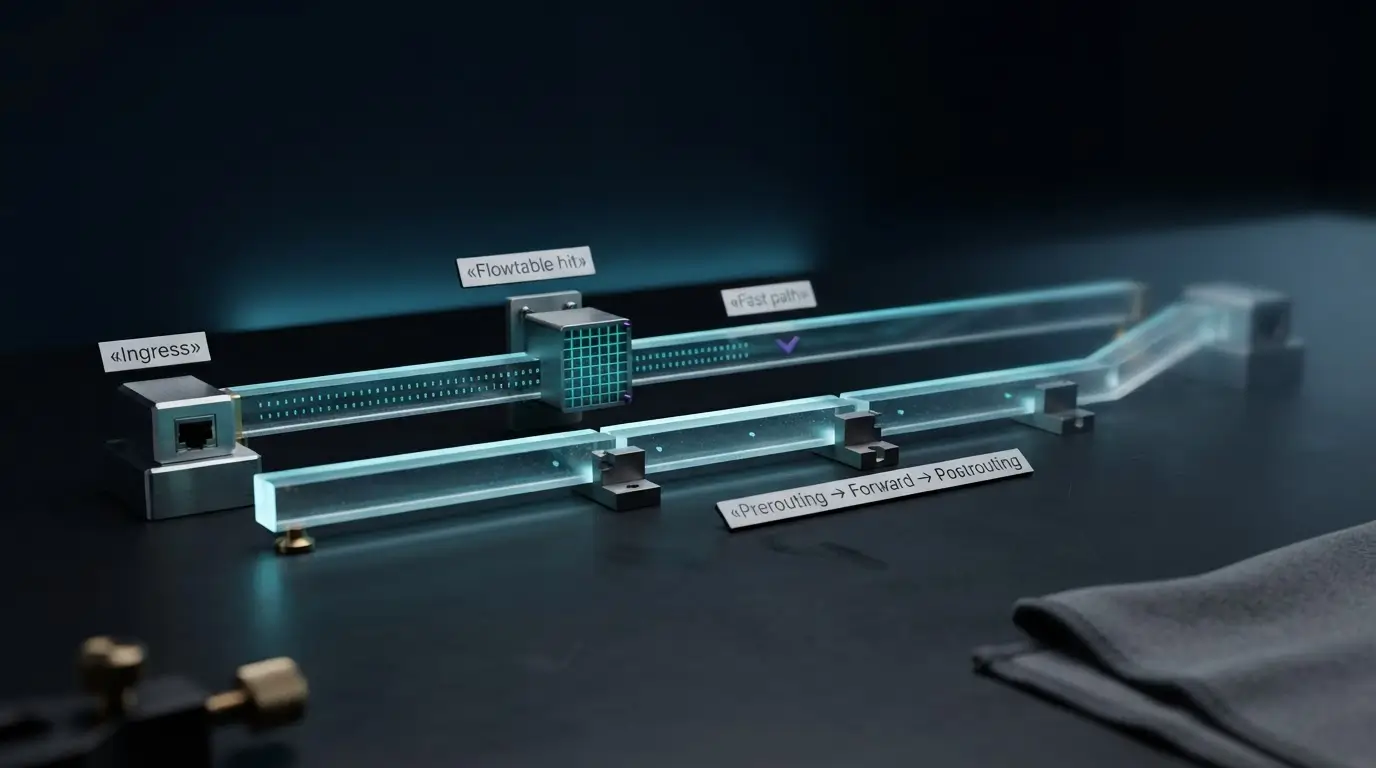
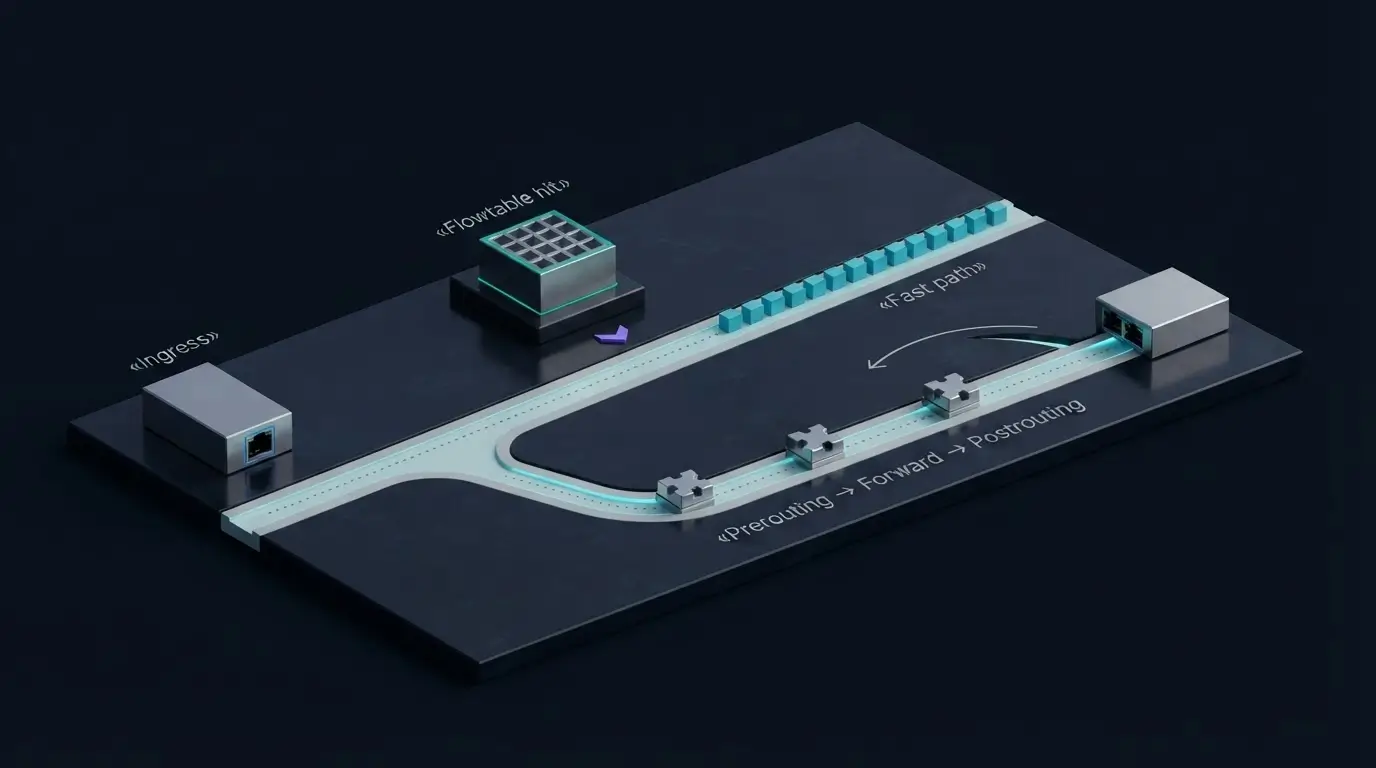
По официальной документации Linux kernel первый пакет успешно проходит обычный IP forwarding path. Правило flow add может добавить двунаправленный поток в flowtable, и последующие совпавшие пакеты уходят из ingress сразу к выходному netdevice через neigh_xmit(). Они обходят prerouting, routing decision, forward и postrouting hooks, расположенные после ingress. Именно поэтому счётчики в поздних nftables chains перестают расти: это ожидаемый эффект fast path, а не потеря трафика.
Lookup строится не только по адресам и портам. В tuple входят L2 encapsulation, L3 source/destination, L4 source/destination ports, protocol и input interface. Последний элемент важен при нескольких conntrack zones: одинаковый 5-tuple, пришедший с другого входа, не обязан разделять запись. Flowtable также кэширует выходной интерфейс и gateway address, уменьшает TTL/hop limit и хранит применённую NAT-конфигурацию.
Здесь полезна простая аналогия: classic path похож на паспортный контроль для каждого прохода, а flowtable — на временный пропуск, выданный после первой полной проверки. Пропуск действует только для уже квалифицированного маршрутизируемого потока. Новый SYN, flowtable miss, исключение протокола или изменившаяся топология возвращают пакет к обычной процедуре. Проверяли ли вы, что ваш «gateway» не является на самом деле локальным reverse proxy? Это первая граница применимости.
Сначала зафиксируйте effective path и baseline
Диагностику начинайте из того network namespace, где пакет фактически входит. На bare metal это часто root namespace, в Kubernetes или контейнерном gateway — уже не обязательно. Запишите ingress/egress interfaces, route для реального source, policy rules, соседей и место NAT. Не подменяйте доказательство схемой из CMDB: после CNI, VRF, tunnel или policy routing реальный path часто отличается от нарисованного.
Baseline должен соединять четыре уровня. Первый — path: ip route get, ip rule, namespace и интерфейсы. Второй — state: conntrack entry, NAT и будущий OFFLOAD tag. Третий — resource: per-CPU softirq, throughput, drops и нагрузка gateway process. Четвёртый — application outcome: time-to-first-token, inter-token gaps, ошибки и доля оборванных stream на новых соединениях. Абсолютный счётчик без delta и healthy control ничего не доказывает.
Снимите два профиля: обычный LLM streaming request и отрицательный контроль, который заведомо не должен попасть в выбранный fast path, например локально завершающееся health-соединение. Если обе метрики меняются одинаково, вероятен соседний фактор: warm cache, batching, смена backend или фоновой нагрузки. Для проверки offload на соседнем уровне пригодится отдельный материал про GRO, GSO и TSO: не смешивайте segmentation offload с Netfilter flowtable.
ip -br link
ip rule show
ip route get 203.0.113.20 from 10.20.0.15
nft -a list ruleset
conntrack -S
cat /proc/softirqs
ss -tin state established
Безопасная конфигурация software flowtable
Минимальный ruleset состоит из flowtable на ingress hook и строго квалифицированного flow add в forward chain. Не переносите в fast path весь TCP только потому, что пример в документации короткий. Ограничьте canary адресами gateway, backend subnet, портом и состоянием conntrack. Так вы сможете связать каждое изменение со своим владельцем и не спрячете от поздних hooks трафик, который должен логироваться, маркироваться или проходить дополнительную policy.
Приоритет ingress hook задаёт порядок с другими ingress chains. Документация ядра рекомендует располагать flowtable раньше nftables ingress chain, если оба существуют. Но это решение нельзя принимать вслепую: если ingress policy должна отбросить spoofed source до любого ускорения, порядок является частью security design. Проверьте загружаемый файл через nft --check -f, сохраните текущий ruleset и применяйте изменение атомарно.
Ниже — учебный каркас, а не готовая policy для копирования. Интерфейсы, сети и ownership NAT у вас будут другими. Для dual-stack используйте family inet, но отдельно подтвердите IPv4 и IPv6 outcome. Версия nftables на дату подготовки — 1.1.7 по официальным release notes Netfilter; доступность синтаксиса и поведения всё равно проверяйте по версии userspace и kernel конкретного хоста.
table inet llm_fastpath {
  flowtable ft_llm {
    hook ingress priority 0;
    devices = { eno1, eno2 };
    counter
  }

  chain forward {
    type filter hook forward priority filter; policy drop;

    ct state established,related
      ip saddr 10.20.0.0/24 ip daddr 10.30.0.0/24
      tcp dport 443 flow add @ft_llm

    ct state established,related accept
  }
}
Как доказать, что offload работает и приносит пользу
Первое доказательство — не падение CPU, а совпадение реального потока с policy. Создайте новое соединение после применения ruleset, найдите обе стороны tuple в conntrack и проверьте tag [OFFLOAD]. Для hardware path ожидается отдельный [HW_OFFLOAD]; эти статусы нельзя смешивать. Hardware programming выполняется асинхронной workqueue, поэтому первые пакеты могут некоторое время идти software path.
Второе доказательство — характер счётчиков. Пакеты, попавшие в fast path, не доходят до позднего counter в forward chain, однако flowtable counter при поддерживаемом kernel может синхронизировать packets/bytes с conntrack entry. Если вы видите рост обычного forward counter на каждом пакете, проверьте направление, interfaces, state и исключения. Если counter внезапно замолчал без OFFLOAD tag, ищите другую chain, drop или ошибку наблюдения.
Третье доказательство — resource delta на том же трафике: снижение softirq/forwarding CPU или рост headroom без новых drops. Четвёртое — application outcome на fresh connections. Для LLM API нас интересует не только request rate, но и TTFT, gaps внутри SSE-stream, reset rate и освобождение CPU для TLS/proxy. Результат считается причинным только после возврата к baseline: уберите flow add, повторите тот же probe и потребуйте возврата метрики. Это контрфактический A/B/A gate.
nft list flowtables
nft list flowtable inet llm_fastpath ft_llm
conntrack -L -p tcp | grep -E '\[OFFLOAD\]|\[HW_OFFLOAD\]'
nstat -az
mpstat -P ALL 1
curl --no-keepalive -sS -N https://api.example.net/v1/stream >/dev/null
Исключения fast path: NAT, MTU, fragments и закрытие TCP
Flowtable не означает, что NAT исчезает. Запись сохраняет NAT-конфигурацию, определённую первым проходом через classic path, и применяет её к последующим пакетам. Это удобно, но усиливает требования к ownership: изменение DNAT/SNAT policy в середине жизни потока не обязано немедленно переписать уже кэшированное решение. Для canary создавайте fresh connections и заранее решите, как вы будете дренировать старые.
Фрагментированный трафик возвращается в обычный forwarding path, потому что без transport header lookup может быть невозможен. Пакет, превышающий MTU, тоже идёт classic path, чтобы ядро отправило ICMP Packet Too Big. TCP FIN и RST проходят обычный путь для корректного завершения flow. Поэтому смешанный trace — часть нормальной работы. Ошибка начинается тогда, когда fallback совпадает с деградацией и вы не можете объяснить его долю.
Особое внимание уделите tunnels и PMTUD. Если streaming «подвисает» только на определённом размере ответа, не лечите это flowtable. Сначала проверьте effective MTU, ICMP delivery и retransmission. Та же дисциплина применима к асимметрии: reply должен попадать в согласованный conntrack/path. Материал про ip rule, rp_filter и fwmark помогает отделить routing control gap от offload.
A/B/A rollout без потери наблюдаемости
Canary должен менять одного owner. Выберите один gateway, одну пару интерфейсов и ограниченный набор backend addresses. До изменения сохраните ruleset, метрики и несколько pcap с внешней точки. Host-side capture после ingress не является полным wire evidence: flowtable hit обходит последующие hooks, а segmentation offload может менять вид пакета на самом хосте. SPAN-порт или соседний sensor помогает увидеть реальный wire.
Фаза A — baseline без flow add. Фаза B — тот же workload с software flowtable. Фаза A2 — удаление только canary rule и повтор на новых соединениях. Положительный результат требует симметрии: OFFLOAD появляется в B, resource/application metric улучшается в B и возвращается примерно к исходному поведению в A2. Не фиксируйте универсальный процент: он зависит от packet rate, CPU, NIC, ruleset и доли локально завершаемого трафика.
Rollback должен быть скучным. Заранее подготовьте файл, который атомарно удаляет canary rule или flowtable, проверьте его через nft --check и назовите stop conditions: рост resets, недоступность отдельной сети, потеря telemetry, расхождение NAT или отсутствие application gain. После rollback повторите path, conntrack, counter и LLM probes. Иначе «мы вернули конфиг» остаётся предположением.
delete table inet llm_fastpath
Software и hardware offload: где проходит граница инфраструктуры
Software flowtable оставляет forwarding в ядре и обычно является первым разумным canary: меньше зависимостей от конкретной NIC, driver и firmware, проще rollback. Hardware offload добавляет flags offload и переносит поддерживаемые flows в устройство. По документации ядра несколько первых пакетов всё равно могут пройти software path, пока workqueue программирует hardware. Поддержка зависит от устройства и driver; наличие синтаксиса не гарантирует реальный HW datapath.
Есть и cache risk. Flowtable хранит destination MAC и egress netdevice; при изменении topology запись может устареть. Документация отдельно отмечает риск для software режима при сочетании bridge и IP forwarding, а также для hardware offload. В HA-схеме проверьте failover neighbor, bond/team, bridge ports и смену next hop. Если после failover трафик продолжает идти к старому MAC, скорость уже не имеет значения.
Коммерческая граница появляется после доказанного control gap. VPS подходит, когда нужен изолированный kernel baseline и управляемый ruleset без владения NIC firmware. Dedicated gateway оправдан, если нужны стабильные queues, NUMA locality, driver/firmware ownership, внешний capture и предсказуемое change window. SmartNIC/DPU имеет смысл только при подтверждённом packet-processing hotspot и компетенции сопровождать offload. Новое железо не исправляет неверный selector, ECMP reordering, proxy buffering или очередь GPU.
При выборе инфраструктуры сравнивайте не обещание «меньше latency», а четыре вещи: кто владеет kernel/NIC версиями, какие counters доступны, каков failure domain и насколько быстро выполняется rollback. Для смежной проверки сетевых очередей используйте ethtool-runbook по NIC ring buffers и RX drops; flowtable не компенсирует переполненный RX ring.
Частые ошибки диагностики
Ошибка 1: считать OFFLOAD доказательством пользовательского эффекта. Tag доказывает datapath state, но не улучшение TTFT или streaming. Всегда соединяйте его с resource delta и LLM outcome. Ошибка 2: тестировать reused connection. Старый keepalive мог быть создан до policy change; для каждого этапа открывайте fresh connection.
Ошибка 3: путать локальный proxy с forwarded gateway. Если socket принадлежит Envoy/Nginx на том же хосте, этот сегмент проходит input/userspace/output, а не простой forward bypass. Ошибка 4: ждать роста поздних nft counters. При flowtable hit их молчание ожидаемо. Перенесите наблюдение к ingress, conntrack/flowtable counters и внешнему capture.
Ошибка 5: включать всё сразу. Одновременная смена flowtable, IRQ affinity, GRO, qdisc и proxy timeout делает результат неразрешимым. Меняйте одного owner. Ошибка 6: игнорировать exceptions. Fragments, MTU, FIN/RST и misses возвращаются в classic path; mixed trace не равен поломке.
Ошибка 7: переходить к hardware до software proof. Так вы добавляете driver, firmware и asynchronous programming к ещё не доказанной гипотезе. Ошибка 8: покупать dedicated gateway раньше evidence. Выделенная инфраструктура даёт контроль, но не превращает неподходящий workload в подходящий. Если bottleneck живёт в TLS storm, начните с отдельного runbook по handshake, resumption и keepalive.
Production-чеклист владельца gateway
Перед change window назначьте владельцев: network path, nftables policy, NAT, observability и LLM application metric. Один человек не должен молча владеть всеми допущениями. Согласуйте точный canary scope, fresh-connection generator, healthy negative control и stop conditions. Запишите kernel, nftables, NIC driver и firmware versions, но не превращайте список версий в доказательство совместимости — её даёт только ваш canary.
- Path подтверждён из effective namespace для обоих направлений.
- Flowtable devices совпадают с реальными ingress/egress netdevices.
- Canary policy ограничена адресами, портом и conntrack state.
- Baseline включает CPU/softirq, drops, conntrack и application outcome.
- OFFLOAD и при необходимости HW_OFFLOAD проверяются отдельно.
- Fragments, MTU, FIN/RST и failover topology входят в negative tests.
- Rollback проверен синтаксически и операционно.
- После B выполняется A2 с теми же probes.
Затем спросите неприятное, но полезное: что произойдёт, если ускорение освободит CPU gateway, а предел мигрирует в TLS, proxy worker, storage или GPU queue? План наблюдения должен продолжаться за границей fast path. Хороший runbook заканчивается не зелёным counter, а объяснимым поведением всей цепочки запроса.
Вывод: ускоряйте доказанный hop, а не архитектуру на глаз
nftables flowtable — зрелый механизм fast path для маршрутизируемых TCP/UDP flows, но его область уже, чем звучит слово «ускорение». Первый пакет проходит classic path, policy явно отбирает кандидатов, последующие hits обходят поздние Netfilter hooks, а NAT state сохраняется. Exceptions закономерно возвращаются в обычную обработку. Поэтому production-диагностика должна связывать path, OFFLOAD state, CPU/queue delta и результат LLM API.
Начните с software canary и A/B/A rollback. Hardware offload и выделенный gateway рассматривайте только после доказанного packet-processing hotspot и понятной границы контроля. Если application metric не двигается, остановитесь: новое железо не исправит TLS, buffering, retry storm или GPU queue. Зато при подтверждённом forwarding bottleneck предсказуемый kernel/NIC baseline, наблюдаемость и change window действительно становятся ценностью инфраструктуры.
Практический следующий шаг прост: возьмите один gateway, соберите baseline по чеклисту, ограничьте canary одним flow и проверьте его на fresh connections. Сохраните evidence bundle и выполните rollback даже при хорошем результате. Так вы получите не красивый tag, а воспроизводимое решение, которое можно безопасно расширять или обсудить с командой KingServers при выборе VPS либо выделенного сетевого узла.