Оглавление
- Симптом: токены идут рывками, но TCP выглядит здоровым
- Почему flow control нужно разбирать hop-by-hop
- Собираем evidence bundle до изменения конфигурации
- Четыре gate: frame, proxy, consumer и application
- Настройка Envoy: меняем одно окно и считаем память
- A/B/A canary: доказываем причинность, а не совпадение
- Медленный consumer: окно покупает время за память
- Что обычно принимают за HTTP/2 flow-control stall
- VPS, dedicated edge или managed gateway: решение после path proof
- Production-runbook: от алерта до безопасного rollback
- Вывод: увеличивайте окно только после доказательства
Токены внезапно перестают идти, хотя TLS жив, TCP не теряет пакеты, а GPU ещё не упёрся в потолок. Через несколько секунд ответ догоняет клиента пачкой, и средняя latency маскирует неприятную межтокеновую паузу. Часто виноват не сокет и не модель, а исчерпанный credit HTTP/2 на одном из двух независимых участков вокруг API gateway. Разберём, как доказать эту гипотезу кадрами WINDOW_UPDATE, метриками Envoy и A/B/A canary, не превращая увеличение окон в бесконтрольный расход памяти.
Готовы перейти на современную серверную инфраструктуру?
В King Servers мы предлагаем серверы как на AMD EPYC, так и на Intel Xeon, с гибкими конфигурациями под любые задачи — от виртуализации и веб-хостинга до S3-хранилищ и кластеров хранения данных.
- S3-совместимое хранилище для резервных копий
- Панель управления, API, масштабируемость
- Поддержку 24/7 и помощь в выборе конфигурации
Результат регистрации
...
Создайте аккаунт
Быстрая регистрация для доступа к инфраструктуре
Симптом: токены идут рывками, но TCP выглядит здоровым
Типичный инцидент начинается неприятно буднично: TLS установлен, retransmits не растут, GPU не загружен до предела, а потоковый ответ LLM на несколько секунд замирает между токенами. Затем данные приходят пачкой, и средняя latency в дашборде выглядит терпимо. Пользователь, однако, видит не среднее, а паузу. Если команда сразу увеличивает TCP buffers или число GPU, она меняет не тот слой.
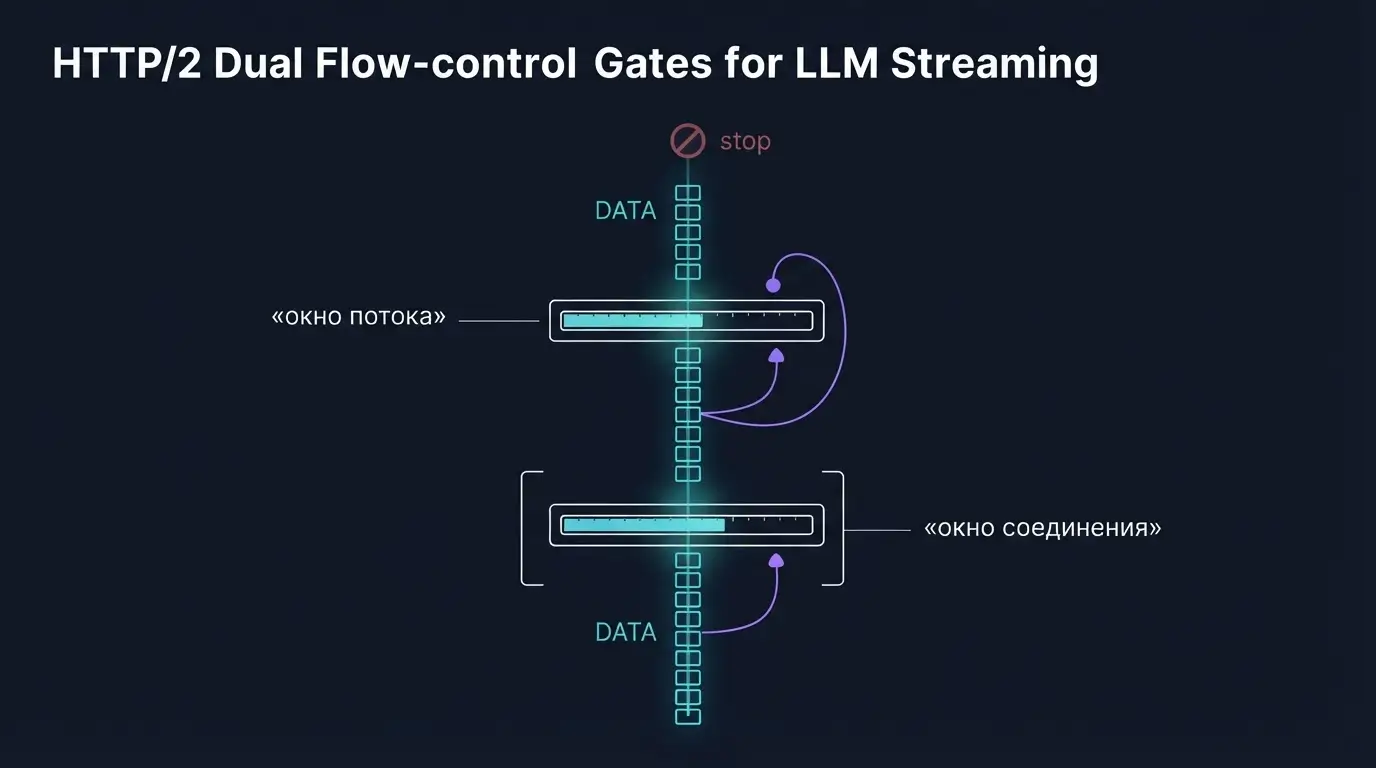
HTTP/2 добавляет поверх TCP собственный credit-based flow control. Отправитель может передавать DATA, только пока у него есть кредит одновременно в окне конкретного stream и в окне connection. Кредит возвращает получатель кадрами WINDOW_UPDATE по мере потребления данных. Поэтому здоровый socket не гарантирует, что HTTP/2 sender сейчас имеет право отправить следующий фрагмент ответа.
Граница этой статьи узкая: мы диагностируем паузы в LLM streaming на пути клиент → Envoy → inference и доказываем, где исчерпан credit. Это не продолжение общего разбора TCP autotuning и не статья о graceful drain. Материал про то, как отделить медленного consumer, окно stream, окно connection, buffering посредника и реальную очередь модели.
Быстрый disqualifier: если inference backend не создаёт токены или очередь scheduler растёт до первого токена, настройка HTTP/2-окон не поможет. Сначала докажите наличие DATA на upstream hop. Только после этого есть смысл трогать flow control.
Для соседних уровней используйте отдельные runbook: TCP buffers и socket backpressure, HTTP/2 GOAWAY и gRPC keepalive, TLS handshake storm и HTTP/3 для AI API. Они помогают проверить смежные гипотезы, не смешивая их с credit HTTP/2.
Почему flow control нужно разбирать hop-by-hop
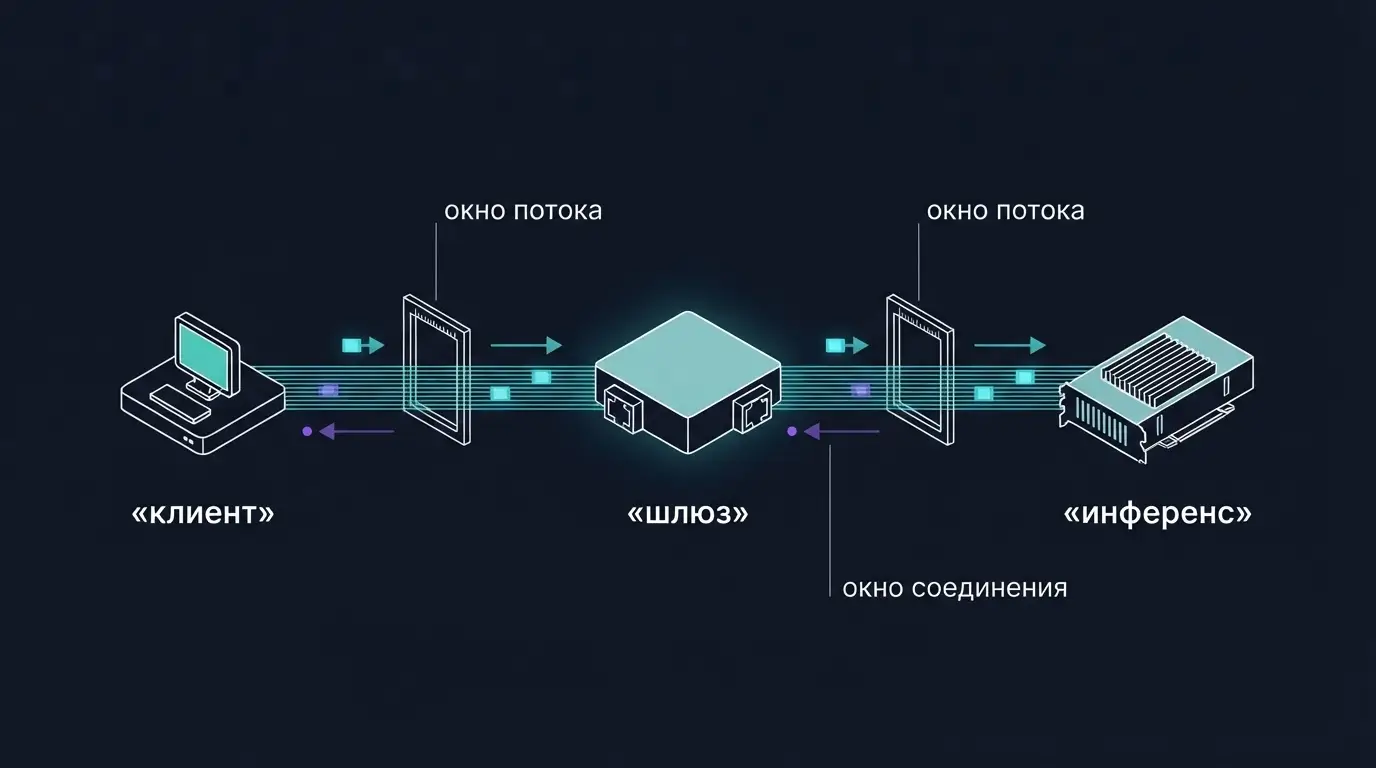
По RFC 9113 flow control специфичен для одного HTTP/2 connection, направлен и управляется получателем. Посредник не пересылает WINDOW_UPDATE сквозь себя. Envoy принимает downstream DATA в роли одного endpoint и отправляет upstream DATA уже по другому connection в роли другого endpoint.
Это меняет ход расследования. Представьте, что inference быстро отдаёт токены Envoy, а мобильный клиент читает редко. Upstream window может оставаться открытым, пока downstream sender упирается в кредит клиента и memory watermark шлюза. Обратная картина тоже возможна: клиент готов читать, но upstream connection застопорен приложением, которое не освобождает receive buffer.
У каждого направления два лимита: stream window и connection window. Первый локализует давление конкретного RPC, второй делится между всеми потоками одного соединения. Когда один большой ответ перестал получать stream credit, соседние stream теоретически могут продолжить. Когда исчерпан connection credit, остановка заметна шире. На практике сюда добавляются scheduling, user-space buffers и event loop, поэтому один снимок окна ещё не доказывает причину.
RFC задаёт начальное значение 65 535 октетов для новых stream и connection до последующих SETTINGS/WINDOW_UPDATE, но реализации вправе рекламировать другие значения. В актуальной документации Envoy v3 параметры initial_stream_window_size и initial_connection_window_size настраиваются отдельно для downstream и upstream. Сверяйте синтаксис с установленной версией: latest-документация может описывать более новый релиз.
Собираем evidence bundle до изменения конфигурации
Начните с одной canary-сессии и сохраните идентичность пути: клиентский IP, gateway pod или процесс, upstream endpoint, connection ID и stream ID. Без этой связки легко сравнить WINDOW_UPDATE одного соединения с TTFT другого. Для long-lived stream особенно важно создавать fresh connection: reuse скрывает SETTINGS и переносит накопленное состояние.
Сначала подтвердите negotiated protocol и время появления первых байтов. curl удобен для SSE или совместимого HTTP API; для gRPC используйте клиент, который показывает transport events, либо grpcurl для функциональной проверки. Команда ниже не доказывает flow-control stall сама по себе, но фиксирует ALPN, headers и application timeline.
curl -sv --http2 --no-keepalive \
  -H 'content-type: application/json' \
  --data @request.json \
  https://canary.example/v1/chat/completions \
  -o /tmp/stream.out 2>/tmp/curl.trace

date -Ins
wc -c /tmp/stream.out
sed -n '1,120p' /tmp/curl.traceЗатем снимите pcap одновременно на downstream и upstream интерфейсах шлюза. TLS требует session keys или capture на доверенной точке до шифрования; без расшифровки вы увидите TCP timing, но не типы HTTP/2 frames. На тестовом стенде h2c или debug build упрощает анализ, однако не переносите небезопасный режим в production.
sudo tcpdump -i eth0 -s 0 -w /tmp/downstream.pcap 'host 198.51.100.24'
sudo tcpdump -i eth1 -s 0 -w /tmp/upstream.pcap 'host 10.42.7.19'

tshark -r /tmp/downstream.pcap -Y 'http2.type == 0 || http2.type == 8'
tshark -r /tmp/upstream.pcap -Y 'http2.type == 0 || http2.type == 8'Ищите последовательность DATA → исчерпание доступного credit → пауза → WINDOW_UPDATE → возобновление DATA. Сопоставляйте её не со средней throughput, а с межтокеновой паузой конкретного запроса. Если пауза в приложении начинается раньше протокольной остановки, окно лишь отражает медленное чтение выше по стеку.
Четыре gate: frame, proxy, consumer и application
Расследование удобно вести четырьмя доказательствами. Frame gate отвечает на вопрос, действительно ли sender исчерпал stream или connection credit. Нужны DATA и WINDOW_UPDATE на одном connection, правильное направление и общий timeline. Само наличие WINDOW_UPDATE нормально: это механизм работы протокола, а не ошибка.
Proxy gate проверяет, где Envoy приостановил чтение и выросли ли буферы. В статистике Envoy полезны counters семейства downstream_flow_control_paused_reading_total, upstream_flow_control_paused_reading_total и upstream_flow_control_backed_up_total, если они доступны в вашей версии и конфигурации. Снимайте дельту на canary, а не абсолютное значение после месяцев работы.
Consumer gate доказывает, что получатель действительно читает stream. В gRPC запись сообщения означает передачу framework, а не гарантированную отправку по сети; официальное руководство gRPC по flow control отдельно предупреждает о взаимной блокировке при ручном управлении, если обе стороны много пишут и не читают. Для SSE проверьте, не буферизует ли клиентский SDK, reverse proxy или UI-слой.
Application gate связывает транспорт с результатом: TTFT, распределение межтокеновых пауз, число завершённых stream, время освобождения inference slot и доля отменённых запросов. Положительный frame gate без изменения этих метрик доказывает механизм, но не бизнес-эффект.
Настройка Envoy: меняем одно окно и считаем память
В Envoy downstream и upstream HTTP/2 options принадлежат разным объектам конфигурации. Это полезно: можно изменить receive window только на проблемном hop. Одновременно это ловушка: правка upstream параметра не исправит клиента, который перестал читать downstream response.
Ниже показан фрагмент v3 API для upstream cluster. Он демонстрирует структуру, а не универсальные числа. Актуальная документация Envoy указывает допустимый диапазон до 231−1 и предупреждает, что window связан с buffering. Перед rollout проверьте config dump и документацию именно вашей версии; legacy поле http2_protocol_options на уровне cluster заменяется typed extension options.
typed_extension_protocol_options:
  envoy.extensions.upstreams.http.v3.HttpProtocolOptions:
    "@type": type.googleapis.com/envoy.extensions.upstreams.http.v3.HttpProtocolOptions
    explicit_http_config:
      http2_protocol_options:
        initial_stream_window_size: 1048576
initial_connection_window_size: 4194304Не копируйте эти значения как «оптимальные». Оцените верхнюю границу памяти: число активных connections × connection budget плюс число активных streams × stream budget, затем добавьте реальные L7 buffers, фильтры, TLS и allocator overhead. Window не всегда равен фактически выделенной памяти байт в байт, но рост лимитов расширяет возможный memory envelope и blast radius.
Канареечная правка должна иметь владельца, лимит RSS и stop condition. Например: откатить профиль, если RSS растёт без улучшения p95 межтокеновой паузы, увеличиваются resets или gateway начинает задерживать соседние короткие запросы. Это важнее красивого графика throughput на одном stream.
A/B/A canary: доказываем причинность, а не совпадение
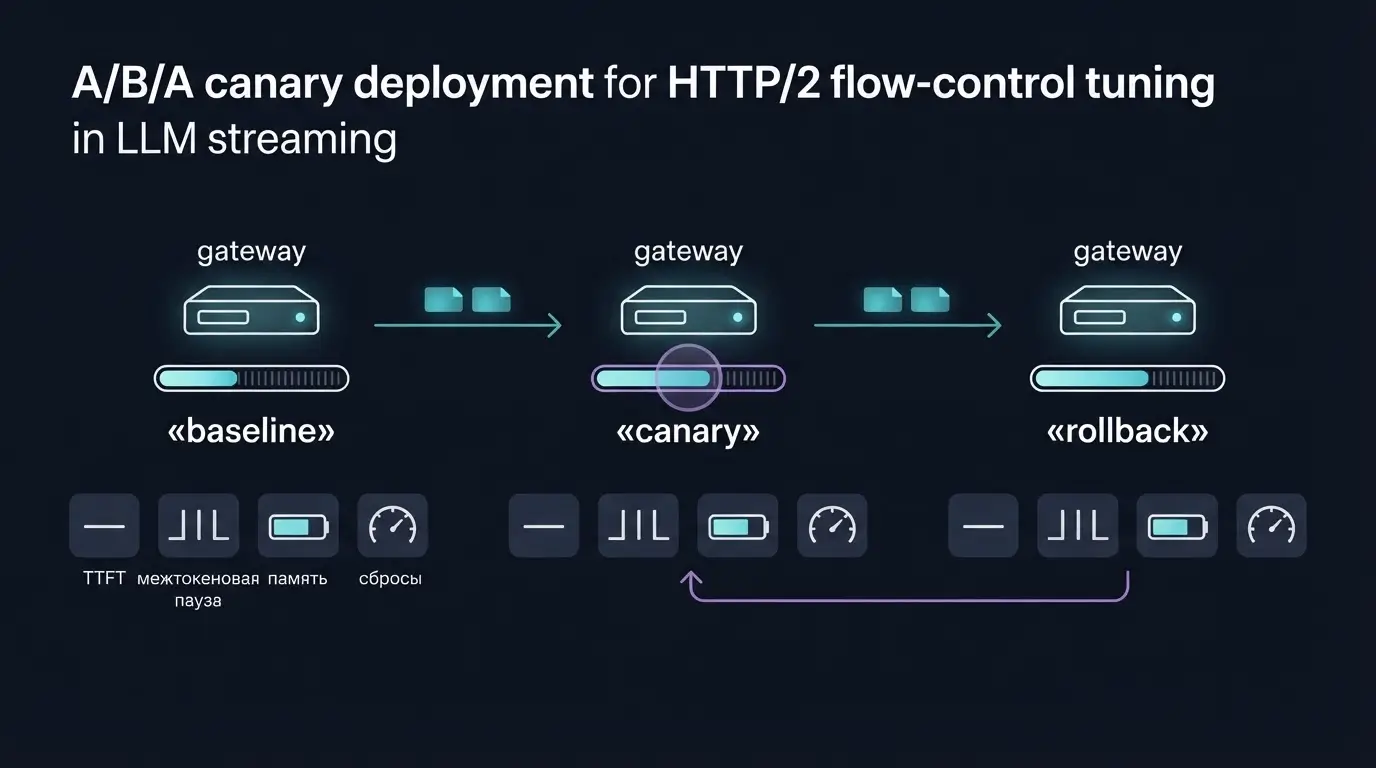
Baseline A собирайте на неизменной конфигурации с двумя классами трафика: обычным быстрым consumer и контролируемо медленным. Фиксируйте advertised SETTINGS, частоту и размер WINDOW_UPDATE, paused-reading counters, RSS, CPU event loop, TTFT и межтокеновые паузы. Медленный consumer нужен как отрицательный контроль: увеличение окна способно только отложить его backpressure, а не устранить.
В фазе B меняйте один owner. Если гипотеза про upstream stream window, не трогайте одновременно connection window, число connections, TCP rmem и worker count. Иначе вы не поймёте, что сработало. Нагрузочный профиль, model revision, prompt и sampling parameters должны оставаться одинаковыми.
После положительного результата верните baseline A. Если протокольная пауза и application metric воспроизводимо возвращаются, причинность стала заметно сильнее. Если эффект остался после rollback, вероятно, изменилась нагрузка, прогрелся cache, мигрировал endpoint или рассосалась GPU queue.
Отдельно проверьте новые и существующие connections. SETTINGS_INITIAL_WINDOW_SIZE влияет на новые stream и может скорректировать активные stream, а connection-level credit меняется WINDOW_UPDATE. Поэтому часть клиентов продолжит жить со старым negotiated state до переподключения. Rollout-план должен явно сказать, нужен ли drain, и не смешивать его с аварийным reset.
Медленный consumer: окно покупает время за память
Большое окно не делает медленного клиента быстрым. Оно позволяет sender дольше передавать данные до остановки и перемещает очередь между слоями. Для короткого burst это может сгладить паузу. Для клиента, который стабильно потребляет медленнее генерации, накопление продолжится, пока не сработает watermark, лимит буфера, timeout или cancellation.
Здесь полезно рассуждать через конечный budget. Допустим, у вас тысячи долгих LLM stream, часть проходит через мобильные сети. Даже умеренный per-stream запас, умноженный на concurrency, превращается в заметный memory envelope. Добавьте connection window: слишком маленький способен связать судьбу соседних stream, слишком большой ослабляет ранний сигнал перегрузки.
Проверяйте три режима отдельно: быстрый consumer, consumer с ограниченной скоростью чтения и consumer, который перестал читать совсем. В третьем случае корректный outcome часто не «дождаться когда-нибудь», а отменить stream, освободить backend capacity и записать понятную причину. Иначе gateway удерживает память, а inference продолжает работу, результат которой никто не забирает.
Если приложение использует gRPC manual flow control, согласуйте read/write loop. Официальная документация gRPC подчёркивает, что framework может приостановить write и что обе стороны должны продолжать чтение. В SSE проверьте flush на backend и фильтры посредника: application buffering может выглядеть как transport stall, хотя credit ещё доступен.
Что обычно принимают за HTTP/2 flow-control stall
Первая ложная причина — TCP backpressure. HTTP/2 работает поверх TCP, поэтому loss, congestion window, zero window на сокете и медленный receiver остаются значимыми. Сопоставьте ss -tinm, retransmits и pcap с HTTP/2 frames. Если sender имеет HTTP/2 credit, но socket write не продвигается, увеличение protocol window не лечит transport path.
Вторая — L7 buffering. Некоторые filters требуют тело целиком или имеют собственные лимиты. Envoy flow-control FAQ прямо разделяет listener, cluster и HTTP/2 stream limits и отмечает, что non-streaming filters меняют поведение больших body. Проверьте transcoder, buffer filter, ext_authz body capture и пользовательские extensions.
Третья — concurrency queue. Один HTTP/2 connection имеет negotiated предел одновременных streams. В gRPC performance guidance отмечено, что новые RPC могут ждать, когда лимит достигнут; для long-lived streaming это особенно заметно. Такая очередь возникает до отправки DATA и не равна исчерпанию flow-control window.
curl -fsS http://127.0.0.1:9901/stats?filter=flow_control
curl -fsS http://127.0.0.1:9901/stats?filter='upstream_rq_(pending|active|tx_reset|rx_reset)'
curl -fsS http://127.0.0.1:9901/config_dump > /tmp/envoy-config-dump.json
sha256sum /tmp/envoy-config-dump.jsonЧетвёртая — сама модель. Если upstream не отправляет DATA, смотрите scheduler delay, prefill, KV-cache pressure, batch composition и cancellation. Бывает и смешанный случай: медленный downstream клиент удерживает stream, cancellation не доходит до inference, и GPU продолжает ненужную генерацию. Тогда лечить нужно propagation отмены и ownership capacity, а не только окно.
VPS, dedicated edge или managed gateway: решение после path proof
Покупать новую платформу до доказательства hop — плохой procurement default. Если причина в клиентском SDK, фильтре buffering или GPU queue, более мощный сервер лишь сделает ошибку дороже. Сначала покажите, что canary окна меняет application metric и что эффект возвращается после rollback.
VPS подходит, когда нужен изолированный gateway с умеренным трафиком, а команда контролирует Envoy config, telemetry и rollout. Проверьте, насколько предсказуемы CPU scheduling, memory guarantee и network path. Для flow-control расследования важна не вывеска виртуализации, а возможность получить стабильный baseline и повторить тест.
Dedicated edge становится оправданным, когда доказан CPU/NIC/memory control gap: нужна фиксированная NUMA-топология, управляемые NIC queues, большой предсказуемый memory envelope или отдельный failure domain. Ценность здесь — ownership версии, kernel, окна изменений и rollback, а не обещание универсально меньшей latency.
Managed gateway снимает часть on-call и lifecycle работы, но может скрывать negotiated SETTINGS, connection pooling и внутренние buffers. Перед выбором спросите, доступны ли per-hop metrics, packet evidence, config versioning и контролируемый canary. Если ответов нет, сервис может быть удобным, но диагностическая граница останется у провайдера.
KingServers уместен в этой схеме после доказанного resource/control gap: можно вынести gateway на VPS или выделенный сервер, отделить его failure domain от inference и зафиксировать воспроизводимый профиль. Но новое железо не исправит медленный consumer, неверный L7 filter или очередь модели.
Production-runbook: от алерта до безопасного rollback
Шаг первый — квалифицировать симптом. Разделите TTFT и межтокеновую паузу, отметьте client class, connection reuse и backend endpoint. Сохраните healthy negative control: короткий unary или streaming request через тот же gateway, который не воспроизводит паузу.
Шаг второй — построить owner map. Для каждого hop запишите sender, receiver, stream ID, advertised window, кто читает данные и кто может изменить конфигурацию. Снимите frame trace и Envoy counters в одном временном окне. Не делайте вывод по старому pcap и текущему дашборду.
Шаг третий — локализовать gate. Flow-control гипотеза требует трёх совпадений: credit достигает нуля, DATA прекращается на том же hop, после WINDOW_UPDATE DATA возобновляется. Затем нужен четвёртый элемент — совпадение с пользовательской паузой. Без него это нормальная работа механизма.
Шаг четвёртый — провести B-canary одним параметром и с конечным memory budget. Stop condition должен быть автоматизируемым: рост RSS, resets, downstream errors или деградация соседнего класса запросов. Если окно помогает только синтетическому stream, а production distribution не меняется, rollout не обоснован.
Шаг пятый — вернуть A и повторить те же probes. Симметричный rollback важен не меньше rollout: fresh connection, те же prompt и consumer profile, те же counters и application metrics. После подтверждения документируйте effective config и version lock, иначе следующий deploy незаметно вернёт старые окна.
Наконец, проверьте миграцию bottleneck. Убрав flow-control stall, можно открыть следующий предел: TCP, event loop, TLS, L7 filter, GPU scheduler или storage. Успешный тюнинг — это не «все графики зелёные», а объяснимая причинная цепочка от frame до результата пользователя.
Вывод: увеличивайте окно только после доказательства
HTTP/2 flow control защищает получателя и разделяет ресурсы между stream, но на LLM streaming он способен проявиться как длинная пауза между токенами. Ключ к диагностике — не размер окна сам по себе, а четыре связанных доказательства: кадры на конкретном hop, состояние gateway, поведение consumer и application outcome.
Начните с fresh-connection baseline, снимите downstream и upstream отдельно, проведите A/B/A canary и посчитайте конечный memory envelope. Увеличение окна допустимо, когда оно воспроизводимо убирает протокольную остановку и улучшает пользовательскую метрику без роста resets и давления на память. Во всех остальных случаях ищите владельца в TCP, фильтрах, concurrency queue или inference.
Практический следующий шаг прост: возьмите один проблемный stream, соберите evidence bundle по runbook и докажите место остановки до следующего change window. Если path proof укажет на нехватку управляемого CPU, NIC или memory budget, тогда уже имеет смысл переносить gateway на отдельный VPS или dedicated edge и закреплять воспроизводимый baseline.