Оглавление
- Почему retransmission превращается в длинный хвост latency
- RACK, TLP и RTO: три разных события
- План доказательств: socket, ACK, path, application
- Снимаем baseline Linux без изменения параметров
- Как читать ACK, SACK и таймеры вместе
- Отличаем настоящую потерю от reordering и delayed ACK
- Что можно менять, а что лучше оставить в покое
- A/B/A canary: проверяем recovery, а не надежду
- Когда проблема действительно упирается в инфраструктуру
- Короткий runbook и вывод
Готовы перейти на современную серверную инфраструктуру?
В King Servers мы предлагаем серверы как на AMD EPYC, так и на Intel Xeon, с гибкими конфигурациями под любые задачи — от виртуализации и веб-хостинга до S3-хранилищ и кластеров хранения данных.
- S3-совместимое хранилище для резервных копий
- Панель управления, API, масштабируемость
- Поддержку 24/7 и помощь в выборе конфигурации
Результат регистрации
...
Создайте аккаунт
Быстрая регистрация для доступа к инфраструктуре
Почему retransmission превращается в длинный хвост latency
Симптом обычно выглядит обманчиво: средняя задержка LLM API остаётся нормальной, CPU на gateway не упирается в потолок, GPU занят полезной работой, но отдельные ответы внезапно получают паузу перед первым или последним токеном. В логах приложения это часто выглядит как «медленный backend». На проводе же может оказаться потерян последний TCP-сегмент, которому не хватает последующих пакетов для классических трёх duplicate ACK.
Для интерактивного request/response-трафика это особенно болезненно. Потеря внутри большого полёта данных быстрее даёт SACK-обратную связь, а потеря в хвосте маленького ответа может ждать таймер. Поэтому полезно смотреть не на общий процент retransmissions, а на связь конкретного recovery episode с TTFB, межтокенной паузой и завершением ответа. Один всплеск counter без временной привязки не объясняет p99.
RFC 8985 описывает RACK-TLP как time-based loss detection: RACK использует время передачи и ACK/SACK более новых данных, а Tail Loss Probe пытается получить ACK до дорогого RTO. Это не «ускоритель сети» и не замена congestion control. Механизм лишь раньше собирает доказательство потери там, где счётчика duplicate ACK недостаточно.
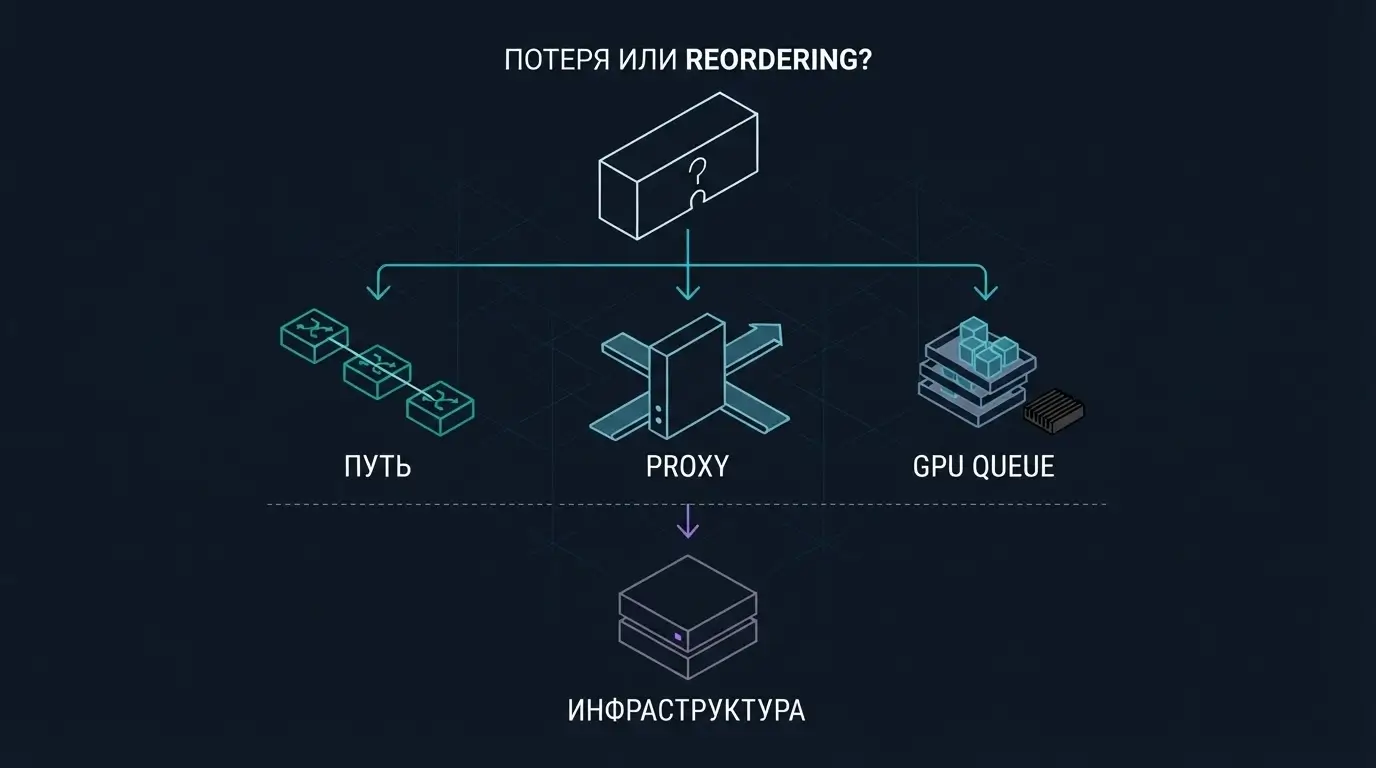
Практический вопрос: видите ли вы один и тот же скачок p99 одновременно в socket state и в пользовательском outcome? Если нет, не тюнингуйте kernel вслепую. Пауза может жить в proxy buffering, HTTP/2 flow control или очереди inference. Для первого соседнего слоя полезен отдельный разбор HTTP/2 flow control в LLM streaming.
Полезный способ не потерять контекст — завести единый incident timeline. Отмечайте начало и конец запроса, идентификатор gateway, peer tuple, момент первого байта, последний token и socket cookie. Рядом кладите интервалы capture и snapshots. Тогда команда приложений не спорит с сетью о разных минутах и разных соединениях. Для LLM streaming это критично: короткая пауза перед первым токеном, разрыв в середине генерации и задержка финального chunk имеют разные владельцы. Первая может быть связана с очередью scheduler, вторая — с downstream flow control, третья — с tail loss. Один агрегированный p99 смешивает эти истории и толкает к неверному fix.
RACK, TLP и RTO: три разных события
RACK отвечает на вопрос: какой ранее отправленный сегмент уже достаточно стар, если более новый сегмент подтверждён? Он работает во временной области, поэтому полезен для application-limited traffic, reordering и потерянных retransmission. Соединение должно использовать SACK, а отправитель хранит время последней передачи сегмента или TSO-агрегата.
TLP решает соседнюю задачу. Когда ACK-обратная связь иссякла у хвоста полёта, отправитель посылает один probe: новые данные, если они доступны, либо повтор последнего сегмента. Успешный probe вызывает ACK, после чего RACK может отметить ранние неполученные данные потерянными. Если probe тоже пропал, остаётся RTO. Именно поэтому TLP нельзя трактовать как бесконечный retry loop.
RTO остаётся консервативным fallback. Он нужен, когда ACK clock фактически потерян. Рост RTO или backoff говорит, что восстановление дошло до дорогого пути, но не объясняет, где потерялись пакет или ACK. Один и тот же результат возможен при policer на forward path, перегруженном reverse path, зависшем peer и firewall state.
Не смешивайте loss detection и congestion control. RFC прямо разводит эти роли: RACK определяет потерю, а retransmit допускает congestion control. Поэтому включённый RACK не означает, что CUBIC, BBR или PRR перестают управлять окном. Сначала зафиксируйте механизм, затем outcome. Иначе красивое снижение RTO episodes может скрыть рост очереди на следующем hop.
План доказательств: socket, ACK, path, application
Рабочий runbook начинается не с sysctl, а с owner map. Кто принимает клиентский TCP: cloud load balancer, dedicated edge, ingress controller или сам inference server? Где завершается TLS? Есть ли второй TCP hop между proxy и backend? Без этой карты легко смотреть не тот сокет и связывать клиентскую паузу с backend-соединением, которое в этот момент здорово.
Разделите расследование на четыре gate. Первый — per-socket state: RTT, rttvar, RTO, backoff, unacked, retrans и cwnd. Второй — ACK/SACK evidence в capture: какие sequence ranges дошли, есть ли DSACK, когда появился probe. Третий — path: NIC queues, qdisc, policer, ECMP, bonding и reverse route. Четвёртый — application outcome: TTFB, token cadence, завершение ответа и освобождение backend slot.
На каждом gate нужен healthy negative control. Возьмите соединение к тому же endpoint через другой gateway или тот же gateway к стабильному backend. Сравнивайте дельты за одинаковое окно, а не абсолютные counters с момента boot. Десять тысяч retransmissions на давно живущем узле могут быть нормальнее, чем пять новых retransmissions за одну проблемную секунду.
Связка должна быть причинной: loss evidence появляется на конкретном сокете, capture показывает соответствующий gap, а свежий запрос получает паузу в тот же момент. Если совпадает лишь один слой, диагноз преждевременный. Такая дисциплина защищает и от бессмысленной смены сервера, и от рискованного глобального sysctl.
Сразу договоритесь и о stop condition расследования. Если повторяемый socket gap не найден после нескольких проблемных запросов, не расширяйте tcpdump бесконечно: переходите к proxy и application evidence. Если capture доказывает loss до ingress, не меняйте backend. Если loss виден только после gateway, не обвиняйте клиентский ISP. Такая «граница достаточности» экономит время и уменьшает риск того, что несколько команд одновременно изменят разные слои. В отчёте оставляйте не только положительные находки, но и negative controls: они показывают, какие гипотезы уже исключены, и не дают следующей смене начать с нуля.
Снимаем baseline Linux без изменения параметров
Начните с чтения текущих значений. В актуальной документации Linux IP sysctl net.ipv4.tcp_recovery — bitmap; значение по умолчанию 0x1 включает RACK. Там же отмечено, что сброс бита 0x1 сейчас не меняет поведение, потому что RACK является единственным поддерживаемым loss detection algorithm. Бит 0x2 делает reordering window статическим, а 0x4 отключает DUPACK threshold heuristic. Это экспериментальные рычаги, а не чек-лист «включить всё».
net.ipv4.tcp_early_retrans управляет TLP: значения 3 или 4 включают его, и документация подчёркивает зависимость от RACK. tcp_sack обычно включён. tcp_reordering задаёт начальный уровень, а tcp_max_reordering — верхнюю границу динамической адаптации. На ECMP или bonding rr reordering может быть реальным свойством пути, поэтому статическое уменьшение окна способно превратить поздние пакеты в ложные потери.
Для сокета используйте ss -tinmo: -i показывает внутреннюю TCP-информацию, -o — активный timer, -m — память. По man page ss, timer on может означать retransmission, early retransmit или TLP; значит, одно слово не идентифицирует механизм. Читайте его рядом с RTO, backoff, RTT и retrans.
Полезно сопоставить baseline с материалом про TCP buffers и backpressure: большой send buffer и retransmission — разные факты. Если userspace продолжает писать, а peer медленно читает, вы можете увидеть задержку без сетевой потери.
uname -r
sysctl net.ipv4.tcp_recovery
sysctl net.ipv4.tcp_early_retrans
sysctl net.ipv4.tcp_sack
sysctl net.ipv4.tcp_reordering
sysctl net.ipv4.tcp_max_reordering
ss -tinmo dst 203.0.113.20:443
Как читать ACK, SACK и таймеры вместе
Один snapshot ss почти всегда недостаточен. Снимите серию с известным интервалом и параллельно запустите capture на owner hop. Ищите не retransmission вообще, а последовательность: исходный segment, более поздний SACK или отсутствие ACK, probe, retransmit, затем application progress. В проде capture ограничивают host, port и временем; payload для TLS всё равно зашифрован, но sequence/ACK timing остаётся полезным.
RACK делает вывод по времени последней передачи. Если сегмент, отправленный позже, подтверждён, более ранний неполученный сегмент может быть признан потерянным после reordering window. Это лучше работает с маленькими flights, но требует осторожности при reordering. DSACK особенно ценен: он может показать, что оригинал и retransmission оба достигли peer, то есть «потеря» могла быть ложной или ACK задержался.
Смотрите на reverse path отдельно. Клиент получил данные, но его ACK задержался из-за перегруженного uplink; отправитель видит неполученные подтверждения и запускает recovery. Capture только на sender оставит двусмысленность. Два capture по сторонам подозрительного hop превращают догадку в доказательство: пакет вышел, вошёл или исчез между точками.
Не забывайте об offload. GRO/GSO/TSO меняют вид пакетов на host capture, но не отменяют wire behavior. Подробная граница описана в статье про GRO, GSO и TSO. Снимок до NIC и зеркалирование на switch могут показывать разную сегментацию — это ожидаемо, а не автоматический признак corruption.
peer=203.0.113.20
port=443
for i in 1 2 3 4 5; do
  date --iso-8601=ns
  ss -tinmo dst "$peer:$port"
  sleep 1
done
timeout 30 tcpdump -ni any "host $peer and tcp port $port" -w rack-canary.pcap
Отличаем настоящую потерю от reordering и delayed ACK
Потеря и reordering дают похожий промежуточный кадр: более новый sequence range уже подтверждён, ранний ещё нет. Разница раскрывается позже. При reordering оригинальный сегмент может прийти без retransmit; при spurious retransmission DSACK сообщит о дубликате. Поэтому verdict нельзя выносить по одному SACK block.
Типичная причина reordering — per-packet load balancing или bonding round-robin. ECMP по стабильному flow hash обычно сохраняет порядок внутри одного 5-tuple, но смена пути, асимметрия или нестабильная entropy всё равно могут проявиться. Проверьте, совпадают ли проблемные соединения с конкретным next hop, NIC queue или tunnel. Сравните проблемный flow со здоровым flow на том же узле.
Delayed ACK тоже усложняет TLP recovery detection. RFC 8985 отдельно отмечает, что sender должен дать receiver достаточно времени перед probe, а ACK loss без DSACK делает алгоритм консервативным. Практически это означает: не называйте probe «лишним» только потому, что оба data packet видны на receiver. Проверьте, когда ACK вышел и когда дошёл.
Для контролируемой лаборатории допустим tc netem, но только в отдельном namespace или тестовом gateway. Не ставьте loss/reorder на production root qdisc. Сценарий должен воспроизводить один механизм: сначала loss, затем reordering, затем clean control. Иначе вы не узнаете, какое условие изменило outcome.
# LAB ONLY: use an isolated test interface
tc qdisc replace dev veth-test root netem loss 0.5%
# run fixed requests and save ss, capture, application timings
tc qdisc replace dev veth-test root netem delay 10ms reorder 10% 50%
# restore clean control
tc qdisc del dev veth-test rootЧто можно менять, а что лучше оставить в покое
Без доказанного дефекта лучший default — не менять tcp_recovery. Современный Linux уже использует RACK, а TLP включён стандартным режимом tcp_early_retrans. Переключение bitmap на всём fleet создаёт новую переменную и может изменить реакцию на reordering, не устранив policer или потерю ACK.
Статический reordering window нужен только для хорошо понятного пути. На динамическом WAN или фабрике со сменой маршрутов адаптация полезнее. Отключение DUPACK heuristic также должно быть гипотезой canary, а не «рекомендованным ускорением». Документация называет эти возможности experimental; фиксируйте версию ядра, потому что детали реализации и counters меняются.
Не используйте tcp_retries2 как регулятор p99. Он управляет долгим abort behavior живого соединения при RTO retransmissions; снижение может быстрее рвать пользовательские ответы, но не ускоряет loss detection. Для half-open semantics существует per-socket TCP_USER_TIMEOUT, и у нас есть отдельный production-runbook по TCP_USER_TIMEOUT.
Ещё одна ловушка — одновременно менять qdisc, congestion control, RACK bits и proxy timeouts. Даже улучшение ничего не докажет. Один canary, один owner, один параметр. В change record сохраняйте исходное значение, kernel version, socket evidence и критерий rollback. Так следующий инженер сможет повторить наблюдение, а не верить устному «стало быстрее».
Версионная проверка обязательна ещё по одной причине: sysctl описывает глобальный default, но конкретное приложение может задавать socket options, а container может работать в другом network namespace. Читайте значение там, где живёт сокет, и проверяйте, унаследовал ли listener нужные настройки для новых соединений. Изменение host namespace не гарантирует эффект для уже открытого connection. Поэтому любой canary должен пересоздать соединение и записать kernel release, namespace inode и PID владельца. Иначе вы можете получить «нулевой эффект» просто потому, что тестировали старый socket, а затем ошибочно решить, что RACK или TLP не работает.
A/B/A canary: проверяем recovery, а не надежду
Хороший canary начинается с A: baseline на одном gateway и параллельный healthy control на другом. Используйте свежие соединения, иначе connection pooling сохранит прежние route, congestion window и socket options. Запишите распределения TTFB, межтокенных пауз и completion rate, а рядом — дельты retrans, DSACK, RTO/backoff и path counters.
На фазе B меняйте ровно одного owner. Например, закрепите трафик на одном ECMP path или примените проверяемый kernel knob только к canary-узлу. Stop condition задаётся заранее: рост completion errors, RTO episodes, CPU softirq, backend occupancy или ухудшение control. Без stop condition эксперимент легко продолжается потому, что «нужно ещё данных».
Фаза A после rollback обязательна. Верните исходное состояние и повторите те же probes на новых соединениях. Если эффект исчез вместе с изменением и вернулся после повторного B в отдельном окне, причинная связь становится сильнее. Если p99 остался лучше после rollback, возможно, вы поймали смену нагрузки или прогрев cache.
Проверяйте, куда мигрировал bottleneck. Более быстрое TCP recovery может освободить клиентский stream, но увеличить burst на proxy, TLS CPU или GPU queue. Успех — это application outcome и освобождение capacity, а не только меньшее число RTO. Именно поэтому rollback повторяет те же четыре evidence gate.
before=$(sysctl -n net.ipv4.tcp_recovery)
printf '%s
' "$before" > /var/tmp/tcp_recovery.before
# apply one reviewed canary value here, then open fresh connections
sysctl -w "net.ipv4.tcp_recovery=$(cat /var/tmp/tcp_recovery.before)"
# repeat the same ss, capture and application probes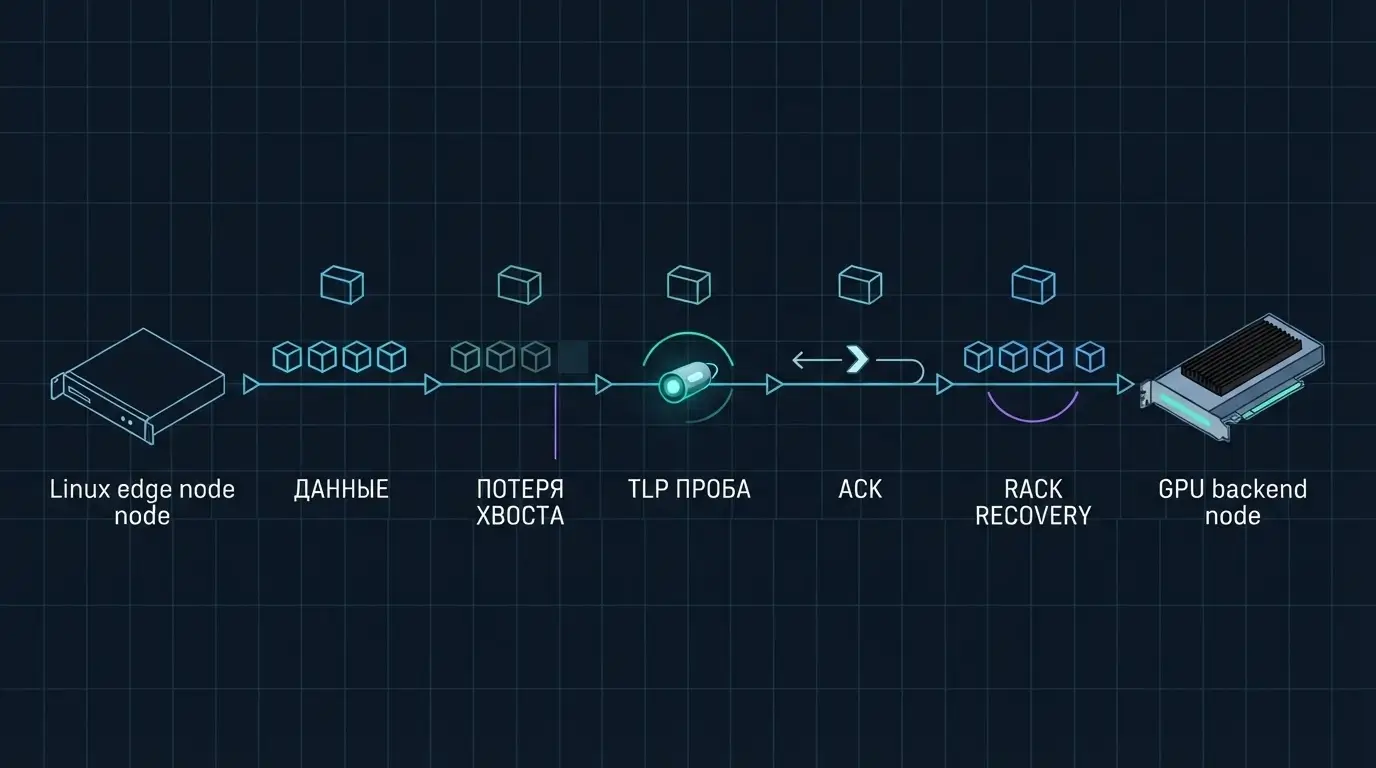
Когда проблема действительно упирается в инфраструктуру
Смена VPS или переход на dedicated server оправданы после доказанного control gap. Примеры: вы не управляете NIC queues и driver version, noisy neighbor создаёт повторяемые jitter/loss на host boundary, NUMA placement не контролируется, у платформы нет нужной path telemetry, а rollback зависит от чужого окна. Тогда более предсказуемый kernel/NIC baseline имеет коммерческую и техническую ценность.
Но новое железо не исправит poor flow hash, внешний policer, асимметричный route, proxy buffering или очередь на GPU. Это обязательный disqualifier. Перенос такого workload просто воспроизведёт симптом на более дорогой машине, а расследование начнётся заново уже с новым набором переменных.
Сравнивайте варианты по ownership, а не по абстрактной «мощности». На VPS проще масштабировать edge horizontally и изолировать canary, но меньше контроля над physical NIC. Dedicated даёт предсказуемые queues, IRQ/NUMA placement и change window, зато требует своей операционной дисциплины. Managed load balancer снимает часть L4 ownership, но ограничивает доступ к per-socket и wire evidence.
Для соседнего слоя пригодится runbook по RSS, RPS и IRQ affinity. Если retransmissions коррелируют с RX drops и softirq saturation на одной очереди, это уже не абстрактная «сеть медленная», а проверяемый resource/control gap. Именно после такого доказательства стоит обсуждать класс инфраструктуры King Servers.
До закупки сформулируйте проверяемое требование. Не «нужна сеть быстрее», а, например, доступ к per-queue NIC counters, возможность закрепить IRQ и workload в одном NUMA node, контролируемая версия driver/firmware, packet mirror на edge и независимое окно rollback. Затем сопоставьте эти требования с VPS, dedicated или managed L4. Если текущая платформа уже даёт нужные controls, миграция не является первым шагом. Если не даёт, evidence bundle становится техническим обоснованием выбора, а не эмоциональной реакцией на p99. Это также помогает King Servers подобрать конфигурацию по ownership и failure domain, а не только по числу ядер.
Короткий runbook и вывод
Перед закрытием инцидента сохраните минимальный пакет артефактов: версии kernel и iproute2, исходные sysctl, две стороны capture, socket cookie, route/namespace context, application trace и результат rollback. Не обязательно хранить полный payload; достаточно метаданных, которые позволяют связать sequence timing с запросом. Добавьте короткий verdict в форме «наблюдение → исключённые причины → подтверждённый owner → изменение → повторная проверка». Такой формат переживает смену дежурной команды и подходит для следующего похожего эпизода. Через неделю повторите контрольный запрос без искусственной нагрузки: конфигурация могла сохраниться, а path — измениться. Если результат не воспроизводится, пометьте вывод как ограниченный конкретным маршрутом и окном, а не как универсальный tuning recipe.
Сначала подтвердите симптом на fresh connection и отметьте точный owner TCP hop. Затем снимите два и более ss -tinmo snapshot, packet capture по обе стороны подозрительного участка и application timings. Разведите RACK evidence, TLP probe и RTO fallback; не называйте общий retrans counter причиной.
Следом проверьте альтернативы: reordering, delayed или потерянный ACK, offload-границу, policer, proxy buffering, HTTP/2 flow control и GPU queue. Для каждого подозрения используйте healthy negative control. Если сеть чистая, честный вывод «не network loss» полезнее красивого sysctl.
Менять настройки можно только после evidence gate. Один canary owner, один параметр, заранее заданные stop conditions, затем симметричный A/B/A rollback. Kernel documentation показывает, что RACK и TLP обычно уже активны; поэтому задача инженера чаще состоит не во «включении RACK», а в доказательстве того, какой recovery path случился и помог ли он пользователю.
Главная мысль проста: tail latency — это цепочка, а не один counter. Свяжите сокет, ACK/SACK, фактический путь и результат приложения. После этого станет понятно, нужен ли route fix, proxy change, kernel canary или инфраструктура с более жёстким NIC/NUMA ownership. Начните с короткого evidence bundle на одном проблемном соединении — он быстро отделит потерю пакета от удобной, но дорогой догадки.
И ещё одно практическое правило: не переносите лабораторные проценты loss или reordering в production SLO. Они нужны для воспроизводимости механизма, а не для прогноза реальной сети. Production verdict строится только на фактических дельтах вашего пути, вашего kernel и вашего LLM workload.