Оглавление
- Короткий вердикт: когда Inference Extension действительно нужен
- Почему round-robin ломается на длинных LLM-запросах
- Как устроен путь запроса: Gateway, HTTPRoute, EPP и InferencePool
- Версия v1.6.2: что стабильно, а что нельзя принимать за production default
- Минимальная конфигурация: начните с однородного пула
- Три evidence gate: desired state, effective routing и application outcome
- Canary rollout: меняйте один routing layer за раз
- Какие метрики отделяют хороший picker от красивой схемы
- Failure modes: FailOpen, 429, 503 и stale state
- Service, InferencePool или llm-d router: практическая матрица выбора
- Где заканчивается routing и начинается capacity planning
- Production-чеклист: что должно быть записано в runbook
- Вывод: сначала доказательство, затем умная маршрутизация
Готовы перейти на современную серверную инфраструктуру?
В King Servers мы предлагаем серверы как на AMD EPYC, так и на Intel Xeon, с гибкими конфигурациями под любые задачи — от виртуализации и веб-хостинга до S3-хранилищ и кластеров хранения данных.
- S3-совместимое хранилище для резервных копий
- Панель управления, API, масштабируемость
- Поддержку 24/7 и помощь в выборе конфигурации
Результат регистрации
...
Создайте аккаунт
Быстрая регистрация для доступа к инфраструктуре
Короткий вердикт: когда Inference Extension действительно нужен
Default-решение простое: не меняйте обычный Kubernetes Service, пока не доказали, что равномерное сетевое распределение создаёт перекос именно для LLM inference. Gateway API Inference Extension полезен там, где запросы различаются длиной prompt, состоянием KV cache, наличием LoRA-адаптера, очередью и стоимостью обработки. В таком пуле две формально одинаковые реплики через минуту уже находятся в разном состоянии.
Проект строит model-aware routing поверх Gateway API: HTTPRoute выбирает backend-пул, а Endpoint Picker (EPP) предлагает конкретный model-server endpoint. Официальная документация называет InferencePool стабильным API начиная с v1.0.0; актуальный на дату материала patch-релиз проекта — v1.6.2. Это важная граница: стабильность API не означает, что любая reference-реализация EPP автоматически готова к вашему production.
Qualifying condition — наблюдаемый hotspot: одна реплика копит pending requests или теряет cache locality, пока соседняя простаивает. Disqualifier — bottleneck в клиентском connection pool, gateway CPU, сетевой очереди, storage cold start или самой модели. Новая схема маршрутизации это не исправит. Если симптомы пока смешаны, начните с измерений и только потом добавляйте новый control plane.
Почему round-robin ломается на длинных LLM-запросах
Обычный балансировщик видит endpoints, readiness и соединения, но не знает, сколько токенов уже генерирует каждая реплика и насколько полезен её cache для следующего prompt. Короткий health check может быть зелёным, когда внутри model server уже растёт очередь. При SSE или gRPC streaming соединение остаётся занятым дольше обычного HTTP-запроса, поэтому счётчик соединений тоже не всегда отражает реальную работу GPU.
Представьте четыре vLLM-пода. На первый попали два длинных запроса с большим контекстом, на второй — серия коротких completion, третий держит нужный LoRA-адаптер, четвёртый только прогрел веса. Round-robin продолжит ходить по кругу. Model-aware picker может учитывать eligibility, queue state, cache или adapters, но только если production-реализация получает достоверные metrics and capabilities от model servers.
Не смешивайте network latency и model latency. В статье про BBR и fq для LLM-стриминга сетевой queue проверяется отдельно от TTFT. Здесь действует тот же принцип: снижение времени выбора endpoint ещё не доказывает снижение TTFT, а ровный GPU utilization не гарантирует отсутствие 5xx. Нужны независимые evidence gates.
Как устроен путь запроса: Gateway, HTTPRoute, EPP и InferencePool
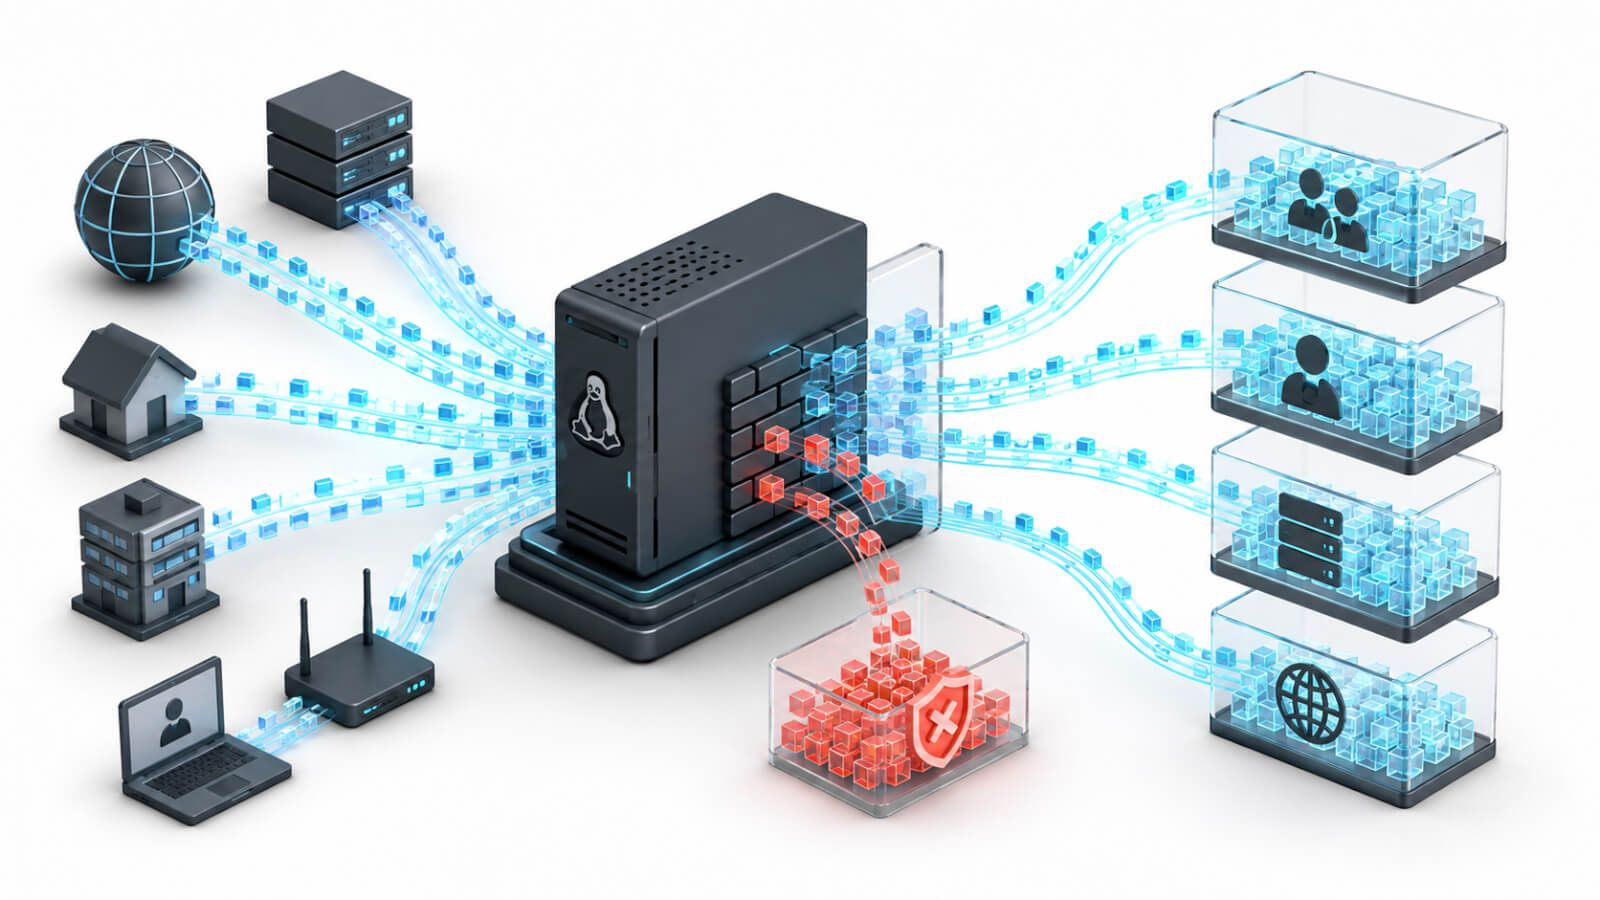
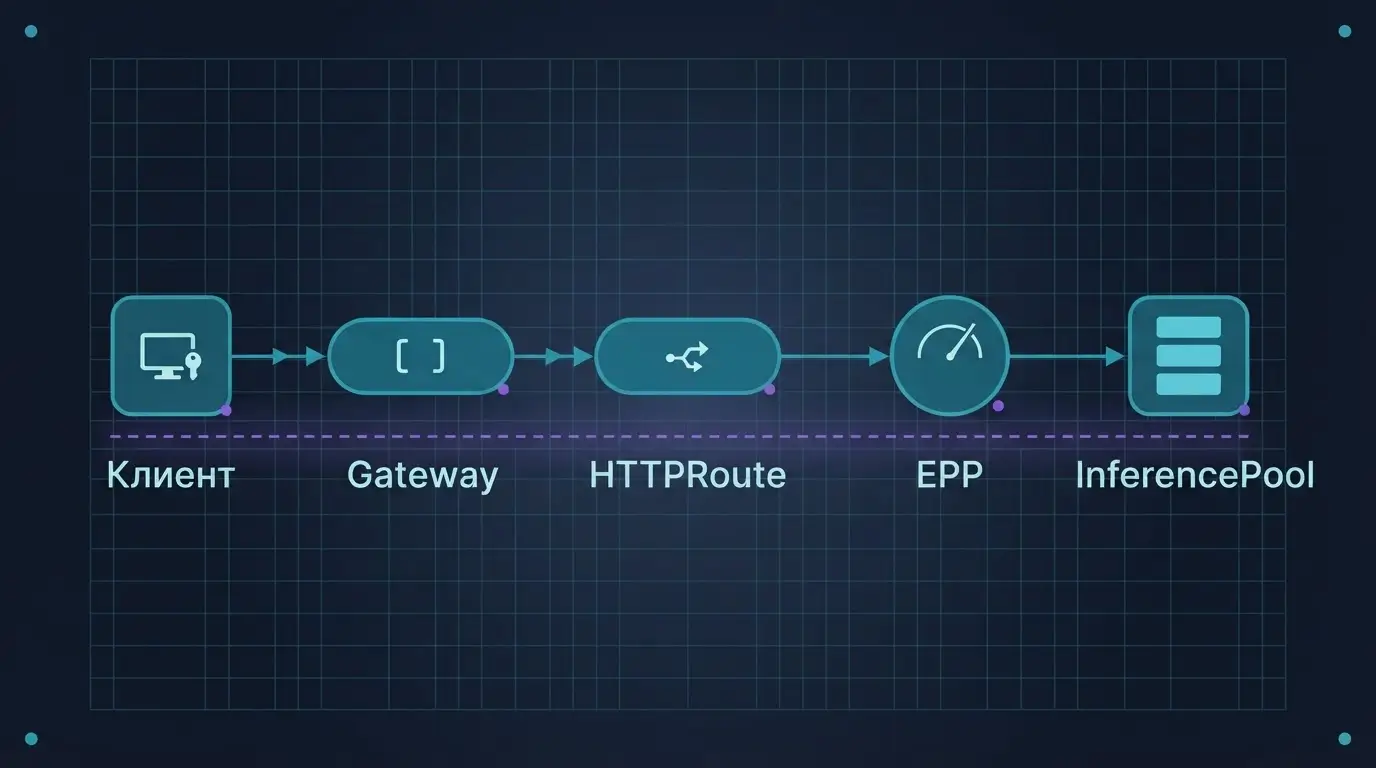
Путь начинается привычно: Gateway принимает HTTP-запрос, а HTTPRoute выбирает backend. Если backend — InferencePool, gateway вызывает endpoint selection extension для этого пула. EPP оценивает доступный набор endpoints, возвращает один или несколько адресов, после чего data plane направляет запрос к выбранной реплике. Официальное описание request flow именно так разделяет ответственность маршрута и выбора конкретного model server.
InferencePool принадлежит platform owner: selector описывает группу однородных Pods, targetPorts — целевой порт, endpointPickerRef — связь с picker service. Один EPP относится к одному пулу, но HTTPRoute может ссылаться на несколько пулов. Это полезно для canary разных моделей или hardware profiles, однако backend failover и endpoint retry остаются разными механизмами; их нельзя объединять в один непрозрачный retry policy.
Endpoint Picker Protocol использует Envoy ext_proc. Для streaming EPP обязан поддерживать full-duplex обработку; выбранный endpoint передаётся data plane через согласованные header/metadata. Если список endpoints исчерпан, протокол предусматривает 503, а для осознанного shedding — 429. Практический вывод: gateway logs должны позволять связать request id, pool, выбранный endpoint и финальный backend, иначе схема неотлаживаема.
Есть ещё организационная граница. HTTPRoute обычно контролирует networking-команда, InferencePool — platform-команда, а model-server labels и adapters — ML platform. Если один владелец меняет selector, а другой не видит rollout модели, EPP получает технически валидный, но семантически неправильный набор endpoints. Зафиксируйте контракт labels и targetPorts так же строго, как API между сервисами: изменение label schema должно проходить canary и review обеих команд.
Версия v1.6.2: что стабильно, а что нельзя принимать за production default
На 21 сентября 2026 года последний release — v1.6.2. Он исправляет reference в conformance manifest и включает fixes Lightweight EPP из v1.6.1: порядок ext_proc stream events для chunked body, body mutation в FULL_DUPLEX_STREAMED и multi-arch сборку для linux/arm64. Если тесты запускаются с v1.6.1 manifest, они могли незаметно поднять образ v1.6.0; именно это исправлено в v1.6.2.
Главное изменение ветки v1.6 произошло раньше: полнофункциональные EPP, Body-Based Routing и Latency Predictor переехали в экосистему llm-d. Сам репозиторий GAIE сосредоточился на спецификациях, CRD и conformance, а LWEPP позиционируется как минимальная reference-реализация для проверки совместимости. Поэтому формула «установили официальный chart — получили production scheduler» неверна.
InferencePool v1 стабилен, а endpointPickerRef начиная с v1.5 может быть optional. Но поддержка omission зависит от конкретного gateway implementation. Проверяйте документацию controller, supported features и conformance report. Не полагайтесь только на то, что Kubernetes API принял объект: admitted resource ещё не доказывает, что data plane применил inference-aware behavior.
kubectl api-resources | grep -E 'InferencePool|HTTPRoute'
kubectl get crd inferencepools.inference.networking.k8s.io   -o jsonpath='{.spec.versions[*].name}{"\n"}'
kubectl -n inference-system get deploy,pod   -o custom-columns='KIND:.kind,NAME:.metadata.name,IMAGE:.spec.template.spec.containers[*].image'
kubectl get gatewayclass,gateway,httproute -A
Минимальная конфигурация: начните с однородного пула
Первый canary должен быть скучным. Возьмите одну модель, одинаковый accelerator type, одинаковый model-server image и один target port. Не добавляйте одновременно LoRA, heterogeneous GPU, prefix-cache routing и новый autoscaler: если результат изменится, вы не поймёте, какой механизм сработал.
Ниже — форма InferencePool из официального примера. Selector должен точно совпасть с labels model-server Pods. В примере FailOpen означает: если EPP не отвечает или не выбирает endpoint, gateway может отправить запрос к endpoint, выбранному своим fallback-механизмом. Это повышает availability, но скрывает деградацию model-aware routing, поэтому нужен отдельный alert на fallback.
apiVersion: inference.networking.k8s.io/v1
kind: InferencePool
metadata:
  name: vllm-qwen3-32b
  namespace: llm-canary
spec:
  selector:
    matchLabels:
      app: vllm-qwen3-32b
  targetPorts:
    - number: 8000
  endpointPickerRef:
    name: vllm-qwen3-32b-epp
    port:
      number: 9002
failureMode: FailOpenДо привязки HTTPRoute проверьте три вещи: все выбранные Pods действительно готовы; EPP видит тот же набор endpoints; порт model server доступен с data plane. Типичная ловушка — selector выбрал лишнюю реплику из соседнего rollout или не выбрал ничего из-за различия labels. Проверяли ли вы фактический список адресов, а не только YAML в Git?
Для более общей архитектуры Kubernetes inference используйте материал про KServe, GPU Operator, Kueue и autoscaling. Здесь scope уже: мы меняем только путь выбора backend и сохраняем стабильный Service как контроль.
Три evidence gate: desired state, effective routing и application outcome
Успешный apply — это только desired state. Первый gate проверяет API: InferencePool существует, conditions не содержат отказа, HTTPRoute принят нужным parent и backendRef разрешён. Ошибка ReferenceGrant, неподдерживаемый group/kind или несовпадающий namespace должна остановить rollout до трафика.
Второй gate — effective state. Нужны logs или traces, где видны pool, вызов EPP, предложенный endpoint и endpoint, который фактически обслужил запрос. Протокол специально передаёт served endpoint обратно EPP, потому что data plane может идти по упорядоченному списку при retry. Если наблюдаемость показывает только «200 от gateway», вы не доказали работу picker.
Третий gate — workload outcome. Сравнивайте TTFT, inter-token latency, end-to-end latency, ошибки и saturation каждого model server. Добавьте negative control: тот же набор запросов через обычный Service. Если EPP меняет распределение endpoints, но SLO не улучшается, причина могла находиться в model compute, client concurrency или gateway path. Это нормальный результат эксперимента, а не повод придумывать выигрыш.
kubectl -n llm-canary get inferencepool vllm-qwen3-32b -o yaml
kubectl -n llm-canary describe httproute llm-canary
kubectl -n llm-canary logs deploy/vllm-qwen3-32b-epp --since=10m
curl -sS -D /tmp/canary.headers   -H 'content-type: application/json'   --data @request.json https://canary.example/v1/chat/completions
curl -sS -D /tmp/baseline.headers   -H 'content-type: application/json'   --data @request.json https://baseline.example/v1/chat/completions
Canary rollout: меняйте один routing layer за раз
Безопасный rollout строится рядом с текущим path. Оставьте baseline HTTPRoute на Service, создайте отдельный hostname или header match для InferencePool и подайте небольшой репрезентативный поток. Canary должен включать короткие и длинные prompts, streaming, cancellation и запросы к моделям/адаптерам, которые реально используют клиенты.
Не начинайте с процента трафика, который невозможно быстро отличить в telemetry. Удобнее отдельный route key, tenant или тестовый hostname: так каждый request однозначно относится к canary. Затем можно перейти к weighted routing, если controller поддерживает нужный сценарий. Stop conditions задайте заранее: рост 5xx/429, ухудшение TTFT относительно baseline, EPP not ready, рассинхронизация endpoints или повторяющийся fallback.
Rollback должен быть симметричным: вернуть backend на Service, убедиться, что новые запросы идут по baseline, дождаться drain активных streams и повторить тот же application probe. Не удаляйте EPP первым: вы потеряете evidence о текущих запросах. Подход похож на graceful drain в runbook по HTTP/2 GOAWAY и gRPC keepalive: сначала перестаём назначать новую работу, затем наблюдаем завершение уже принятой.
kubectl -n llm-canary patch httproute llm-canary --type merge   -p '{"spec":{"rules":[{"backendRefs":[{"name":"vllm-baseline","port":8000}]}]}}'
kubectl -n llm-canary get httproute llm-canary -o yaml
kubectl -n llm-canary logs deploy/vllm-qwen3-32b-epp --since=5m
curl -sS --data @request.json   -H 'content-type: application/json'   https://canary.example/v1/chat/completions
Какие метрики отделяют хороший picker от красивой схемы
Метрики делятся на четыре слоя. Gateway layer: request rate, 4xx/5xx, upstream connect failures, ext_proc latency и timeouts. EPP layer: decisions, eligible endpoints, pick errors, fallback, readiness и возраст данных. Model-server layer: running/pending requests, KV-cache pressure, tokens per second и cancellations. Application layer: TTFT, inter-token latency, completion success и пользовательский timeout.
Связь между слоями важнее отдельного dashboard. Например, TTFT растёт, EPP быстро отвечает, но pending requests концентрируются на одном pod. Это указывает на eligibility/scoring или stale metrics. Другой случай: распределение ровное, но ext_proc latency выросла — bottleneck появился в control path. Третий: gateway и EPP здоровы, а все GPU насыщены; маршрутизация уже не создаст capacity.
Добавьте trace attributes: pool, requested model, selected endpoint, served endpoint, fallback reason и rollout cohort. При этом не пишите prompts и чувствительные payloads в обычные логи. Для host/network диагностики полезен eBPF observability, но eBPF подтверждает transport/kernel mechanism, а не качество выбора модели. Application canary остаётся финальным доказательством.
Failure modes: FailOpen, 429, 503 и stale state
FailOpen сохраняет доступность, когда EPP недоступен, но gateway теряет интеллектуальный выбор. Это разумный default для первого canary, если fallback endpoint безопасен. Цена — silent degradation: без метрики fallback команда может неделями считать, что model-aware routing работает. FailClosed лучше сохраняет семантику policy, но превращает EPP в жёсткую зависимость request path.
429 и 503 означают разные вещи. 429 может быть осознанным load shedding при тяжёлой нагрузке; клиенту нужен ограниченный retry с backoff и idempotency. 503 используется, когда подходящих endpoints нет. Бесконтрольный retry обоих кодов создаёт feedback loop: очередь растёт именно из-за реакции клиента. Укажите retry owner и budget на одном уровне, а не одновременно в SDK, gateway и service mesh.
Stale state опаснее явного падения. EPP отвечает быстро, но принимает решение по старым queue/cache данным. Проверяйте age метрик и сравнивайте picked endpoint с фактическим served endpoint. Ещё одна ловушка — mixed versions: CRD уже новая, controller старый, а data plane не поддерживает поле или режим streaming. Именно поэтому version lock должен включать API, controller, gateway и router images.
- Нет ready endpoints: остановить canary и проверить selector/readiness.
- EPP not ready: проверить datastore sync и leader state.
- 500 на chunked streaming: сверить ext_proc implementation и patch release.
- Рост 429: отделить корректный shedding от stale saturation signal.
- Fallback без алерта: считать это дефектом observability.
Отдельно проверяйте cancellation. Пользователь может закрыть streaming response, но backend продолжит генерацию, если отмена не проходит через gateway и model server. Тогда endpoint выглядит занятым, хотя с точки зрения клиента запрос уже исчез. Такой «невидимый» compute меняет queue metrics и вводит picker в заблуждение. В canary включите раннее закрытие соединения и убедитесь, что served endpoint освобождает ресурсы.
При multi-backend HTTPRoute не переносите endpoint list между пулами. Endpoint Picker Protocol привязывает упорядоченный список к конкретному InferencePool; если route-level failover выбирает другой pool, data plane должен вызвать его EPP заново. Иначе retry может попасть на endpoint с другой моделью или hardware policy. Это особенно важно при blue-green версии модели, где оба пула отвечают на совместимый API, но имеют разные weights или adapters.
Service, InferencePool или llm-d router: практическая матрица выбора
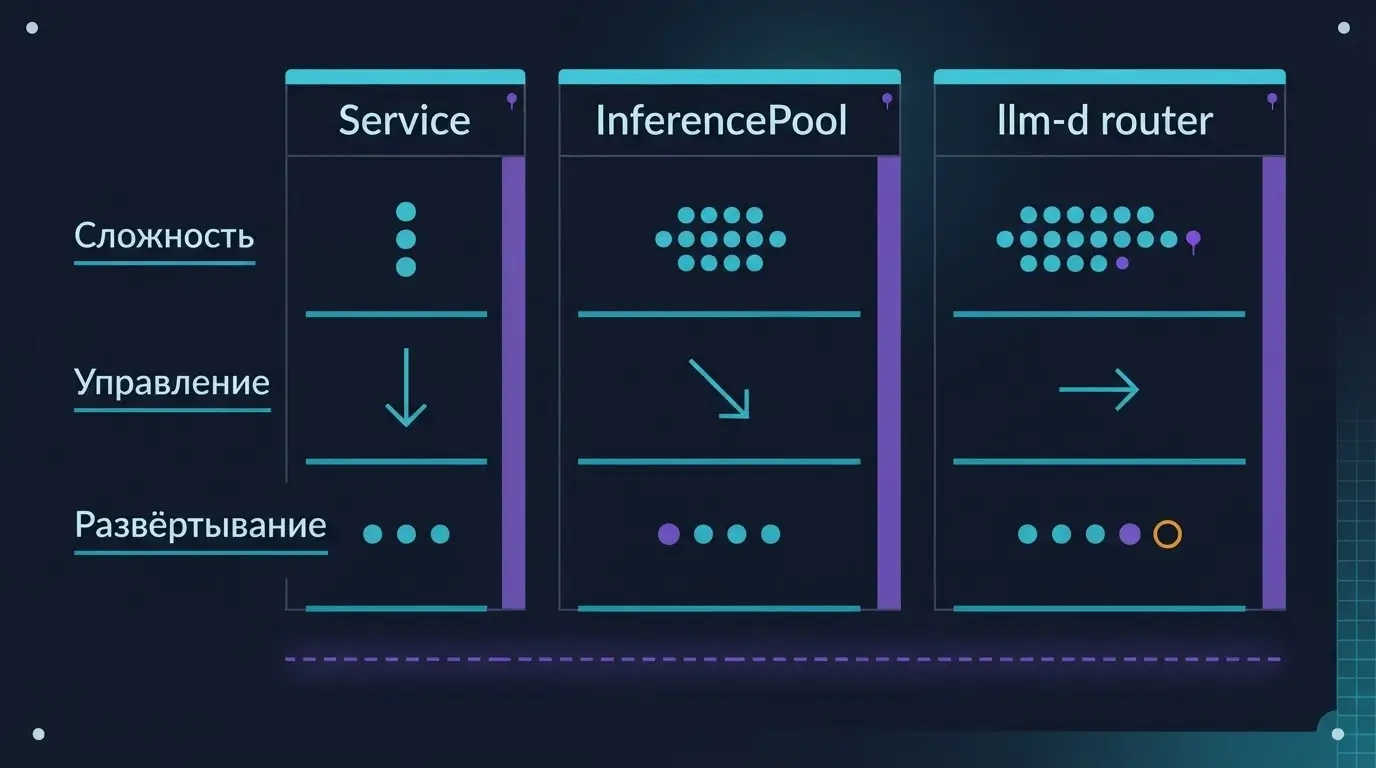
Service остаётся лучшим вариантом, когда replicas действительно взаимозаменяемы, нагрузка короткая, cache locality не влияет на SLO, а команда не готова владеть дополнительным control path. Это не «упрощённая» архитектура, а корректный выбор при отсутствии qualifying condition.
InferencePool с минимальной реализацией полезен для conformance, лаборатории и проверки совместимости gateway. Он показывает API flow, но не заменяет production scheduler. Официальная документация прямо рекомендует для production собственный EPP или существующую реализацию, например llm-d-router.
Production router нужен, когда ценность доказана: model-aware eligibility, queue/cache signals, LoRA placement, приоритеты или сложный rollout. Вместе с возможностями вы получаете ownership версий, metrics freshness, failure policy, capacity EPP и on-call. Не выбирайте самый сложный вариант только потому, что он «AI-native».
Коммерческий вывод тоже должен быть честным. Выделенная инфраструктура полезна, когда нужно закрепить hardware profile, изолировать canary, контролировать network path и повторять тесты на предсказуемом GPU/CPU baseline. Но новый сервер не исправит stale metrics, ошибочный selector, unsafe retry или отсутствие client pooling.
Где заканчивается routing и начинается capacity planning
Model-aware routing перераспределяет работу, но не создаёт GPU memory, compute и network bandwidth. Если все replicas одновременно близки к saturation, picker лишь выбирает наименее плохой endpoint. Capacity plan должен учитывать модель, максимальный контекст, concurrency, KV-cache budget, batch policy и headroom на отказ одной реплики.
Разделите capacity gateway/EPP и model servers. Gateway может упереться в CPU, TLS, ext_proc connections или streaming buffers раньше GPU. EPP может требовать собственный HPA и PodDisruptionBudget, но масштабирование picker не должно менять смысл scoring. Model servers масштабируются по другой причине: pending requests, latency и accelerator pressure. Один общий CPU-based HPA для всей схемы обычно скрывает причинность.
Для private AI API добавьте границы доступа, quotas и tenant attribution; общий план разобран в материале о внутреннем аналоге OpenAI API. Здесь Inference Extension — только routing layer. Auth, billing, content policy и data governance остаются выше него.
На VPS удобно держать management-компоненты, тестовый gateway и observability, если нагрузка это позволяет. GPU model servers чаще требуют выделенного predictable hardware. Выбирайте инфраструктуру после canary evidence: сначала докажите bottleneck и нужную границу контроля, затем закрепляйте конфигурацию как воспроизводимый baseline.
Production-чеклист: что должно быть записано в runbook
Runbook обязан отвечать не только «как установить», но и «кто принимает решение при деградации». За API/CRD, gateway controller, EPP/router и model servers могут отвечать разные команды. У каждой зависимости нужен owner, версия, сигнал readiness, alert и способ отката.
- Version matrix: Kubernetes, Gateway API, controller, GAIE CRD, router и model server.
- Resource ownership: кто меняет InferencePool, HTTPRoute и scoring policy.
- Evidence chain: accepted object, effective picked/served endpoint, application SLO.
- Stop conditions: 5xx/429, EPP readiness, metric age, TTFT delta и fallback rate.
- Rollback: Service backend, drain, проверка baseline и сохранение incident bundle.
- Security: mTLS/NetworkPolicy для control path, минимальные RBAC и защита telemetry.
- Capacity: headroom gateway, EPP и GPU проверяются раздельно.
Сохраните before/after evidence: manifests, conditions, image digests, короткий срез logs, route status и результаты canary probes. Это сокращает спор во время инцидента. Через месяц команда должна суметь доказать, почему traffic идёт через InferencePool, а не просто обнаружить это по имени ресурса.
Проведите game day до расширения трафика: остановите EPP, сделайте один model server NotReady, задержите metrics source и верните старый HTTPRoute. Команда должна заранее увидеть ожидаемые сигналы и пройти rollback без редактирования manifests на ходу. Если fail-open выбран осознанно, тест обязан показать не только доступность API, но и явный alert о потере model-aware decisions.
Наконец, не смешивайте rollout приложения и rollout routing. Обновление модели, container image и InferencePool в одном change window делает rollback неоднозначным. Сначала стабилизируйте model servers за обычным Service, затем меняйте path выбора endpoint. При следующем обновлении повторите порядок: working baseline, canary нового слоя, evidence, расширение трафика.
Вывод: сначала доказательство, затем умная маршрутизация
Gateway API Inference Extension решает реальную проблему LLM-пулов: network-level round-robin не видит queue, cache, adapters и фактическую стоимость запроса. InferencePool v1 даёт стабильную Kubernetes-модель ресурса, а EPP добавляет выбор endpoint. Но в актуальной ветке v1.6 важно не перепутать спецификацию и conformance tooling с готовым production scheduler.
Начните с одного однородного пула и отдельного canary route. Зафиксируйте версии, проверьте API desired state, затем picked/served endpoint и только после этого TTFT, ошибки и saturation. Обязательно держите обычный Service как negative control и rollback path. Если улучшение не повторяется на application layer, вернитесь к baseline: возможно, bottleneck находится в client, gateway, сети или GPU capacity.
Следующий практический шаг — взять один реальный workload trace, прогнать его через Service и InferencePool и заполнить checklist из статьи. Когда evidence показывает устойчивый выигрыш и понятную границу владения, закрепляйте production router и подходящий infrastructure baseline. Если нужен изолированный стенд или предсказуемый GPU/сетевой профиль для такого canary, команда KingServers поможет подобрать конфигурацию без обещаний «ускорить всё» до измерений.