Оглавление
- Быстрый вердикт: DRA нужен не каждому GPU-кластеру
- Как работает DRA: четыре объекта вместо одного счётчика
- Версии, feature state и стоп-условия до установки
- Baseline и inventory: что снять до первого Helm upgrade
- Разворачиваем новый GPUCluster, не ломая рабочий pool
- ResourceClaimTemplate для inference-реплик
- Три evidence gate: API, node runtime, LLM
- Диагностика Pending без хаотичных рестартов
- Rollout и rollback: отдельные lanes, одинаковые проверки
- RBAC, квоты и наблюдаемость DRA
- Когда выделенная GPU-инфраструктура упрощает DRA
- Итог: мигрируйте договор выделения GPU, а не YAML
Готовы перейти на современную серверную инфраструктуру?
В King Servers мы предлагаем серверы как на AMD EPYC, так и на Intel Xeon, с гибкими конфигурациями под любые задачи — от виртуализации и веб-хостинга до S3-хранилищ и кластеров хранения данных.
- S3-совместимое хранилище для резервных копий
- Панель управления, API, масштабируемость
- Поддержку 24/7 и помощь в выборе конфигурации
Результат регистрации
...
Создайте аккаунт
Быстрая регистрация для доступа к инфраструктуре
Быстрый вердикт: DRA нужен не каждому GPU-кластеру
Если текущий inference стабильно получает целый GPU через nvidia.com/gpu, а команде не нужны фильтры по свойствам устройства, совместное использование claim или конфигурация на уровне workload, срочной миграции нет. Dynamic Resource Allocation меняет не скорость матричного умножения, а договор между планировщиком, драйвером и приложением. Польза появляется там, где «один GPU» уже слишком грубая единица описания.
Практический кандидат на DRA — платформа с несколькими типами ускорителей, отдельными SLA для команд и потребностью доказать, какой именно device получил Pod. Kubernetes описывает DRA как стабильный механизм начиная с v1.35; он использует DeviceClass, ResourceSlice и ResourceClaim, а драйвер готовит устройство для контейнера через CDI. При этом preemption для DRA-ресурсов пока не поддерживается: высокоприоритетный Pod может остаться Pending, пока занятый device не освободится. Это важный disqualifier для очередей, где приоритет должен немедленно вытеснять низкий класс нагрузки.
В этой инструкции мы не обещаем «бесшовную миграцию». Для актуального GPU Operator 26.7 и NVIDIA DRA Driver v0.5.0 официальный путь с объектом GPUCluster рассчитан на новую установку; переход in-place с ClusterPolicy не поддерживается. Поэтому рабочая стратегия — отдельный canary-кластер или новый GPU-pool с независимым control plane, воспроизводимым baseline и маршрутом отката. Общую картину Kubernetes-инференса полезно сверить с материалом про KServe, GPU Operator и autoscaling, но здесь фокус уже: только выделение GPU и evidence chain.
Как работает DRA: четыре объекта вместо одного счётчика
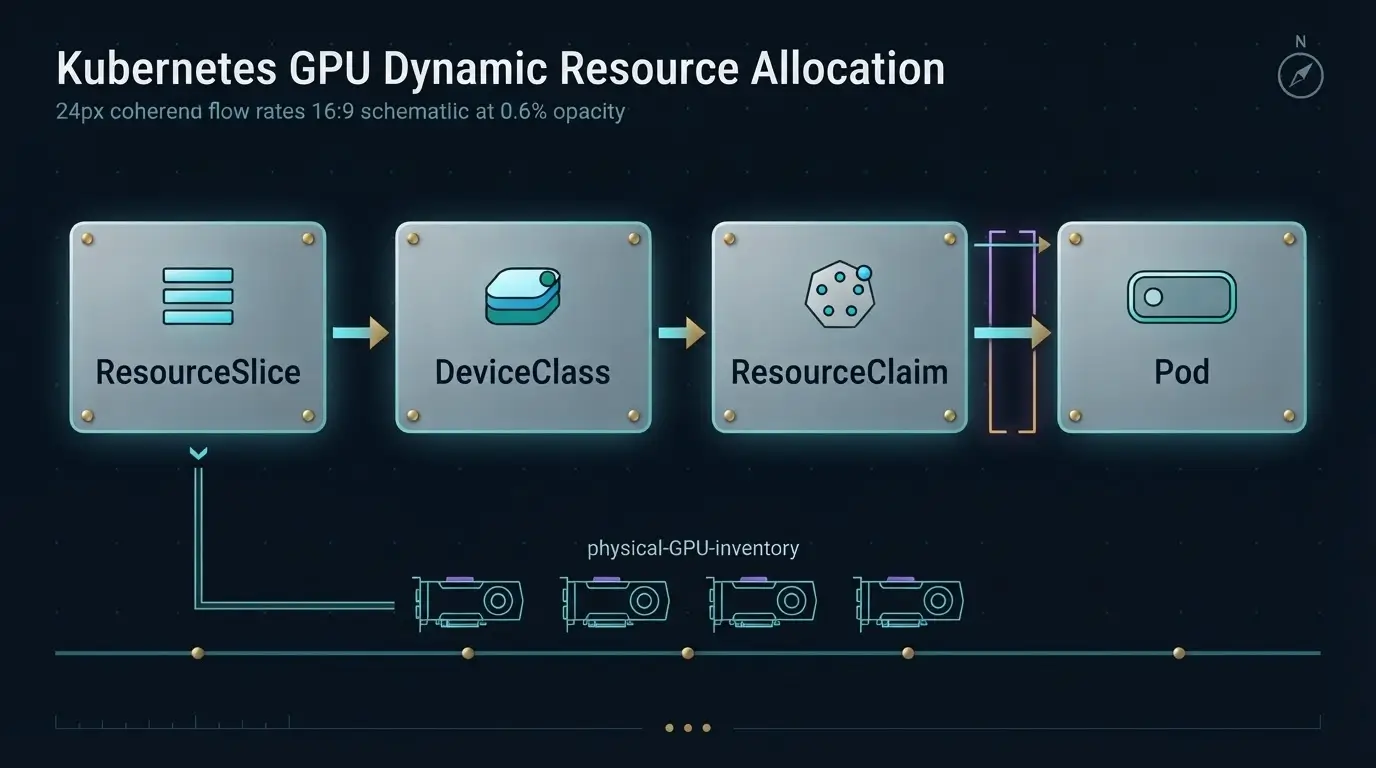
Device Plugin публикует extended resource, после чего Pod просит, например, один nvidia.com/gpu. Эта модель проста, но планировщик видит главным образом количество. DRA переносит описание устройства в API. Драйвер создаёт ResourceSlice с доступными devices и их атрибутами; администратор или vendor предоставляет DeviceClass; workload создаёт ResourceClaim либо ResourceClaimTemplate; scheduler выбирает подходящий device и записывает allocation в статус claim.
Такую цепочку удобно сравнить с динамическими томами. StorageClass описывает класс хранилища, PVC формулирует запрос, а control plane подбирает ресурс. В DRA роль PVC выполняет ResourceClaim, только объектом становится GPU, NIC, FPGA или другой device. Аналогия не полная: подготовку устройства на узле выполняет DRA driver через gRPC-вызовы kubelet, а доступ в контейнер обычно материализуется через CDI.
Главная operational-прибавка — наблюдаемость решения. При Pending можно отдельно спросить: рекламирует ли драйвер ResourceSlice, существует ли DeviceClass, создан ли claim, получил ли он allocation, зарезервирован ли за Pod и завершился ли NodePrepareResources. Это лучше, чем один симптом «Insufficient nvidia.com/gpu». Но объектов становится больше, а значит нужны RBAC, события, алерты и владелец каждого слоя.
Версии, feature state и стоп-условия до установки
На 15 сентября 2026 года upstream Kubernetes помечает core DRA как Stable с v1.35. Документация NVIDIA GPU Operator 26.7 для управляемого DRA-пути требует Kubernetes v1.34.2 или новее, API resource.k8s.io с DeviceClass, драйвер NVIDIA 580+ и runtime с CDI. Для нового проекта разумнее брать Kubernetes 1.36+ не из-за моды, а потому что DRAExtendedResource там включён по умолчанию и путь совместимости проще контролировать.
Не смешивайте стабильность core API со зрелостью каждой vendor-функции. NVIDIA прямо предупреждает, что часть возможностей DRA driver остаётся alpha. Например, VFIO passthrough требует отдельного alpha feature gate, а ComputeDomain предназначен для систем с Multi-Node NVLink вроде HGX GB200/GB300 и несёт собственные требования к IMEX. Если ваш inference живёт на обычных PCIe GPU в одном узле, отключение ComputeDomain уменьшит поверхность отказа.
Стоп-условия просты: существующий ClusterPolicy в целевом кластере, неподтверждённый CDI, version skew между control plane и kubelet, отсутствие тестового маршрута или невозможность вернуть трафик на старый pool. Не обходите их широкими правами и ручными правками сокетов. Отдельная статья про MIG и MPS помогает выбрать способ деления GPU, но DRA не превращает неподдерживаемый режим sharing в безопасный автоматически.
Baseline и inventory: что снять до первого Helm upgrade
До изменений сохраните evidence bundle. Нужны версии API server и kubelet, фактический драйвер на каждом GPU-узле, runtime config, наличие CDI spec, список GPU UUID, topology, текущие DaemonSet и ClusterPolicy. Отдельно снимите application baseline: время готовности реплики, успешность тестового запроса, используемая модель, GPU UUID внутри контейнера и ключевые DCGM-метрики. Это не benchmark для статьи, а ваша контрольная точка.
Записывайте не только «команда прошла», но и ожидаемую границу. Положительный тест: существующий Pod видит ровно тот GPU, который ему выделен. Отрицательный: соседний GPU недоступен, а workload с несовместимым селектором остаётся Pending с объяснимым событием. Именно отрицательный контроль ловит конфигурации, где контейнер случайно получил весь /dev/nvidia*.
Для canary выделите отдельный namespace, route и набор запросов. Не используйте первый production Pod как тестовый стенд. Если кластер уже занят jobs с checkpointing или online inference, заранее определите окно, владельца остановки и максимальную длительность Pending. Сравнивать нужно одинаковую модель и одинаковый профиль запроса; иначе изменение latency нельзя будет связать с DRA.
kubectl version
kubectl api-resources --api-group=resource.k8s.io
kubectl get nodes -o wide
kubectl get clusterpolicy
kubectl get pods -A -o wide | grep -E 'nvidia|gpu'
kubectl get deviceclass,resourceslice,resourceclaim -A
nvidia-smi --query-gpu=uuid,name,driver_version,pci.bus_id --format=csv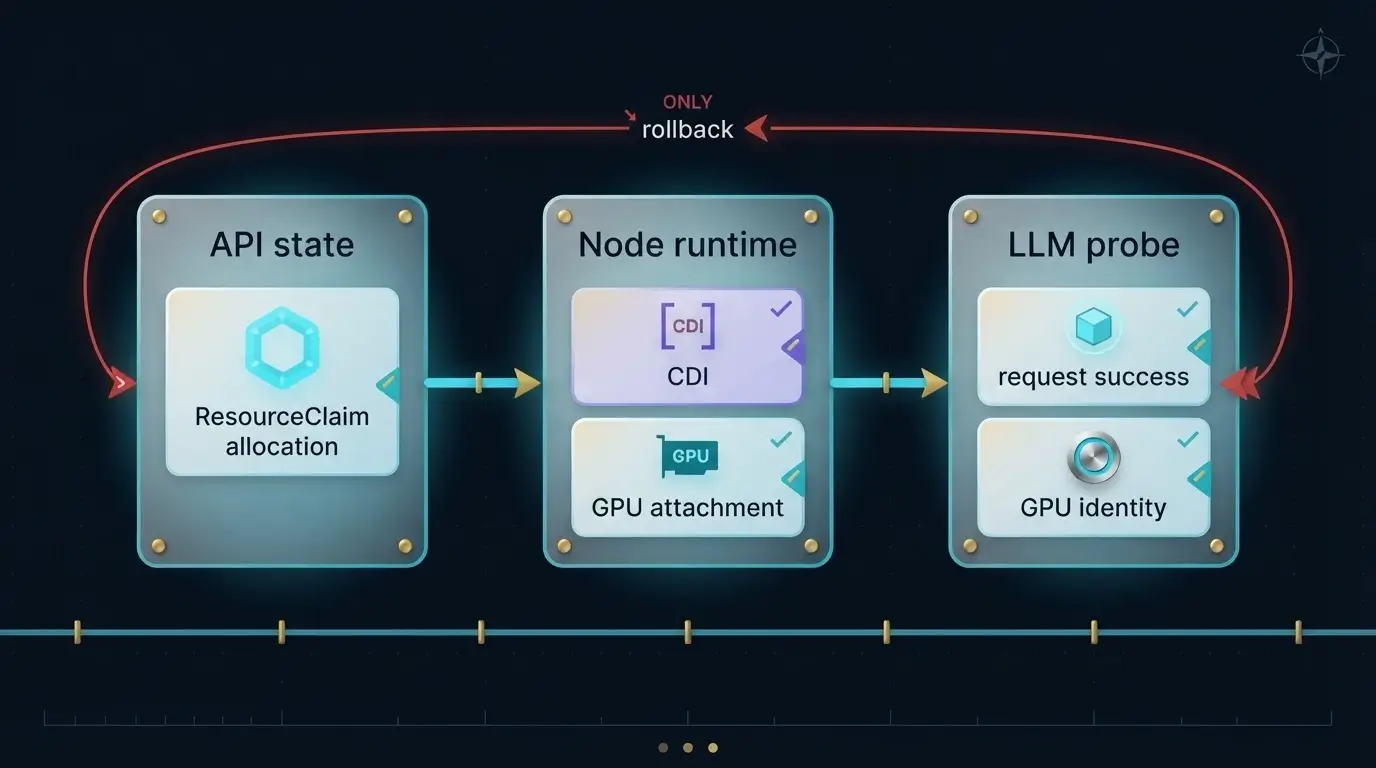
Разворачиваем новый GPUCluster, не ломая рабочий pool
Для GPU Operator 26.7 управляемый DRA-путь создаёт singleton GPUCluster с именем gpu-cluster. Он заменяет ClusterPolicy как корневой объект именно в этом workflow. NVIDIA не поддерживает их совместное существование в одном кластере и не поддерживает in-place migration. Поэтому ниже команда предназначена для нового canary-кластера, где kubectl get clusterpolicy не возвращает объект.
Зафиксируйте chart version в values или команде, а не устанавливайте «latest». Если драйвер уже управляется на хосте, используйте вариант с driver.enabled=false; если Operator должен ставить драйвер через NVIDIADriver, включите соответствующий CRD. Для обычных PCIe GPU без Multi-Node NVLink отключите ComputeDomain, чтобы не развертывать ненужные компоненты.
После Helm не переходите сразу к workload. Сначала ждите Ready у GPUCluster, затем проверьте Pods оператора, DeviceClass и ResourceSlice. gpu.nvidia.com должен существовать, а ResourceSlice — рекламировать устройства на ожидаемых узлах. Если GPUCluster сообщает PrerequisiteNotMet, ищите ClusterPolicy; OperandNotReady означает, что один из управляемых компонентов ещё не готов.
helm repo add nvidia https://helm.ngc.nvidia.com/nvidia
helm repo update

helm upgrade --install gpu-operator nvidia/gpu-operator \
  --version=v26.7.0 \
  --namespace gpu-operator \
  --create-namespace \
  --set clusterPolicy.deployCR=false \
  --set gpuCluster.deployCR=true \
  --set driver.enabled=false \
  --set draDriver.computeDomains.enabled=false

kubectl get gpucluster gpu-cluster
kubectl get pods -n gpu-operator
kubectl get deviceclass
kubectl get resourceslice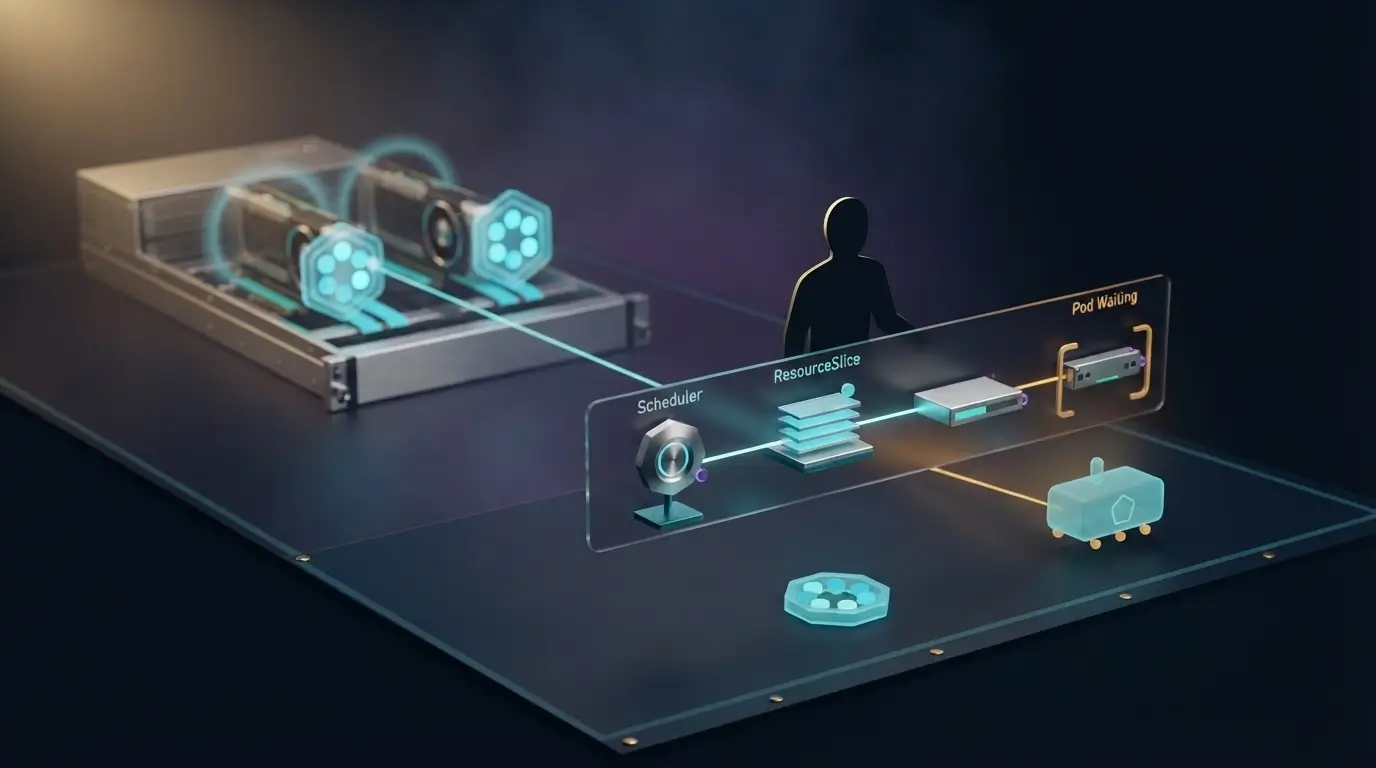
ResourceClaimTemplate для inference-реплик
Для stateless inference Deployment обычно удобен ResourceClaimTemplate: каждая реплика получает отдельный claim с тем же классом требований, а Kubernetes управляет его жизненным циклом вместе с Pod. Заранее созданный ResourceClaim нужен, когда несколько контейнеров или Pods действительно должны ссылаться на один device и драйвер поддерживает такой режим. Не выбирайте shared claim только ради экономии GPU: isolation и scheduling semantics должны быть доказаны отдельно.
Минимальный запрос к NVIDIA-классу использует resource.k8s.io/v1 и deviceClassName: gpu.nvidia.com. В Pod template имя из spec.resourceClaims повторяется в resources.claims контейнера. Ниже образец показывает структуру, а image и probes оставляет вашей платформе: копировать случайный LLM container в production было бы хуже, чем честно обозначить точку интеграции.
Селекторы CEL добавляйте только после просмотра реальных attributes и capacity в ResourceSlice вашей версии драйвера. Не выдумывайте имя поля памяти или product name по примеру другого vendor. Сначала kubectl get resourceslice -o yaml, затем выражение, затем отрицательный claim с заведомо недоступным условием. Если отрицательный Pod внезапно стартовал, selector не обеспечивает ожидаемую границу.
apiVersion: resource.k8s.io/v1
kind: ResourceClaimTemplate
metadata:
  name: llm-gpu
spec:
  spec:
    devices:
      requests:
      - name: inference-gpu
        exactly:
          deviceClassName: gpu.nvidia.com
---
apiVersion: apps/v1
kind: Deployment
metadata:
  name: llm-canary
spec:
  replicas: 1
  selector:
    matchLabels:
      app: llm-canary
  template:
    metadata:
      labels:
        app: llm-canary
    spec:
      containers:
      - name: server
        image: YOUR_PINNED_LLM_IMAGE
        resources:
          claims:
          - name: gpu
      resourceClaims:
      - name: gpu
        resourceClaimTemplateName: llm-gpu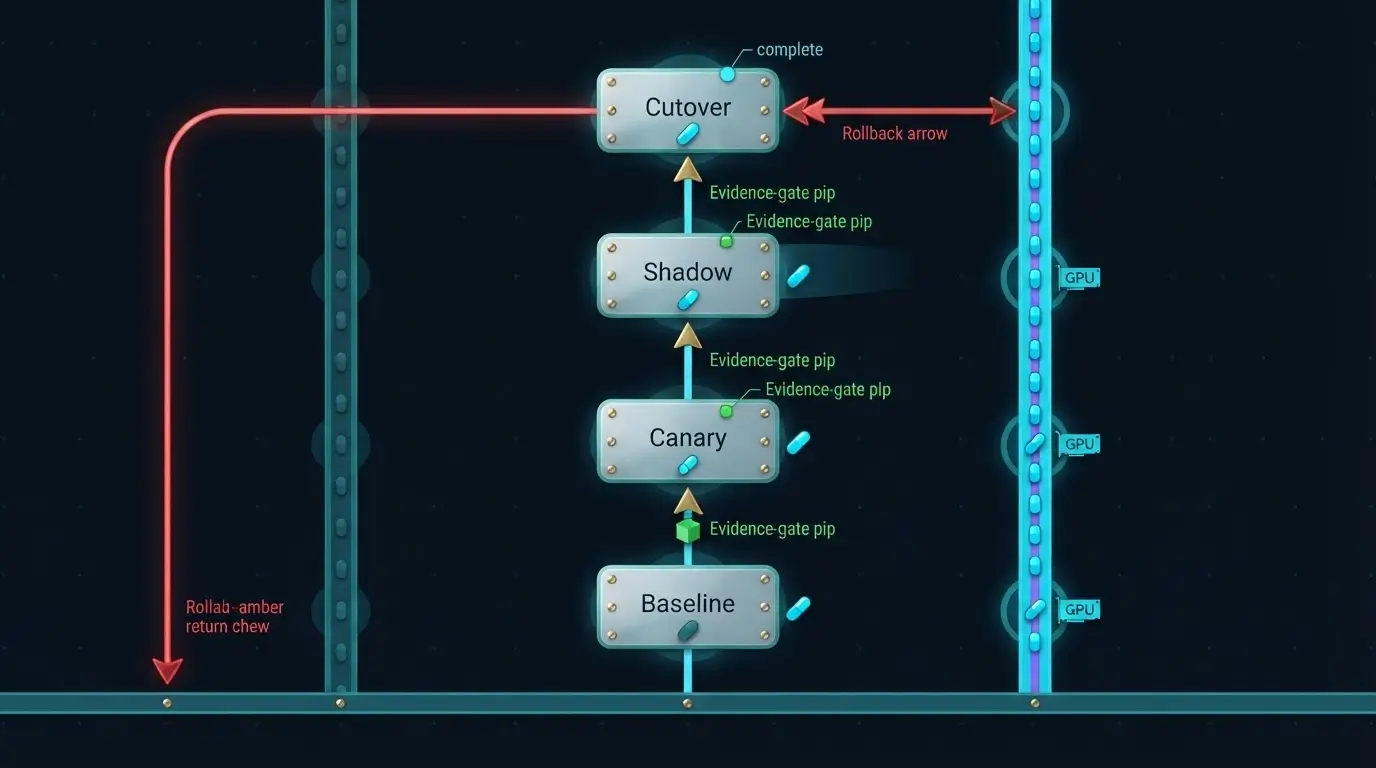
Три evidence gate: API, node runtime, LLM
Первый gate принадлежит platform team и доказывает desired state. ResourceClaim создан, в status есть allocation, reservedFor ссылается на нужный Pod, scheduler выбрал ожидаемый узел. События не содержат повторяющегося allocation failure. На этом этапе GPU ещё не считается пригодным для модели: control plane мог принять решение, а node preparation — провалиться.
Второй gate принадлежит node/runtime owner. Kubelet вызвал NodePrepareResources, DRA plugin здоров, CDI spec применён, внутри контейнера виден выделенный GPU UUID и не виден соседний. Сопоставьте UUID с ResourceSlice и host inventory. Если контейнер видит device, но UUID не тот, это failure, даже когда nvidia-smi возвращает ноль.
Третий gate принадлежит владельцу inference. Startup/readiness проходят, модель загружена, тестовый запрос даёт ожидаемый контракт ответа, а GPU-метрики меняются именно на выделенном device. Сравните с baseline в одинаковом режиме. DRA не исправляет медленное чтение весов, NUMA-удалённую память или app-limited networking; при деградации полезны отдельные runbook, например про NUMA-locality GPU inference.
Повышайте трафик только после трёх PASS подряд и отрицательного контроля. Эта последовательность не бюрократия: она локализует владельца сбоя. Если allocation пуст, бессмысленно тюнить vLLM. Если claim корректен, но CDI не подготовил устройство, autoscaling только размножит Pending.
kubectl get pods -n llm-canary -o wide
kubectl get resourceclaim -n llm-canary
kubectl describe resourceclaim -n llm-canary
kubectl describe pod -n llm-canary -l app=llm-canary
kubectl logs -n gpu-operator -l app.kubernetes.io/name=nvidia-dra-driver-gpu --all-containers --tail=200

POD=$(kubectl get pod -n llm-canary -l app=llm-canary -o jsonpath='{.items[0].metadata.name}')
kubectl exec -n llm-canary "$POD" -- nvidia-smi -L
kubectl get --raw /readyz
Диагностика Pending без хаотичных рестартов
Идите сверху вниз по одной и той же цепочке. Если ResourceClaimTemplate не породил claim, проверьте ссылку в Pod spec, controller-manager и старые mutating webhooks. Upstream отдельно отмечает ошибку, когда webhook, собранный против старого API, оставляет несовместимые поля. Перезапуск kubelet здесь не поможет: сбой ещё в control plane.
Если claim есть, но allocation пуст, смотрите DeviceClass, ResourceSlice, CEL и события scheduler. Подходящее устройство должно быть доступно на узле, который одновременно удовлетворяет обычным requests, affinity и taints Pod. DRA использует first-fit и рассматривает pools/ResourceSlices в лексикографическом порядке, поэтому имя и состав pool могут влиять на повторяемость выбора. Не подменяйте диагностику ручным spec.nodeName: такой Pod обходит scheduler и способен зарезервировать CPU/RAM на узле, оставаясь неработоспособным.
Если Pod уже назначен, но sandbox или контейнер не стартует, переходите к kubelet, DRA plugin gRPC, CDI и runtime logs. При обновлении драйвера running Pods обычно продолжают работать, но новые Pods могут не стартовать, а cleanup claim задержится. Поэтому DRA DaemonSet надо drain-ить последним, когда пользовательские Pods и их claims уже освобождены.
Наконец, если inference медленный при здоровых первых двух gate, остановитесь. Это application или hardware-path проблема. Проверьте загрузку модели, storage, NUMA, power cap и сеть. Материал про power cap GPU показывает тот же принцип: сначала механизм, затем метрика приложения, затем rollback-контрфакт.
Rollout и rollback: отдельные lanes, одинаковые проверки
Безопасный rollout состоит из четырёх ступеней. Baseline фиксирует старый Device Plugin lane. Canary запускает одну реплику в новом DRA-кластере и только синтетические запросы. Shadow получает копию production traffic без влияния на ответ пользователю. Cutover переносит малую долю реального трафика и растёт только при стабильных gate. Проценты и окна выбирайте по своему SLO; универсальных чисел здесь нет.
Старый и новый механизм не должны бороться за один физический GPU. Разведите узлы или кластеры, маршруты и capacity accounting. Сохраните один и тот же model artifact, tokenizer, runtime image и профиль запроса. Иначе команда увидит разницу, но не узнает, породил её DRA, новый драйвер или обновлённая модель.
Rollback повторяет доказательства в обратном направлении: вернуть route на baseline, дождаться завершения canary requests, удалить user workloads и claims, подтвердить NodeUnprepareResources, затем разбирать DRA. NVIDIA предупреждает не использовать helm uninstall --no-hooks при существующем GPUCluster: pre-delete hook и finalizer обеспечивают упорядоченное удаление managed DaemonSets до kubelet plugin. Обход hook может оставить GPUCluster и claims без контроллера.
Stop condition формулируйте заранее: необъяснимый Pending, неправильный GPU UUID, рост error rate, failure readiness, невозможность освободить claim или расхождение telemetry attribution. Остановка означает возврат трафика, а не двадцать рестартов. Именно здесь отдельный canary-кластер окупает кажущуюся сложность.
RBAC, квоты и наблюдаемость DRA
DeviceClass и ResourceSlice относятся к административной поверхности: их должны изменять драйвер и cluster admins. Командам приложений обычно достаточно namespace-scoped ResourceClaim и ResourceClaimTemplate. Начиная с Kubernetes 1.36 hardening guide описывает отдельные synthetic subresources для обновления статуса: binding для scheduler/allocation controller и driver для node-local или multi-node компонента. Не выдавайте приложению право менять ResourceSlice только потому, что claim остаётся Pending.
Квоты теперь можно строить по DeviceClass. Это помогает ограничить число claims в namespace, но quota не заменяет поддержку sharing самим драйвером. Сумма «запрошено» и реальное потребление GPU могут отличаться, особенно с экспериментальными capacity-механизмами. Для production сначала квотируйте простые whole-device claims и расширяйте модель после canary.
Наблюдайте workqueue ResourceClaim controller, scheduler latency, health DRA plugin, длительность claim allocation и unprepare, Pending reasons и GPU telemetry с привязкой к Pod. GPUCluster включает DCGM Exporter по умолчанию; актуальный Operator умеет обогащать метрики данными ResourceSlice при включённых pod labels/UID. При высокой churn-нагрузке DRA добавляет API-вызовы и работу controller-manager, поэтому алерт только по GPU utilization недостаточен.
Проверяли ли вы освобождение claim после crash-loop и удаления Pod? Утечка reservation незаметна при низкой загрузке, а в пик превращается в «свободный GPU есть, новый Pod не стартует». В тесте обязательно создайте и удалите workload несколько раз, сохранив события и время cleanup, но не выдавайте результаты стенда за универсальный benchmark.
Для дежурной смены полезен короткий decision tree: claim не создан — controller или admission; allocation пуст — scheduler, class, slice и selector; Pod bound — kubelet, driver и CDI; модель не ready — application. В алерте передавайте namespace, Pod UID, claim name, selected node и device identity. Без этих полей инженер снова начнёт с общего списка Pods и потеряет время на переход между владельцами.
Когда выделенная GPU-инфраструктура упрощает DRA
DRA полезнее всего там, где inventory стабилен и известен платформе: конкретные модели GPU, одинаковый driver branch, предсказуемая PCIe/NUMA-топология и контролируемый container runtime. На выделенных GPU-серверах проще зафиксировать этот baseline, изолировать canary-pool и повторить hardware profile при расширении. Это не обещание ускорения; это уменьшение числа неизвестных в rollout.
Qualifying condition для нового пула — существующая боль от грубого extended resource: разные GPU под одним именем, ручные node labels, сложный sharing или слабая трассировка allocation. Disqualifier — единичный сервер с одним типом GPU и стабильным Deployment, где Device Plugin полностью закрывает задачу. В последнем случае новый control plane добавит больше сопровождения, чем ценности.
При выборе хостинга спрашивайте не «поддерживает ли он Kubernetes», а кто владеет драйвером, можно ли закрепить версию, включён ли CDI, доступна ли нужная topology и есть ли отдельные узлы для canary. Для multi-node NVLink уточняйте ComputeDomain и IMEX отдельно; обычная сеть между PCIe-серверами не становится MNNVL от установки DRA driver.
King Servers здесь уместен как инфраструктурная основа для воспроизводимого пилота: выделенные GPU-узлы, отдельная сеть и возможность сохранить старый pool на время проверки. Решение всё равно принимает команда по evidence gate. Сначала докажите allocation, runtime и LLM outcome, затем переносите трафик.
Перед заказом capacity составьте минимальную матрицу: модель GPU и объём памяти, число независимых failure domains, требования к локальному NVMe, скорость сети, версия Kubernetes, способ управления NVIDIA driver и окно обслуживания. Она не заменяет sizing LLM, зато не даёт купить ускорители, которые затем нельзя одинаково описать через DeviceClass или безопасно вывести в canary. Стабильный hardware profile ценнее красивой спецификации, если цель — воспроизводимый rollout.
Итог: мигрируйте договор выделения GPU, а не YAML
NVIDIA DRA Driver переводит GPU из безымянного счётчика в ресурс с классом, атрибутами, claim и наблюдаемым жизненным циклом. Это сильный инструмент для неоднородных GPU-парков и platform teams, но он не ускоряет модель сам по себе и не заменяет MIG, MPS, очередь или application profiling.
Рабочий маршрут на Kubernetes 1.36+ и GPU Operator 26.7 выглядит так: новый canary-кластер без ClusterPolicy, driver 580+, CDI, GPUCluster Ready, DeviceClass и ResourceSlice, один ResourceClaimTemplate, затем три независимых gate. После каждого шага оставляйте отрицательный контроль и готовый rollback. При любом необъяснимом расхождении возвращайте route на baseline, а не расширяйте права и не обходите finalizer.
Начните с evidence bundle и одного canary Pod. Если claim выделяется, контейнер видит ровно нужный GPU, а LLM проходит тот же probe, у вас есть основание для shadow traffic. Если нет, цепочка объектов уже подсказывает, какой владелец и какой слой должны чинить проблему. Это и есть главная практическая ценность DRA: не магия, а проверяемый контракт между железом, Kubernetes и приложением.