Оглавление
- Быстрый вердикт: когда виновата таблица соседей
- Путь пакета: четыре evidence gate вместо догадки
- Состояния NUD: что означают REACHABLE, STALE и FAILED
- Снять baseline: команды, которые сохраняют контекст
- Packet capture для ARP и IPv6 ND без лишнего шума
- Кто владеет записью в Kubernetes: host, Pod, CNI или gateway
- Ёмкость neighbor cache: gc_thresh без магических чисел
- Canary A/B/A: менять один owner и проверять приложение
- Типичные ошибки: flush, статические записи и неверный owner
- Decision matrix: ничего не менять, исправить путь или изолировать сеть
- Вывод: докажите L2-сбой до настройки cache
Готовы перейти на современную серверную инфраструктуру?
В King Servers мы предлагаем серверы как на AMD EPYC, так и на Intel Xeon, с гибкими конфигурациями под любые задачи — от виртуализации и веб-хостинга до S3-хранилищ и кластеров хранения данных.
- S3-совместимое хранилище для резервных копий
- Панель управления, API, масштабируемость
- Поддержку 24/7 и помощь в выборе конфигурации
Результат регистрации
...
Создайте аккаунт
Быстрая регистрация для доступа к инфраструктуре
Быстрый вердикт: когда виновата таблица соседей
LLM API может выглядеть «живым»: health-check проходит, GPU загружен, DNS отвечает, а новые запросы с одного узла получают секунды ожидания или No route to host. Если проблемный адрес находится в том же L2-сегменте или next hop не разрешается в MAC, проверьте neighbor table раньше, чем увеличивать таймауты приложения.
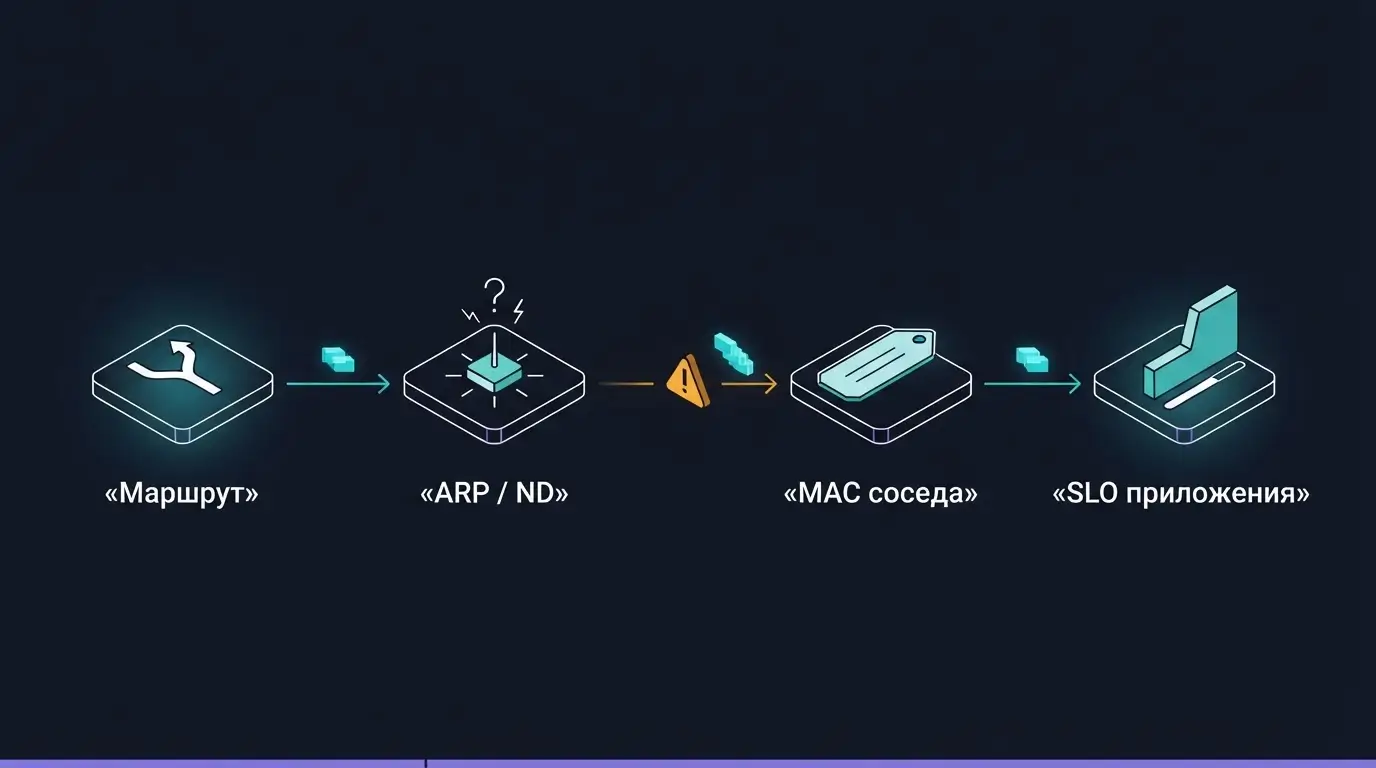
Сильный сигнал — сочетание трёх фактов: ip route get выбирает ожидаемый интерфейс и next hop; запись для него застревает в INCOMPLETE либо переходит в FAILED; packet capture видит ARP Request или IPv6 Neighbor Solicitation без корректного ответа. Четвёртый gate — пользовательский: fresh connection к LLM endpoint ломается одновременно с этим состоянием, а здоровый peer в том же тесте отвечает.
Одного списка FAILED недостаточно. В cache остаются адреса выключенных Pod, старых VIP и уже удалённых узлов. Не помогает и механическое увеличение gc_thresh3: если коммутатор режет VLAN, CNI объявляет неверный маршрут или anti-spoofing блокирует ответ, более вместительная таблица лишь хранит проблему дольше.
Эта статья — runbook для Linux-узла на bare metal, VPS или Kubernetes node. Он не заменяет диагностику Service dataplane, conntrack или очереди inference. Для широкого контекста архитектуры полезен материал о Private AI API, а здесь мы сознательно остаёмся на границе IP → link layer.
Путь пакета: четыре evidence gate вместо догадки
Начинайте из effective network namespace. Команда на host может показывать здоровую запись, пока Pod живёт в другом namespace, VRF или overlay. Сначала выясните, откуда реально выходит трафик: hostNetwork, veth Pod, CNI tunnel, egress gateway либо отдельный интерфейс storage/RDMA. Вопрос простой: чей neighbor cache участвует в отправке именно этого пакета?
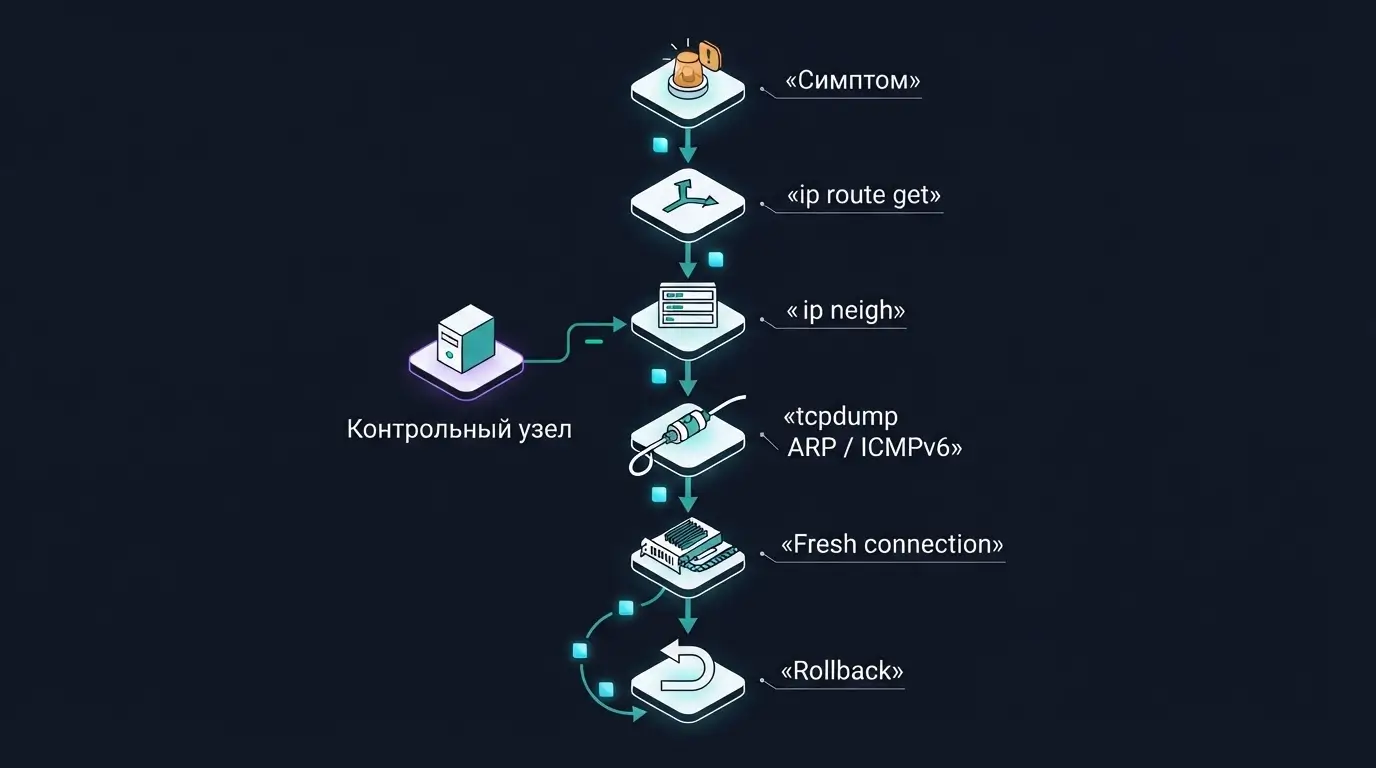
Gate 1 — маршрут. ip route get с нужным destination и, при необходимости, source показывает выбранные device, gateway и table. Gate 2 — link-layer resolution: ip neigh get и ip -s neigh show dev фиксируют состояние и probes. Gate 3 — фактический peer: capture подтверждает запрос, ответ и MAC. Gate 4 — application outcome: новый TCP-сеанс или gRPC/SSE-запрос должен восстановиться вместе с L2 resolution.
Пример: Pod обращается к inference endpoint 10.40.8.21, но маршрут ведёт через 10.40.8.1. Искать ARP для конечного адреса ошибочно: сосед — gateway. В overlay соседним может быть VTEP, а Pod IP разрешается внутри dataplane CNI. Поэтому сначала маршрут, потом neighbor entry, и только затем вывод.
Такой порядок защищает от ложного совпадения. Рост TTFT может происходить одновременно с STALE, но причина окажется в GPU queue. И наоборот, TCP retransmits будут выглядеть «сетевой задержкой», хотя пакет даже не получил destination MAC.
Состояния NUD: что означают REACHABLE, STALE и FAILED
ip neigh показывает не статичный ARP-кэш, а состояние Neighbor Unreachability Detection. В Linux одинаковая модель используется для IPv4 ARP и IPv6 ND, хотя протоколы разрешения различаются. REACHABLE означает недавнее положительное подтверждение. STALE говорит лишь о том, что подтверждение устарело; запись остаётся пригодной до следующего использования.
При отправке через STALE запись обычно переходит в DELAY, затем при отсутствии upper-layer confirmation — в PROBE. Это нормальная проверка живости. INCOMPLETE принципиально другой: link-layer address ещё не получен, поэтому ядро удерживает ограниченную очередь пакетов на время разрешения. После исчерпания probes Linux показывает FAILED.
RFC 4861 определяет для IPv6 пять основных состояний neighbor cache и подчёркивает роль подтверждения прогресса от верхнего уровня. Практическое следствие: успешные ACK могут поддерживать знание о peer, а отсутствие новых соединений делает старую запись тихой. Документация ip-neighbour(8) отдельно перечисляет состояния, доступные в iproute2.
Не агрегируйте всё в один alarm «не REACHABLE». Для активного LLM gateway короткие STALE → DELAY → REACHABLE безопасны. А серия INCOMPLETE → FAILED для рабочего next hop, совпавшая с ошибками fresh connections, уже достойна page.
Снять baseline: команды, которые сохраняют контекст
Перед изменениями сохраните namespace, время, интерфейс, route decision и полный вывод neighbor table. Снимок только после инцидента слаб: вы не увидите переходов. Лучше выполнить одну и ту же короткую последовательность трижды — до пробы, во время ошибки и после восстановления.
Используйте адрес фактического next hop из первого шага. Ключ -s добавляет статистику, а фильтр по dev не смешивает management, storage и workload networks. В VRF добавьте соответствующий контекст. Для Pod namespace применяйте nsenter или ip netns exec согласно вашей runtime-модели.
date -Is
ip -br link
ip -br address
ip route get 10.40.8.21
ip neigh get 10.40.8.1 dev eth1
ip -s neigh show dev eth1
ip -6 -s neigh show dev eth1Считайте результат как цепочку, а не как набор строк. Если маршрут неожиданно сменил interface, neighbor table другого device не объясняет сбой. Если ip neigh get здоров, но приложение подключается к иному remote peer через DNS или load balancer, повторите тест с зафиксированным адресом и fresh connection.
Обязательно сохраните negative control: соседний узел или другой peer на том же интерфейсе. Если оба адреса одновременно переходят в FAILED, граница причины ближе к interface, VLAN, switch или CNI. Если ломается один peer, проверяйте его порт, адрес и объявления. Такой контроль полезнее случайного flush всей таблицы.
Packet capture для ARP и IPv6 ND без лишнего шума
Capture отвечает на главный вопрос: запрос не ушёл, ответ не пришёл или ответ пришёл, но был отвергнут/не применён. Для IPv4 наблюдайте ARP Request и Reply. Для IPv6 — ICMPv6 Neighbor Solicitation и Neighbor Advertisement. Снимайте на интерфейсе, который выбрал маршрут; capture на any удобен для ориентира, но скрывает часть link-layer деталей.
sudo tcpdump -ni eth1 -e -vvv 'arp'
sudo tcpdump -ni eth1 -e -vvv 'icmp6 and (ip6[40] == 135 or ip6[40] == 136)'
ip neigh get 10.40.8.1 dev eth1
ping -c 2 -I eth1 10.40.8.1В IPv6 валидность ND зависит не только от наличия пакета. RFC 4861 требует Hop Limit 255, корректную checksum и допустимые options. Ответ с другого VLAN, неверным target или неожиданным link-layer address не следует трактовать как доказательство здорового пути. Сопоставьте source/destination, target address и MAC с route decision.
В Kubernetes параллельно проверьте host и namespace workload. Модель Kubernetes даёт каждому Pod собственный IP и делегирует реализацию pod network CNI; поэтому место ARP/ND зависит от режима. В routed CNI node может знать маршруты к Pod CIDR и разрешать только соседний node. В L2/bridge-модели количество непосредственно видимых peers бывает заметно больше.
Не очищайте cache перед capture на всех узлах. Массовый flush создаёт всплеск resolution и может усилить инцидент. Для canary допустимо удалить одну динамическую запись конкретного next hop, если подготовлены negative control и rollback, но сначала сохраните исходный вывод.
Кто владеет записью в Kubernetes: host, Pod, CNI или gateway
Kubernetes описывает желаемую связность, но не диктует конкретный dataplane. Pod network реализует CNI, Service traffic может обрабатываться kube-proxy или собственным proxy CNI. Поэтому одинаковый ClusterIP на двух кластерах проходит разные hop’ы: iptables/nftables DNAT, eBPF service map, overlay VTEP, routed Pod CIDR или внешний gateway.
Начните с пары тестов: прямой Pod IP и Service IP, оба на fresh connections. Если Pod IP работает, а Service нет, neighbor table редко будет первым owner; смотрите Service dataplane и endpoint selection. Если оба ломаются только на одном node и route ведёт к одному VTEP или next hop, neighbor resolution становится сильнее кандидатом.
Проверяйте события churn. Быстрое пересоздание Pod само по себе не обязано раздувать L2 cache: всё зависит от того, являются ли Pod IP on-link для узла. В overlay cache может содержать только VTEP peers, а в большой L2-модели — тысячи конечных адресов. Считать «число Pod = число neighbors» нельзя.
Для security boundary полезен отдельный материал о Kubernetes NetworkPolicy для LLM inference. Policy deny и neighbor failure могут выглядеть похоже для приложения, но evidence различается: при policy обычно есть известный peer/MAC и verdict dataplane, а при INCOMPLETE link-layer binding ещё не построен.
Ёмкость neighbor cache: gc_thresh без магических чисел
Linux предоставляет gc_thresh1, gc_thresh2 и gc_thresh3 для управления garbage collection neighbor entries. Актуальная документация ядра описывает их как минимальный уровень хранения, порог более агрессивной очистки и максимум непостоянных записей. Значения по умолчанию зависят от документации/сборки; не переносите число из чужой статьи без чтения sysctl на собственном kernel.
gc_thresh3 стоит повышать только после доказанного capacity pressure: рабочий набор непосредственно подключённых peers легитимен, события показывают отказ выделения новых записей, а GC не успевает при нормальном churn. Сначала измерьте количество записей по family, device и state, затем оцените, почему они возникают. Часто правильное решение — уменьшить L2 failure domain, исправить on-link routes или стабилизировать IP churn.
for family in ipv4 ipv6; do
  echo "== $family =="
  sysctl "net.$family.neigh.default.gc_thresh1"
  sysctl "net.$family.neigh.default.gc_thresh2"
  sysctl "net.$family.neigh.default.gc_thresh3"
  sysctl "net.$family.neigh.default.unres_qlen_bytes"
done

ip neigh show | awk '{print $NF}' | sort | uniq -c
ip -6 neigh show | awk '{print $NF}' | sort | uniq -cОбратите внимание на unres_qlen_bytes: это лимит байтов пакетов, ожидающих разрешения одного адреса. Старый unres_qlen помечен документацией ядра как deprecated начиная с Linux 3.3. Увеличение очереди не исправляет отсутствующий ARP/NA; оно лишь меняет объём удерживаемых данных и memory envelope.
Для GPU-кластера цена ошибки выше обычной: control request может быть мал, но за ним стоит дорогая capacity. Тем не менее dedicated node или больший VPS не устраняет неверный VLAN, CNI route или switch policy. Инфраструктурный апгрейд обоснован, когда доказан рабочий набор peers, требуется управляемый L2/VRF profile и команда готова владеть kernel, NIC и change window.
Canary A/B/A: менять один owner и проверять приложение
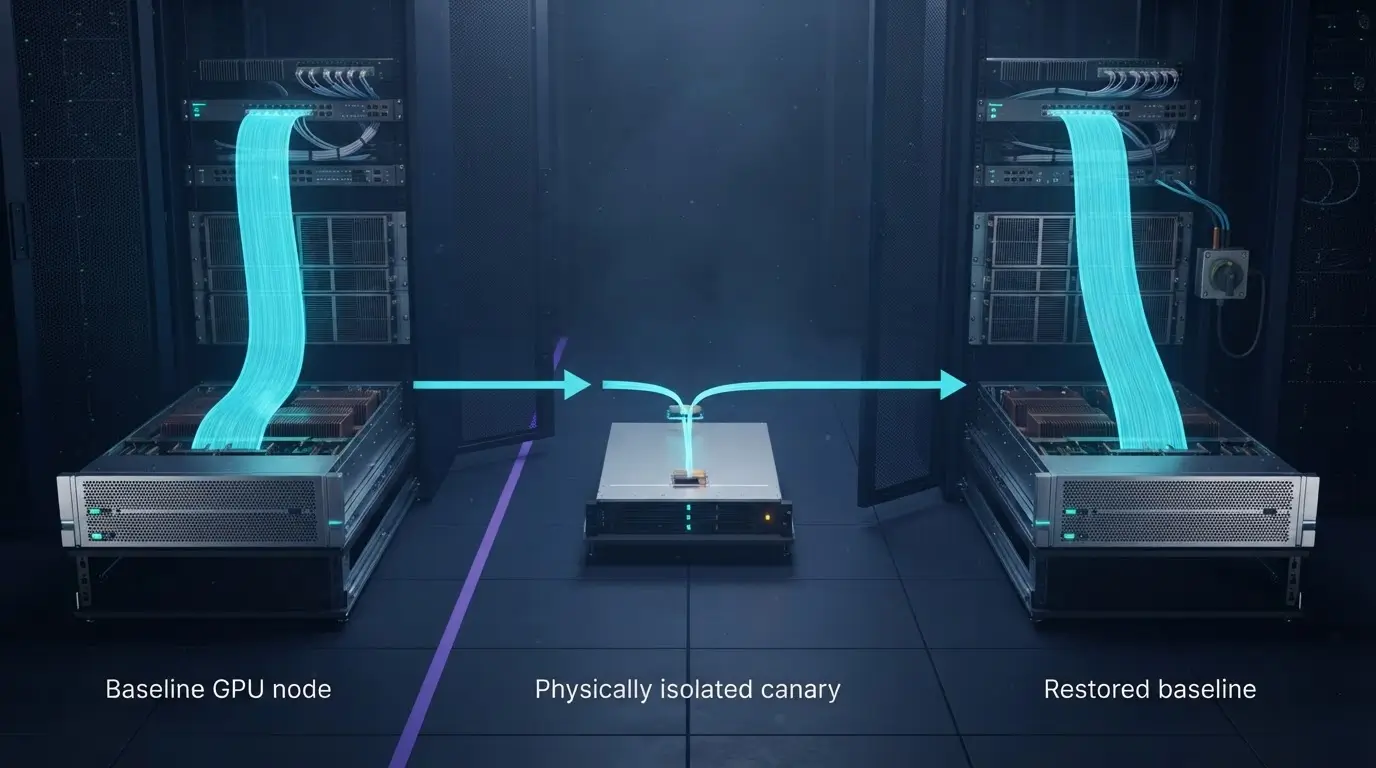
Хороший canary начинается с baseline A. Выберите один node и один проблемный peer, сохраните route, neighbor states, capture и application SLO. Зафиксируйте stop condition: например, рост ошибок новых запросов или распространение INCOMPLETE на healthy peer. Остальные nodes остаются control group.
В фазе B меняйте один owner. Это может быть исправление VLAN на switch port, route в CNI, адреса gateway или один sysctl на canary. Не смешивайте flush cache, перезапуск CNI и изменение порогов: положительный результат станет неинтерпретируемым. После вмешательства повторите тот же destination, source, namespace и fresh-connection probe.
Фаза A после rollback обязательна. Если возврат исходной настройки возвращает ошибку, причинность сильнее. Если эффект сохраняется, вероятно, вы случайно обновили cache, connection pool или соседнее состояние. Подождите согласованное окно и повторите, не подгоняя вывод под желаемый результат.
Application gate должен измерять то, что видел пользователь: успешность новых LLM-запросов, время до первого байта/токена, stream completion и ошибки. Сетевой cache может стать REACHABLE, пока gateway всё ещё ждёт GPU. Протокольное улучшение без application outcome не объявляйте победой.
Типичные ошибки: flush, статические записи и неверный owner
Первая ошибка — ip neigh flush all в разгар инцидента. Команда стирает доказательство и создаёт одновременное разрешение множества адресов. Если нужен эксперимент, ограничьте его одним device и адресом на canary, предварительно сохранив state и capture.
Вторая — постоянная статическая запись как «лечение». Она может временно скрыть потерю ARP/ND, но создаёт риск stale MAC после failover, замены NIC или миграции VIP. Статика уместна только как осознанная часть сетевого дизайна с владельцем lifecycle; для диагностики она плоха, потому что выключает механизм, который вы пытаетесь понять.
Третья — alarm на долю STALE. STALE является нормальным состоянием неактивных соседей. Полезнее следить за скоростью переходов в INCOMPLETE/FAILED для активных next hops, ошибками выделения entries, отсутствием replies и корреляцией с fresh-connection failures.
Четвёртая — покупка более крупного сервера до path proof. Dedicated edge полезен, когда нужны отдельные NIC, предсказуемый L2/VRF, собственный kernel profile и контролируемое окно изменений. Но он не исправит неправильный on-link prefix, конфликт IP, anti-spoofing или политику switch. Commercial decision начинается с ownership, а не с обещания меньшей latency.
Пятая — смешивание CPU network bottleneck с resolution. Если ARP/ND проходит, peer MAC стабилен, но softirq перегружен, используйте runbook по RSS, RPS и IRQ affinity. А для больших списков firewall-адресов отдельно полезны nftables sets.
Decision matrix: ничего не менять, исправить путь или изолировать сеть
Ничего не меняйте, если STALE/PROBE кратковременны, resolution завершается, healthy и problem probes одинаковы, а application SLO не коррелирует с neighbor state. Ищите очередь inference, proxy buffering, DNS selection или CPU path.
Исправьте конкретный путь, если request уходит без reply либо reply приходит на неверном interface/VLAN; route указывает неожиданный next hop; один CNI node объявляет неправильный prefix; IP конфликтует; switch или anti-spoofing отбрасывает ответ. Это конфигурационная причина, и больший cache её не лечит.
Настройте ёмкость, если доказаны легитимный большой working set, pressure GC и отказ новых entries при исправном L2. План включает memory budget, canary, per-family значения, мониторинг churn и симметричный rollback. Порог выбирается из наблюдаемой нагрузки, а не из универсального рецепта.
Изолируйте failure domain, если бизнесу нужен предсказуемый network profile: отдельные NIC/VRF/VLAN, контролируемые версии kernel/CNI, switch telemetry и окно обслуживания. VPS может быть хорош для небольшого egress/gateway, dedicated node — для плотного east-west traffic и владения NIC. Managed network снимает часть операционного долга, но уменьшает доступ к low-level evidence. Выбор делайте после canary.
Вывод: докажите L2-сбой до настройки cache
Таблица соседей — короткий, но критичный участок пути между IP route и реальным кадром в сети. Рабочий runbook держится на четырёх доказательствах: route/namespace, NUD state, ARP или IPv6 ND на проводе и application outcome на новом соединении. Если хотя бы одного звена нет, вывод остаётся гипотезой.
Начните с одного проблемного peer и здорового negative control. Сохраните baseline, сделайте capture, найдите владельца между host, CNI, switch и gateway. Меняйте один параметр на canary и возвращайтесь к baseline после проверки. Так вы отличите нормальный STALE от настоящего FAILED, capacity pressure от неверного L2-пути, а инфраструктурную потребность — от попытки купить выход из конфигурационной ошибки.
Следующий практический шаг прост: добавьте route + neighbor + capture bundle в шаблон инцидента и прогоните его на тестовом узле до следующего page. Если path proof показывает, что команде нужен отдельный контролируемый network profile, сравните VPS, dedicated node и managed edge по ownership, observability и rollback — уже на основании данных.