Оглавление
- Быстрый вывод: DNS failover не равен переключению трафика
- Составьте карту кэшей до изменения записи
- Снимите baseline: authoritative, recursive, host и приложение
- Диагностика systemd-resolved без магии flush-caches
- Проверьте application DNS cache и connection reuse
- Не смешивайте A и AAAA: dual-stack меняет картину отказа
- Runbook переключения: от записи к application SLO
- Canary и отрицательный контроль: докажите механизм, а не корреляцию
- Когда DNS failover подходит, а когда нужен proxy или Anycast
- Метрики и алерты, которые действительно ловят DNS-инцидент
- Итог: управляйте состоянием, а не числом в TTL
Готовы перейти на современную серверную инфраструктуру?
В King Servers мы предлагаем серверы как на AMD EPYC, так и на Intel Xeon, с гибкими конфигурациями под любые задачи — от виртуализации и веб-хостинга до S3-хранилищ и кластеров хранения данных.
- S3-совместимое хранилище для резервных копий
- Панель управления, API, масштабируемость
- Поддержку 24/7 и помощь в выборе конфигурации
Результат регистрации
...
Создайте аккаунт
Быстрая регистрация для доступа к инфраструктуре
Быстрый вывод: DNS failover не равен переключению трафика
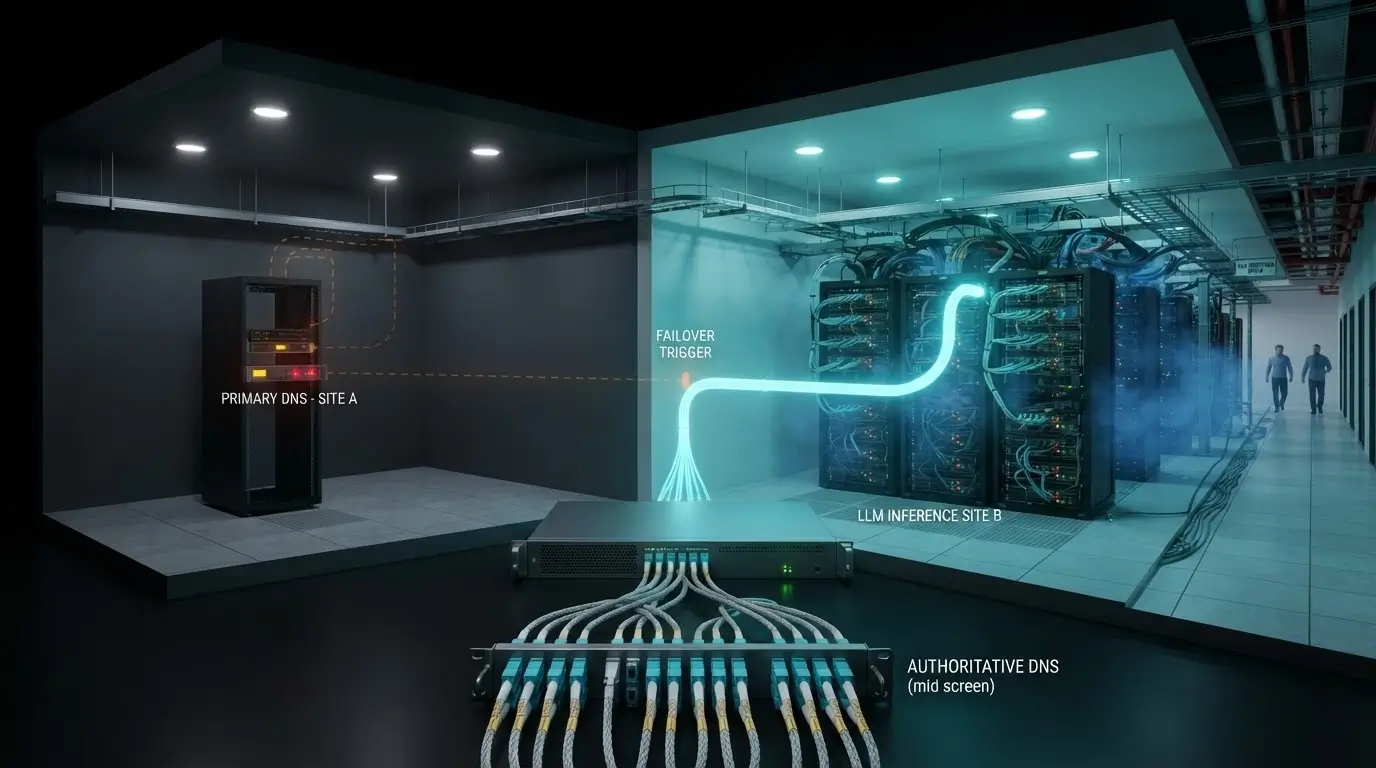
Если вы поменяли A- или AAAA-запись, а LLM-клиенты продолжают ходить на старую GPU-площадку, это еще не доказывает «сломанный DNS». Запись могла обновиться на authoritative-сервере, но остаться в рекурсивном или локальном кэше; приложение могло сохранить собственный результат; а уже открытый HTTP/2 или keep-alive канал вообще не обязан выполнять новый lookup. Поэтому рабочий default прост: не снижайте TTL и не чистите кэши вслепую. Сначала определите, какой слой владеет старым состоянием.
Для production LLM API цена ошибки выше, чем у короткого веб-запроса. Один streaming-сеанс может жить долго, GPU endpoint может быть DNS-доступен, но не готов к нужной модели, а повтор неидемпотентного запроса после первого токена создает дублирующую работу. DNS отвечает только на вопрос «какие адреса доступны для нового соединения». Он не выполняет health check модели, не дренирует соединения и не гарантирует завершение потока.
Runbook ниже строится вокруг трех независимых gates: DNS answer → transport peer → application outcome. Такой порядок быстро отделяет смену записи от сетевого пути и от готовности inference. Если второй и третий gates не пройдены, новая инфраструктура сама по себе проблему не исправит: больше GPU или выделенный сервер не лечат вечный connection pool, ошибочный timeout либо незакрытый retry storm.
Тема намеренно уже общего материала о принципах DNS и отдельного разбора active-active против active-passive для API. Здесь интересует операционная граница: как доказать фактическое переключение конкретного клиента и безопасно откатить изменение.
Составьте карту кэшей до изменения записи
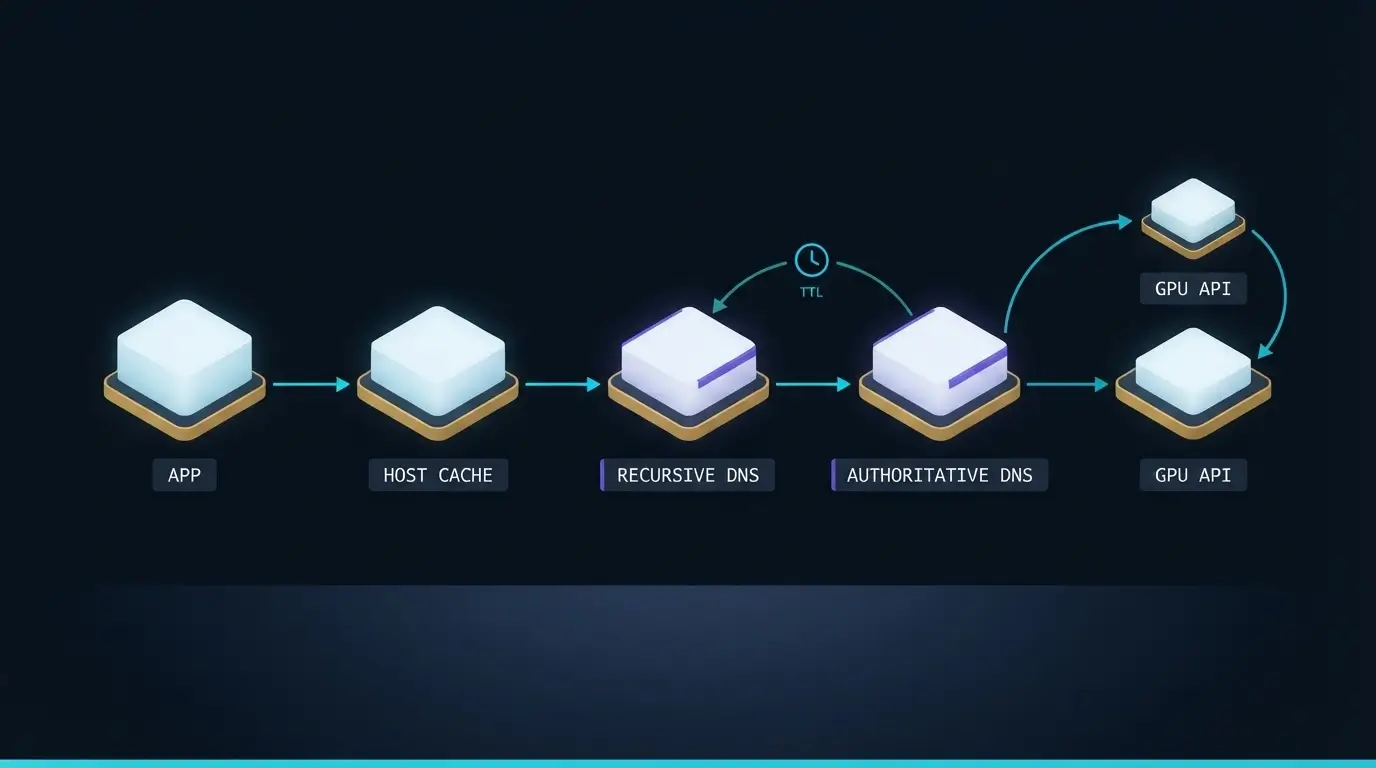
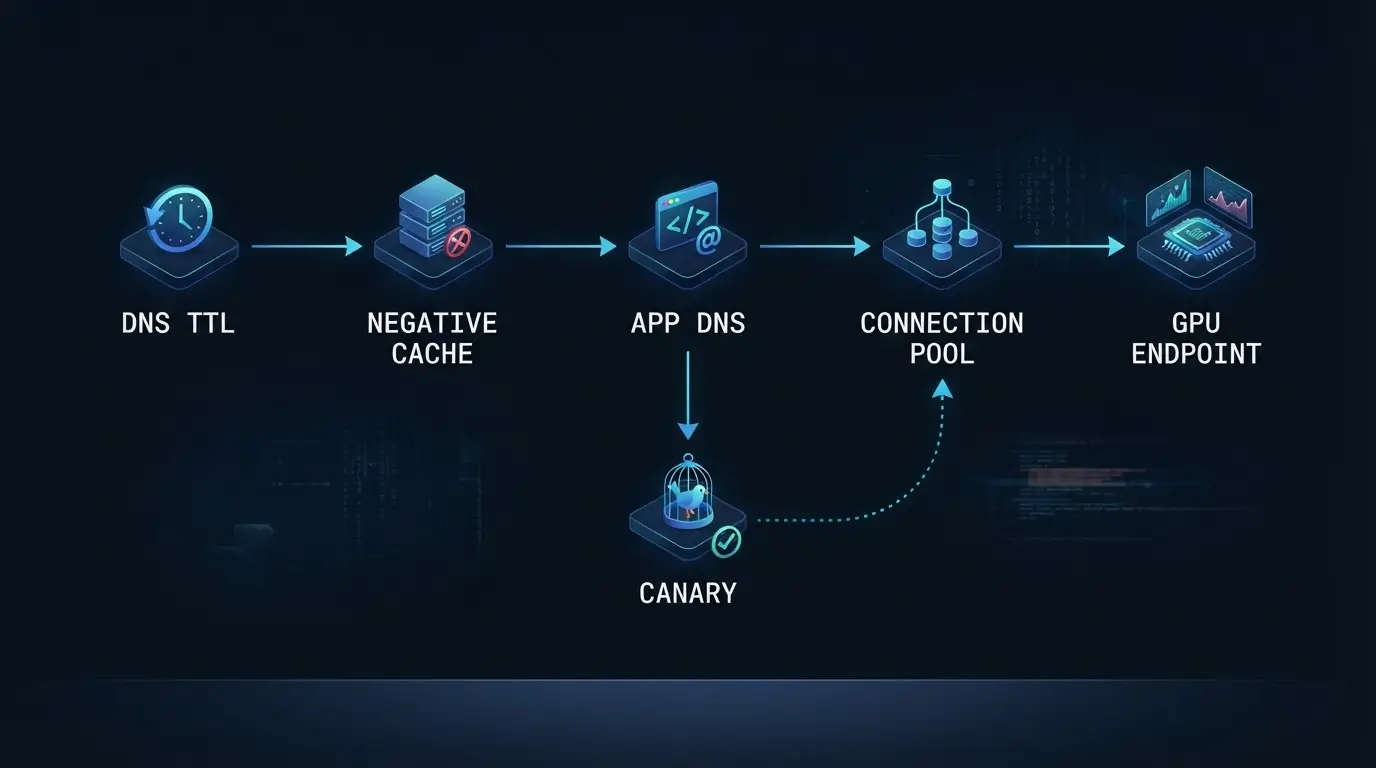
На типичном Linux-хосте запрос проходит не одну «DNS-систему», а цепочку. Приложение обращается к runtime или библиотеке, та использует NSS/getaddrinfo либо собственный resolver, запрос попадает в systemd-resolved или другой локальный stub, затем в recursive DNS и лишь после этого — к authoritative-серверам зоны. В контейнерной платформе добавятся node-local cache, CoreDNS, sidecar или egress proxy. Каждый слой может иметь собственную политику refresh.
Нарисуйте цепочку именно для проблемного workload. Проверяли ли вы, куда указывает /etc/resolv.conf внутри контейнера, а не только на хосте? Если это 127.0.0.53, запрос обычно идет через systemd-resolved; если адрес кластера — через CoreDNS; если приложение собрано с библиотекой async DNS, NSS может быть обойден. Один dig к публичному resolver не описывает этот путь.
Положительный TTL ограничивает использование конкретного RRset обычным кэшем, но есть две важные оговорки. Во-первых, RFC 2308 определяет negative caching: NXDOMAIN и NODATA могут жить по TTL, вычисленному из SOA. Если имя создали после ошибочного lookup, клиенты могут еще видеть отсутствие записи. Во-вторых, RFC 8767 допускает serve-stale при недоступности upstream: resolver сначала пытается обновить данные, но при сбое может вернуть просроченный ответ ради доступности.
Это не повод назначать TTL в пять секунд. Слишком короткий TTL увеличивает зависимость от resolver path и может создать синхронный всплеск запросов. Сначала зафиксируйте желаемый recovery envelope: сколько времени допустимо направлять новые соединения на старый endpoint, сколько живет connection pool и кто отвечает за drain.
Снимите baseline: authoritative, recursive, host и приложение
Baseline нужен до аварийного изменения, иначе после переключения вы будете сравнивать четыре неполных снимка. Возьмите один QNAME, например api.example.net, отдельно запишите A и AAAA, TTL, CNAME-цепочку, ответ каждого authoritative nameserver и ответы рекурсивных resolver, которыми реально пользуется production. Рядом сохраните время в UTC и идентификатор узла.
На хосте сравните три поверхности: конфигурацию resolver, прямой запрос через systemd-resolved и результат NSS. Команды ниже только читают состояние; замените имя и адреса на свои. resolvectl status показывает per-link DNS и routing domains, а getent ahosts повторяет путь, близкий к обычному getaddrinfo. Это полезнее, чем считать dig универсальным доказательством.
date -u
readlink -f /etc/resolv.conf
resolvectl status
resolvectl query api.example.net
getent ahosts api.example.net
dig +noall +answer A api.example.net
dig +noall +answer AAAA api.example.net
Следующий шаг — получить фактический peer IP приложения. Для прокси это может быть upstream address в access log или connection metric; для клиента — адрес сокета, трассировка connect либо лог SDK. Если DNS уже показывает новый адрес, но peer остается старым, владелец проблемы расположен после resolver: connection reuse, неистекший application cache или статически собранный upstream.
Снимайте baseline с нескольких узлов и через каждый production resolver. Разница между двумя worker nodes — не шум, а подсказка. Например, один узел использует корпоративный recursive resolver со stale policy, а второй — node-local cache с иным negative TTL. Усредненный success rate скроет этот разрез.
Диагностика systemd-resolved без магии flush-caches
systemd-resolved — caching stub и менеджер маршрутизации DNS-запросов. Он выбирает серверы с учетом per-link domains и держится за выбранный сервер в scope до ошибки. Поэтому два интерфейса, VPN и default-route могут отправлять одинаковый QNAME по разным путям. Сначала докажите effective configuration, и только затем обсуждайте cache.
resolvectl statistics показывает общую статистику, monitor — локальные запросы и ответы, show-cache — содержимое cache на новых версиях systemd. По актуальной man page команды monitor, show-cache и show-server-state появились в разных версиях, поэтому их отсутствие на LTS-дистрибутиве не означает поломку. Используйте доступный набор и фиксируйте версию через resolvectl --version.
resolvectl --version
resolvectl status
resolvectl statistics
resolvectl query api.example.net
resolvectl monitor
# На systemd 254+:
resolvectl show-cache
resolvectl flush-caches допустим как диагностический контрфакт на одном canary-узле: до очистки старый ответ, после — новый. Не превращайте его в rollout-механизм для всего флота. Очистка не меняет app cache и не закрывает sockets; кроме того, вы стираете полезное состояние и можете создать одновременный поток запросов к upstream DNS.
Параметр StaleRetentionSec= доступен в новых systemd и позволяет хранить записи после TTL для ответа при недоступном upstream; значение по умолчанию — ноль. Это resilience-функция, а не ускоритель миграции. Она не применяется к валидному NXDOMAIN, а включать ее следует только вместе с мониторингом DNS failures и понятной политикой возврата к свежим данным. Отдельно учитывайте RFC 9520: временные resolution failures также могут кэшироваться, но не должны удерживаться дольше пяти минут.
Проверьте application DNS cache и connection reuse
Самая частая ловушка выглядит так: resolvectl query и dig уже возвращают новый IP, а метрики старой площадки не падают. Причина часто не в кэше RRset, а в том, что процесс не выполняет новый dial. HTTP keep-alive, HTTP/2 multiplexing и gRPC channel позволяют многим запросам идти по существующему TCP/TLS-соединению. DNS TTL не является сроком жизни этого сокета.
Разделите вопросы. Первый: когда runtime повторно резолвит имя? Второй: когда connection pool закрывает старый transport? Третий: может ли streaming client безопасно повторить запрос? До первого байта ограниченный retry иногда возможен; после начала потока прозрачный повтор рискует продублировать inference и расход GPU. Именно поэтому DNS failover нельзя оценивать только по HTTP status.
У Envoy DNS discovery работает асинхронно. Официальная документация описывает respect_dns_ttl, отдельную частоту refresh при ошибке и различие strict/logical DNS; для logical DNS живые соединения продолжают существовать, пока их не циклируют. В NGINX динамический resolve зависит от конкретного модуля и версии: например, документация stream upstream указывает появление открытой директивы resolver в контексте upstream в 1.27.3. Перед копированием примера проверяйте edition, module и release.
Надежный canary принудительно создает новый transport, но сохраняет SNI и Host. Для curl можно временно закрепить конкретный адрес через --resolve; это обходит DNS для одного теста и помогает отделить endpoint readiness от resolver path. Не используйте -k: сертификат должен проверяться так же, как в production.
TARGET_IP=203.0.113.20
curl --fail-with-body --silent --show-error \
  --resolve api.example.net:443:$TARGET_IP \
  https://api.example.net/health/ready

curl --fail-with-body --no-keepalive \
  --resolve api.example.net:443:$TARGET_IP \
  https://api.example.net/v1/models
Если прямой canary проходит, а обычный клиент остается на старом peer, работайте с lifecycle pool: max connection age, drain, reload или rolling restart выбранной cohort. Если прямой canary не проходит, DNS refresh лишь быстрее отправит пользователей на неготовый endpoint. Это disqualifier для переключения, а не повод еще сильнее уменьшать TTL.
Не смешивайте A и AAAA: dual-stack меняет картину отказа
Одинаковое имя может возвращать IPv4 и IPv6, а клиент выбирает семейство согласно своей реализации и состоянию сети. Вы удалили старую A-запись, но забыли AAAA; часть клиентов продолжит попадать на прежнюю площадку по IPv6. Или новый AAAA уже опубликован, но маршрутизация, firewall либо сертификат на новом пути не готовы. Общий график «DNS success» при этом будет зеленым.
Проверяйте A и AAAA независимо на каждом уровне, а затем фиксируйте выбранный peer. Важна не абстрактная доступность адреса, а полный путь: source network → routing → firewall/NAT → TLS SNI → endpoint readiness. Пример из практики: внешний мониторинг по IPv4 видит новую площадку, а worker nodes с рабочим IPv6 продолжают открывать старый endpoint. Команда считает failover завершенным, пока нагрузка на исходном GPU pool не исчезает.
Не выключайте IPv6 как универсальный fix. Это меняет сеть шире инцидента и маскирует несогласованную публикацию записей. Гораздо безопаснее на canary явно проверить обе семьи, затем синхронизировать health и routing policies. Если приложение поддерживает Happy Eyeballs или сходную гонку адресов, запишите, какой результат победил и почему; порядок массива getaddrinfo сам по себе не гарантирует выбранный маршрут.
Еще один отрицательный контроль: временно направьте тестовый клиент на старый IP через --resolve и убедитесь, что после drain он действительно перестал принимать новые запросы либо отвечает ожидаемым maintenance status. Если старый endpoint остается полностью рабочим, вы не доказали перенос, вы только добавили второй путь.
Runbook переключения: от записи к application SLO
Плановый failover начинается не с редактирования DNS, а с подготовки целевой площадки. Загрузите нужную версию модели, проверьте tokenizer и runtime, прогрейте только в пределах принятой политики, подтвердите health отдельно от mere process liveness. Новый endpoint должен пройти TLS, auth, quota и representative inference canary. Для streaming запроса измеряйте как минимум connect, время до первого байта, межтокенный прогресс и полное завершение.
За один или несколько TTL до окна убедитесь, что authoritative TTL действительно уменьшен и уже успел распространиться. Снижение TTL за минуту до изменения не влияет на ответы, ранее закэшированные с прежним значением. Отдельно проверьте SOA для negative answers: случайный предварительный запрос к еще несуществующему имени может оставить NXDOMAIN именно тогда, когда вы начнете rollout.
Во время изменения двигайтесь по gates. Gate 1: все authoritative отвечают новым RRset. Gate 2: выбранные recursive resolvers отдают новый ответ после ожидаемого срока. Gate 3: canary hosts получают его через свой effective resolver. Gate 4: новый connection устанавливается с целевым peer IP. Gate 5: LLM application canary проходит по качеству протокола и SLO. Между gates должен быть stop condition; не продолжайте rollout, если предыдущий слой не доказан.
После этого дренируйте старые connection pools контролируемо. Для прокси лучше иметь versioned policy max connection duration и graceful drain, чем массово убивать процессы. Для прямых SDK-клиентов раскатывайте настройки cohort-ами: один node pool, затем небольшой процент, затем весь fleet. Следите одновременно за old/new peer distribution, DNS failures, connect/TLS errors, first-byte latency и незавершенными streams.
Rollback должен быть симметричным: вернуть RRset недостаточно, если клиенты уже удерживают соединения с новой площадкой. Повторите те же gates в обратном направлении, восстановите baseline pool policy и убедитесь, что новая площадка перестала получать новые соединения. Так rollback становится проверяемой процедурой, а не надеждой на TTL.
Canary и отрицательный контроль: докажите механизм, а не корреляцию
Хороший canary отличается от обычного smoke test тем, что связывает DNS-ответ с конкретным transport и результатом приложения. В журнале одной попытки должны встретиться: timestamp, node/cohort, resolver, A/AAAA answer с TTL, resolved address, actual peer, reused или new connection, HTTP/gRPC outcome и streaming milestones. Тогда спор «это DNS или приложение» заканчивается данными.
Добавьте отрицательный контроль. Если гипотеза говорит, что старый application cache удерживает адрес, новый процесс с пустым cache должен выбрать новый peer, а долгоживущий процесс — старый. Если оба ведут себя одинаково, гипотеза ослабла. Если проблема якобы в recursive resolver, прямой запрос к authoritative и canary через другой recursive должны разойтись предсказуемо.
Canary должен быть production-sized по протоколу, но ограниченным по blast radius. Не обязательно генерировать большую нагрузку: достаточно реального TLS, auth и короткого запроса к той же модели. Не используйте только /health, если он обслуживается отдельным процессом без GPU/runtime dependency. Проверка списка моделей, короткий inference и корректное завершение stream дают более сильное доказательство.
Заранее назначьте владельцев: DNS zone, recursive resolver, host image, egress proxy, application SDK и inference endpoint. Иначе в инциденте все видят старый IP, но никто не владеет последним кэшем. Для выделенного gateway ценность как раз в этой границе контроля: единая versioned policy, наблюдаемый peer и предсказуемое окно drain. Но если причина — leak соединений или неверный retry, замена VPS на dedicated ее не устранит.
Когда DNS failover подходит, а когда нужен proxy или Anycast
DNS failover подходит, когда новые соединения могут терпеть eventual convergence, клиенты уважают refresh policy, а старую площадку можно держать до окончания drain. Это разумный базовый вариант для контролируемых server-to-server клиентов. Его сильная сторона — простота control plane; слабая — неодинаковое поведение resolver и application pools.
Центральный L4/L7 proxy полезен, когда нужно быстрее управлять health, connection lifecycle, auth, quotas и наблюдаемостью. Различие слоев важно: L4 сохраняет transport transparency, L7 понимает HTTP path и headers, но приносит buffering, timeout/retry policy и дополнительный on-call debt. Подробное сравнение для streaming API есть в статье о L4 и L7 перед LLM API.
Anycast решает другую задачу: routing приводит клиента к ближайшей или доступной точке объявления, но внутри каждой точки все равно нужны health, capacity и data/model consistency. Не считайте его «DNS без TTL». Архитектурные границы и operational trade-offs разобраны в материале о BGP Anycast.
Для private AI API часто полезна двухступенчатая схема: стабильное публичное или приватное имя ведет на контролируемый gateway, а gateway обнаруживает GPU backends и дренирует их по своей политике. Это добавляет компонент, зато концентрирует ownership. Общая архитектура gateway, квот и маршрутизации описана в гайде по Private AI API; текущий runbook дополняет ее именно DNS/transport evidence.
Выбирайте не по минимальному TTL, а по требуемому recovery envelope и возможностям команды. Если SLO стабилен и нет подтвержденной проблемы, не усложняйте. Если клиенты разнородны и вы не можете наблюдать их peer, proxy дает контроль. Если нужен глобальный вход с быстрым routing convergence, рассматривайте Anycast, сохраняя application health gates.
Метрики и алерты, которые действительно ловят DNS-инцидент
Один алерт на NXDOMAIN недостаточен. Соберите небольшой evidence set по слоям. На resolver: query volume, cache hit/miss, SERVFAIL/timeouts, stale answers и latency. На transport: новые connections, connect/TLS errors, peer IP distribution, connection age и drain state. На LLM API: admission, time to first token, idle-progress timeout, completed/cancelled streams и загрузка целевого GPU pool.
Коррелируйте по cohort и адресу, а не только по имени. Если 20% worker nodes продолжают использовать старый peer, общий success rate может выглядеть нормально, пока старую площадку не выключат. Полезен алерт на «старый peer получает новые connections после deadline», а не просто на наличие активных connections: длинные допустимые streams могут жить дольше окна переключения.
Логируйте DNS осторожно. Полный поток запросов может содержать внутренние имена и создавать большой объем. Для production достаточно агрегатов и выборочного canary trace; подробный resolvectl monitor включайте на ограниченное время. Храните timestamp и TTL рядом с результатом, иначе невозможно понять, был ли ответ действительно просроченным.
Наконец, проводите game day. Опубликуйте canary record с коротким контролируемым TTL, переключите между двумя тестовыми endpoints и измерьте фактическое время на каждом слое. Затем повторите с недоступным recursive upstream, чтобы увидеть serve-stale behavior. Не смешивайте этот тест с production model upgrade: одна переменная за раз делает rollback и выводы честными.
Определите бюджет ложных срабатываний заранее. Короткий всплеск cache miss после плановой смены записи ожидаем, а устойчивый рост SERVFAIL вместе с падением новых TLS-соединений — уже stop condition. Для старого peer задайте deadline, но исключите соединения, открытые до rollout и все еще передающие валидный stream. Такой разрез не наказывает корректные длинные ответы и одновременно замечает новые dial на устаревший адрес. После каждого game day обновляйте только те пороги, которые подтверждены наблюдением, а не удобной круглой цифрой.
Итог: управляйте состоянием, а не числом в TTL
DNS failover для LLM API надежен только тогда, когда команда видит всю цепочку состояния. Authoritative запись может быть свежей, recursive resolver — держать negative или stale data, приложение — собственный cache, а transport — старое живое соединение. TTL управляет RRset, но не заменяет drain, endpoint readiness и application canary.
Практический следующий шаг прост: выберите один production-подобный клиент и соберите для него evidence line «DNS answer → actual peer → LLM outcome». Затем выполните canary-переключение с отдельными A/AAAA, отрицательным контролем и симметричным rollback. Если результат нельзя объяснить по этим трем gates, массовый rollout еще рано начинать.
Когда вам нужна инфраструктура для такого теста, ищите не обещание «быстрее DNS», а контролируемую среду: выделенный gateway или node pool, наблюдаемый сетевой путь, право на drain/restart и воспроизводимый hardware profile для целевой модели. На VPS это удобно проверять в малом blast radius; на dedicated-серверах проще закрепить ресурсы и окно изменений. Главное — сначала доказать bottleneck. Тогда архитектура будет лечить конкретную проблему, а не просто добавлять еще один слой.
Зафиксируйте baseline сегодня, пока все работает: authoritative ответы, реальные resolver, peer IP и возраст соединений. В следующем инциденте эти пять минут подготовки сэкономят гораздо больше времени и позволят переключить LLM API без догадок.