Оглавление
- Сначала выясните, где исчезает трасса
- Постройте путь одной трассы
- Head sampling и tail sampling решают разные задачи
- Длинный ответ и поздние spans
- Один trace ID должен попасть к одному sampler
- Рассчитайте бюджет памяти и найдите раннее вытеснение
- Выберите политики по наблюдаемому результату
- Приватность начинается до выборки
- Canary и симметричный rollback
- Короткий порядок действий при пропаже трасс
- Что проверить перед внедрением
Готовы перейти на современную серверную инфраструктуру?
В King Servers мы предлагаем серверы как на AMD EPYC, так и на Intel Xeon, с гибкими конфигурациями под любые задачи — от виртуализации и веб-хостинга до S3-хранилищ и кластеров хранения данных.
- S3-совместимое хранилище для резервных копий
- Панель управления, API, масштабируемость
- Поддержку 24/7 и помощь в выборе конфигурации
Результат регистрации
...
Создайте аккаунт
Быстрая регистрация для доступа к инфраструктуре
Сначала выясните, где исчезает трасса
HTTP-запрос к модели вернул ошибку, а в системе наблюдаемости его трассы нет. При этом Collector отвечает на health check, GPU загружен, а на графике экспорта не видно очевидного провала. Покупать больше памяти для backend или сразу увеличивать процент выборки рано: сначала важно понять, попали ли spans в Collector, встретились ли они на одной реплике и дождалось ли решение sampling фактической ошибки.
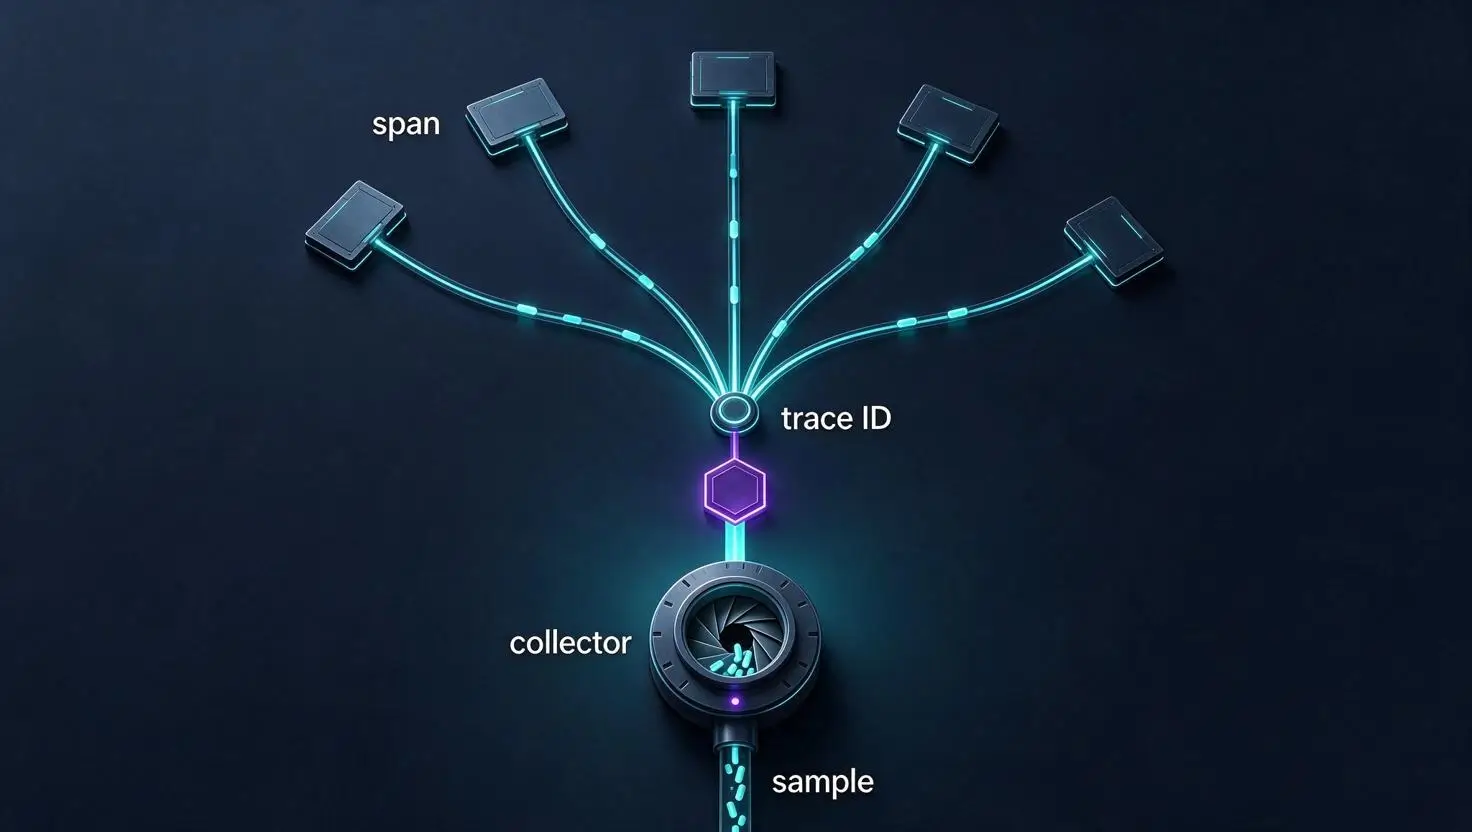
Tail sampling принимает решение после накопления данных о трассе. Это позволяет оставить, например, ошибки и медленные запросы, а часть обычных трасс отбросить. Но такой подход не восстанавливает spans, потерянные раньше по пути. Если SDK уже отбросил запрос на входе, downstream Collector не сможет «спасти» его по позднее обнаруженной ошибке.
Для проверки выберите тестовый запрос с известным trace ID и заранее определённым исходом. Сравните его с успешным контрольным запросом через тот же gateway и ту же версию приложения. Зафиксируйте время запроса, версию Collector, адрес приёма, идентификатор трассы и ожидаемые сервисы. Не помещайте в тест реальные персональные данные или секреты.
Удобный результат первого этапа — таблица четырёх границ: приложение создало spans; Collector получил их; sampler принял решение; backend сохранил результат. Наличие записи на одной границе не доказывает успех на следующей. Такой разбор особенно полезен для LLM: ошибка может возникнуть не при установлении HTTP-соединения, а после начала потока токенов.
Постройте путь одной трассы
Типичный путь состоит из инструментированного gateway, сервиса retrieval, inference backend и одного или нескольких Collector. В каждом сервисе создаются spans с общим trace ID и связями parent-child. Затем данные проходят приёмник OTLP, процессоры и экспортер, прежде чем попасть в хранилище трасс. Отдельные сигналы — метрики и логи — имеют собственные pipelines и не обязаны наследовать решение для трасс.
Начните с карты реального пути, а не предполагаемой схемы. На каком процессе завершается TLS? Какой SDK создаёт корневой span? Кто передаёт контекст в очередь или к inference worker? Есть ли прокси, который сбрасывает заголовки? Нарисуйте границу доверия: некоторые участки могут передавать не один HTTP-запрос, а асинхронную задачу.
Проверьте распространение контекста на каждом переходе. Отсутствие дочернего span не обязательно означает ошибку sampler: сервис мог не экспортировать его, создать новую трассу или завершиться до отправки. Сравнение trace ID и времени на соседних этапах полезнее предположения о конкретном компоненте. Для контролируемого эксперимента используйте ограниченный стенд или тестовый tenant, а не вывод содержимого всех запросов в общий лог.
Общий обзор OpenTelemetry: traces, metrics и logs поможет проверить базовые понятия. Здесь задача уже: доказать, что выборка сохраняет нужные трассы при контролируемом расходе ресурсов.
Head sampling и tail sampling решают разные задачи
Head sampling решает судьбу трассы при её начале, когда конечный результат ещё неизвестен. Его преимущество — ограничение объёма данных ближе к источнику. Недостаток для расследования редких ошибок очевиден: запрос, который сначала выглядел обычным, позже может закончиться отказом, но его полная трасса уже не будет записана.
При tail sampling Collector удерживает данные некоторое время и применяет политики к накопленным spans. Это позволяет учитывать видимые к моменту решения признаки, например статус ошибки или задержку. Но «оставлять ошибки» означает ошибки, которые действительно представлены в полученных spans до решения. HTTP 200 сам по себе не доказывает успешное завершение streaming-ответа, а семантическая ошибка ответа модели не обязана автоматически становиться span со статусом ERROR.
Составьте список сигналов, которые приложение реально устанавливает: ошибка вызова модели, отмена клиентом, превышение внутреннего deadline, завершение потока и время до первого токена. Решите, какие признаки являются техническими отказами, а какие — отдельными продуктовыми метриками. Не меняйте статус каждого отменённого клиентом запроса на ошибку без согласованной семантики: иначе sampler сохранит много событий, не отвечающих вашему вопросу.
Хороший отрицательный контроль — обычный быстрый запрос без ошибки. Положительный контроль — искусственно вызванный отказ на изолированном тестовом маршруте. Сопоставляйте не только число сохранённых traces, но и полноту ожидаемых spans. При смешивании head и tail sampling заранее оцените, какую долю ошибок источник вообще отправляет на следующий этап.
Длинный ответ и поздние spans
У LLM streaming начало ответа и его окончание могут быть разделены длительной паузой. Если корневой span завершается только после последнего токена, sampler с коротким окном может принять решение по неполной картине. Поздний дочерний span иногда наследует уже принятое решение, но сам больше не влияет на выборку; если решение успело исчезнуть из кэша, возможны другие исходы. Поведение зависит от версии и настроек процессора.
Параметр decision_wait — не универсальный тайм-аут пользовательского запроса. Это часть механизма ожидания sampler. Значение следует выбирать по фактическому распределению времени прихода spans и допустимой задержке появления трассы, а не копировать из чужой конфигурации. Увеличение окна обычно означает больше одновременно удерживаемых трасс и дополнительную нагрузку на память.
Проведите два опыта: короткий запрос и искусственно удлинённый stream, который завершается контролируемой ошибкой. Для каждого проверьте время появления корневого и дочерних spans и наличие итогового статуса. Убедитесь, что тест не обходит production-путь экспорта. Если сбой проявляется только после начала потока, проверьте обработчик закрытия соединения и фактическое завершение span в приложении.
Не пытайтесь лечить каждую долгую операцию одним большим окном. Иногда полезнее изменить модель инструментирования, разделить операции на осмысленные spans или собирать отдельную метрику исхода. Если приложение не сообщает об ошибке до sampling decision, увеличение числа реплик Collector эту информацию не создаст.
Один trace ID должен попасть к одному sampler
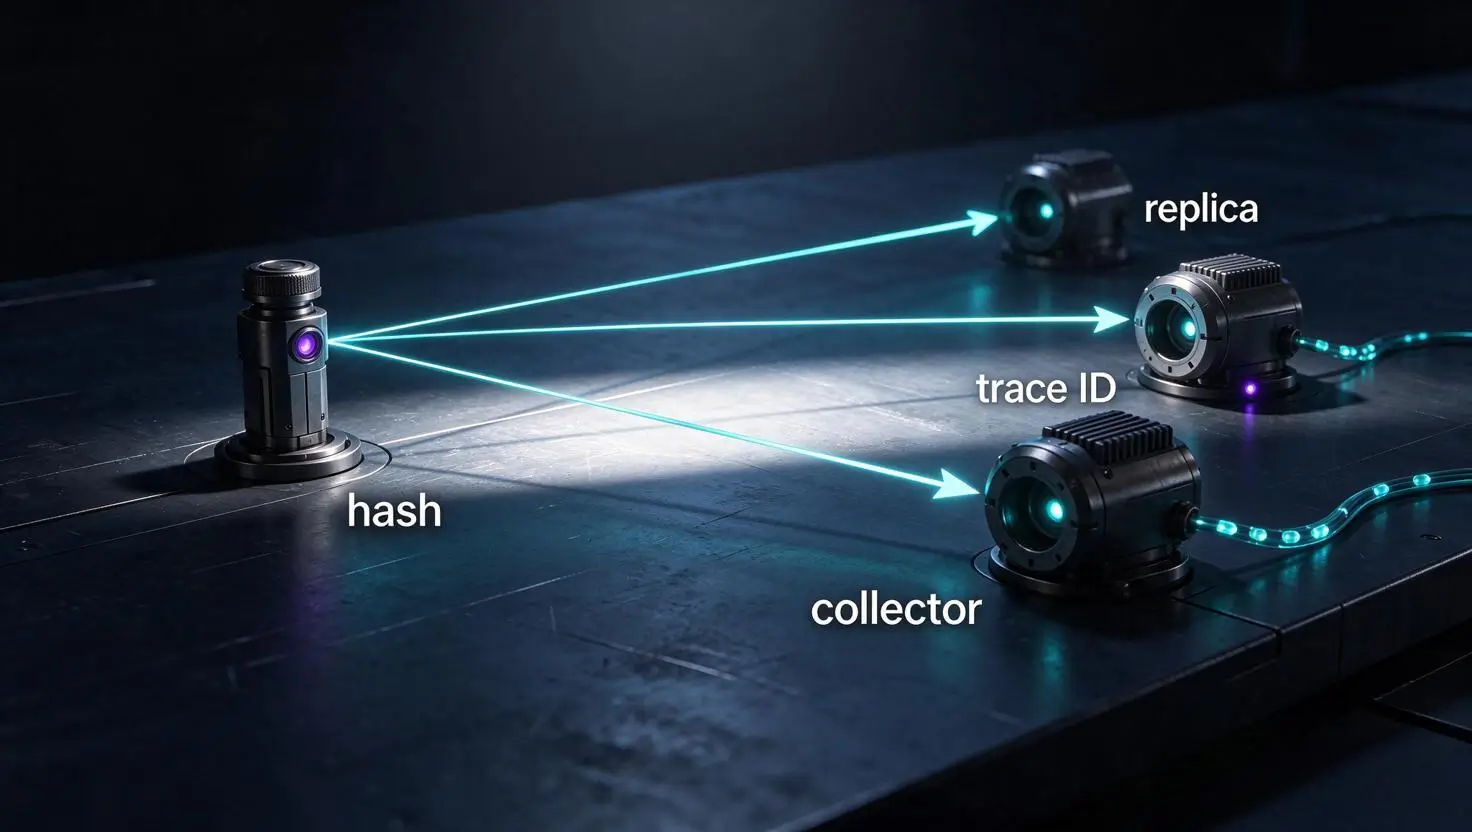
Tail sampler принимает решение по тем spans, которые видит конкретная реплика. Обычное балансирование соединений не гарантирует, что gateway и inference worker отправят части одной трассы одному экземпляру. Результат — неполные трассы и решения, принятые по разным фрагментам, хотя каждый экземпляр Collector по отдельности выглядит здоровым.
Распространённая архитектура использует первый уровень Collector для приёма и маршрутизации по trace ID, а второй — для tail sampling. Официальный load balancing exporter поддерживает такую маршрутизацию. Проверяйте конфигурацию и состав используемого дистрибутива в закреплённой версии: имя компонента loadbalancing в актуальной документации обозначено как устаревший alias для load_balancing, а поддержка traces имеет статус beta.
Согласованность не бесплатна. Добавление или удаление реплики меняет множество получателей; часть уже идущих трасс может попасть к другой реплике. Перезапуск также теряет удерживаемое в памяти состояние, если конкретное развёртывание не обеспечивает его сохранение. Проверьте, как ваш resolver видит terminating endpoints и как выполняются drain и обновление списка адресов.
Для проверки отправьте известную трассу через несколько сервисов и сравните, какая реплика sampler получила каждый span. Затем повторите тест во время управляемого изменения числа реплик. Сохраните контрольную трассу без изменения топологии. Цель — измерить полноту и потери в окне изменения, а не просто убедиться, что после масштабирования поступают новые запросы.
Рассчитайте бюджет памяти и найдите раннее вытеснение
Collector должен удерживать одновременно активные трассы и связанные с ними spans. Грубая отправная оценка — скорость новых трасс, умноженная на окно ожидания, плюс запас на неравномерность и задержки. Это оценка количества трасс, не размера памяти: число spans, атрибуты, события и накладные расходы в разных workloads различаются. Измеряйте RSS и поведение процесса на нагрузке, близкой к вашей.
Параметр num_traces ограничивает число трасс в буфере процессора. Если буфер переполнен, старые трассы могут быть удалены до решения. Повышение лимита без проверки доступной памяти способно перенести проблему в OOM и потерю сразу большой группы данных. Уменьшение окна снижает время удержания, но повышает риск принять решение до поздних spans.
Официальная документация tail sampling processor описывает метрики раннего удаления, возраста удаления и задержки таймера решения. Сверяйте их имена и доступность с закреплённой версией, поскольку компоненты и их телеметрия меняются. Смотрите изменение счётчиков за интервал, а не только накопленное значение с момента старта.
Пример: если в ходе нагрузки вырос счётчик раннего удаления, одновременно сравните входящий поток, размер очередей, память и возраст удаляемых трасс. Затем измените один параметр на canary. Если счётчик улучшился, но появились OOM или очередь экспорта, проблема не решена. Отдельно проверьте ограничения контейнера и ресурсы узла: свободная память хоста не равна доступному лимиту контейнера.
Для планирования ёмкости важна и форма нагрузки. Всплеск после повторной отправки очереди может кратковременно создать больше незавершённых трасс, чем обычный средний поток. Поэтому среднее за сутки не подходит как единственная база расчёта. Снимайте распределение за короткие интервалы, учитывайте число одновременно активных requests и проверяйте поведение после временной недоступности backend.
Проводя нагрузочный тест, фиксируйте версию образа и конфигурацию. Тот же лимит num_traces при разном количестве spans и размере атрибутов может давать разное потребление памяти. Установите предупреждения до точки отказа и отдельно проверьте, кто получит уведомление. Если sampler перезапускается из-за ограничения памяти, проверьте не только причину рестарта, но и сколько проверочных трасс исчезло в переходном окне.
Выберите политики по наблюдаемому результату
Начните с небольшого набора решений, который можно объяснить дежурному инженеру: сохранить видимые ошибки, сохранить достаточно медленные операции и оставить случайную долю остальных трасс для контекста. Порог задержки выбирается из SLO и распределения конкретного маршрута, а не из примера конфигурации. Для длинного stream общая длительность, время до первого токена и пауза между токенами описывают разные проблемы.
Комбинирование политик требует отдельной проверки: порядок и семантика решений могут меняться между версиями процессора. Перед внедрением прочитайте документацию именно вашей версии и проверьте сценарии в тесте. Ошибка в составном условии способна оставить гораздо больше трасс, чем ожидалось, либо отбросить нужные. Политика не является гарантией, если span со статусом ошибки не дошёл до sampler вовремя.
Составьте матрицу из четырёх случаев: быстрый успех, медленный успех, техническая ошибка до первого байта и ошибка после начала потока. Для каждого заранее укажите ожидаемое решение и необходимые spans. Добавьте отрицательный случай, который не должен попадать в выборку по ошибочной причине. Результат проверяйте по trace ID в хранилище, а не только по счётчику принятых spans.
Вероятностная доля сохранённых обычных запросов не превращает выборку, специально обогащённую ошибками, в непредвзятое представление обо всём трафике. Для частоты ошибок и SLO используйте подходящие метрики на полном потоке или корректно рассчитанную статистику. Выборочные traces хороши для расследования конкретного пути, но не должны без оговорок заменять счётчик всех запросов.
Приватность начинается до выборки
Даже если backend хранит небольшую долю трасс, tail sampler сначала получает гораздо больше данных. Поэтому вопрос безопасности возникает до решения об отборе. Prompt, ответ модели, документы retrieval, токены доступа и значения пользовательских атрибутов могут оказаться в памяти Collector, очередях или логах отладки. Сам sampling не является механизмом маскирования.
По умолчанию избегайте записи содержимого prompt и completion, если оно не требуется для конкретной задачи и не разрешено политикой организации. Для расследования задержки обычно достаточно технических атрибутов: имени сервиса, версии модели, времени, статуса и безопасных идентификаторов. Сверяйте набор атрибутов с правилами доступа, сроком хранения и требованиями к удалению данных.
В реестре атрибутов GenAI часть полей помечена как потенциально чувствительная, а семантические соглашения продолжают развиваться. Не считайте их имена и статус неизменными: зафиксируйте используемую версию SDK и conventions. Контролируемый rollout должен включать проверку фактически отправляемых полей, а не только просмотр настроек приложения.
Проверьте права на Collector, TLS между этапами, доступ к backend, журналы ошибок и резервные копии. Если нужна фильтрация, предпочтительно не создавать лишние чувствительные данные в источнике; дополнительная обработка в Collector полезна как второй барьер. На тесте используйте синтетический маркер и убедитесь, что он отсутствует в конечном хранилище и диагностических логах там, где его быть не должно.
Canary и симметричный rollback
Сначала сохраните baseline: текущие правила sampling, версию образа и конфигурации, число реплик, ресурсные лимиты, входящий объём, ошибки экспорта и полноту тестовых трасс. Определите владельца каждого изменения и критерии остановки. Например, рост раннего вытеснения, недоступность экспорта или утечка чувствительного поля — причины остановить эксперимент, а не усреднить результат за сутки.
На canary меняйте один контролируемый фактор: скажем, политику sampling при прежних маршрутизации и ресурсах. Проведите одинаковый набор коротких, длинных, ошибочных и контрольных запросов. Для анализа сохраните trace ID и ожидаемый набор сервисов, не сохраняя пользовательское содержимое. Важно проверить как момент ответа клиенту, так и последующее завершение backend-работы.
Схема A/B/A означает baseline, изменение и возврат к baseline с повторением тех же проверок. При откате верните не только YAML, но и прежнее число реплик, маршрутизацию и лимиты, если они менялись. Сверьте состояние уже начатых длинных трасс: они могут пережить переключение и попасть в переходное окно. Зафиксируйте длительность окна и кто принимает решение о завершении drain.
Если диагностирована нехватка управляемой памяти или нужна предсказуемая изоляция Collector, сравните VPS и выделенный сервер по наблюдаемости, лимитам и ответственности за обновления. Но новое железо не исправит потерянный контекст, слишком раннее решение или отсутствие статуса ошибки. Сначала докажите границу ресурса на нагрузочном профиле, затем выбирайте инфраструктуру.
В Kubernetes перед изменением определите namespace и точное имя Deployment. Следующие команды демонстрируют просмотр статуса и истории для примера otel-sampler; замените имя и namespace на свои. Они не проверяют полноту трасс и не подтверждают, что применённая политика работает правильно. Для этого всё равно нужны тестовые trace ID и проверка backend.
Откат Deployment возвращает предыдущую ревизию шаблона, но не обязательно восстанавливает отдельно изменённый ConfigMap, внешний сервис или настройки отправителей. Если конфигурация хранится вне шаблона, сохраните её версию и восстановите соответствующие объекты по процедуре вашей команды. Проверьте, что в истории действительно находится нужная ревизия, прежде чем выполнять изменение.
Рядом полезны два материала о соседних границах: HTTP/2 flow control для LLM streaming помогает отличить сетевую паузу от проблем наблюдаемости, а TCP_USER_TIMEOUT для LLM streaming разбирает зависшие соединения. Эти механизмы не заменяют проверку выборки и не должны диагностироваться только по отсутствию трассы.
kubectl -n observability rollout status deployment/otel-samplerkubectl -n observability rollout history deployment/otel-samplerkubectl -n observability rollout undo deployment/otel-sampler --dry-run=server
Короткий порядок действий при пропаже трасс
Когда инцидент уже идёт, не меняйте несколько параметров одновременно. Найдите пример запроса, который должен был сохраниться, и запишите его trace ID, время и ожидаемый исход. Сравните его с успешным запросом на том же маршруте. Проверьте, что оба прошли через известную версию приложения и что диагностические данные не содержат секретов.
Далее пройдите по цепочке: создал ли SDK span; был ли контекст передан следующему сервису; получил ли Collector нужные фрагменты; попали ли они на одну реплику; дождался ли sampler результата; принял ли exporter данные; доступна ли запись в backend. На каждом этапе полезен отдельный контроль. Ответ «Collector работает» закрывает лишь небольшой участок этой цепочки.
Если проблема связана с масштабированием, сравните результат до и во время изменения состава реплик. Если со временем ожидания — проведите короткий и длинный stream. Если подозреваете память — сопоставьте раннее удаление, возраст трасс в буфере и ограничения контейнера. В каждом случае выберите одну гипотезу, безопасную проверку и заранее определённый rollback.
Наконец, проверьте пользовательский результат. Полная трасса не исправляет ошибку inference, но должна помогать её локализовать; уменьшение объёма данных не является успехом, если при этом исчезают важные сбои. Запишите вывод и владельца следующего действия в журнал инцидента, чтобы следующий дежурный мог повторить проверку без догадок.
Что проверить перед внедрением
Tail sampling полезен, когда команда понимает, какие признаки ошибок и задержек доступны до решения и сколько ресурсов стоит удержание трасс. Его главные ограничения — потери до Collector, разрыв одной трассы между репликами, поздние spans, переполнение памяти и чувствительные данные. Ни одно значение конфигурации не устраняет эти риски автоматически.
Начните с одной тестовой трассы и карты её пути. Затем проверьте положительный и отрицательный сценарии, измерьте расход памяти и проведите A/B/A на ограниченном трафике. После этого можно принимать решение о масштабе развёртывания и инфраструктуре, опираясь на наблюдаемый результат, а не только на состояние отдельных компонентов.