Готовы перейти на современную серверную инфраструктуру?
В King Servers мы предлагаем серверы как на AMD EPYC, так и на Intel Xeon, с гибкими конфигурациями под любые задачи — от виртуализации и веб-хостинга до S3-хранилищ и кластеров хранения данных.
- S3-совместимое хранилище для резервных копий
- Панель управления, API, масштабируемость
- Поддержку 24/7 и помощь в выборе конфигурации
Результат регистрации
...
Создайте аккаунт
Быстрая регистрация для доступа к инфраструктуре
GOAWAY не равен аварии: сначала прочитайте frame
HTTP/2 GOAWAY — это frame уровня соединения. По RFC 9113, раздел 6.8, endpoint отправляет его, когда перестаёт принимать новые streams на текущем connection, но может закончить уже начатые. Поэтому запись received GOAWAY без error code, Last-Stream-ID и точки отправки почти бесполезна: она сообщает о событии, но не о причине.
Смотрите на три поля. NO_ERROR часто сопровождает плановый drain или ограничение возраста соединения. ENHANCE_YOUR_CALM вместе с debug data too_many_pings указывает на несовместимую keepalive policy. PROTOCOL_ERROR, FLOW_CONTROL_ERROR и другие коды требуют проверки конкретного hop и реализации. Last-Stream-ID отделяет streams, которые могли быть обработаны, от тех, которые endpoint гарантированно не принял.
Мини-кейс: во время rolling restart два клиента видят GOAWAY/NO_ERROR. Первый бесшовно открывает новый connection, второй роняет streaming RPC. Причина не в самом GOAWAY, а в том, что второй клиент не умеет корректно пережить drain уже начатого вызова. Главный вопрос к инциденту: что произошло с конкретным RPC, а не «почему сервер прислал GOAWAY».
Найдите владельца каждого HTTP/2 connection
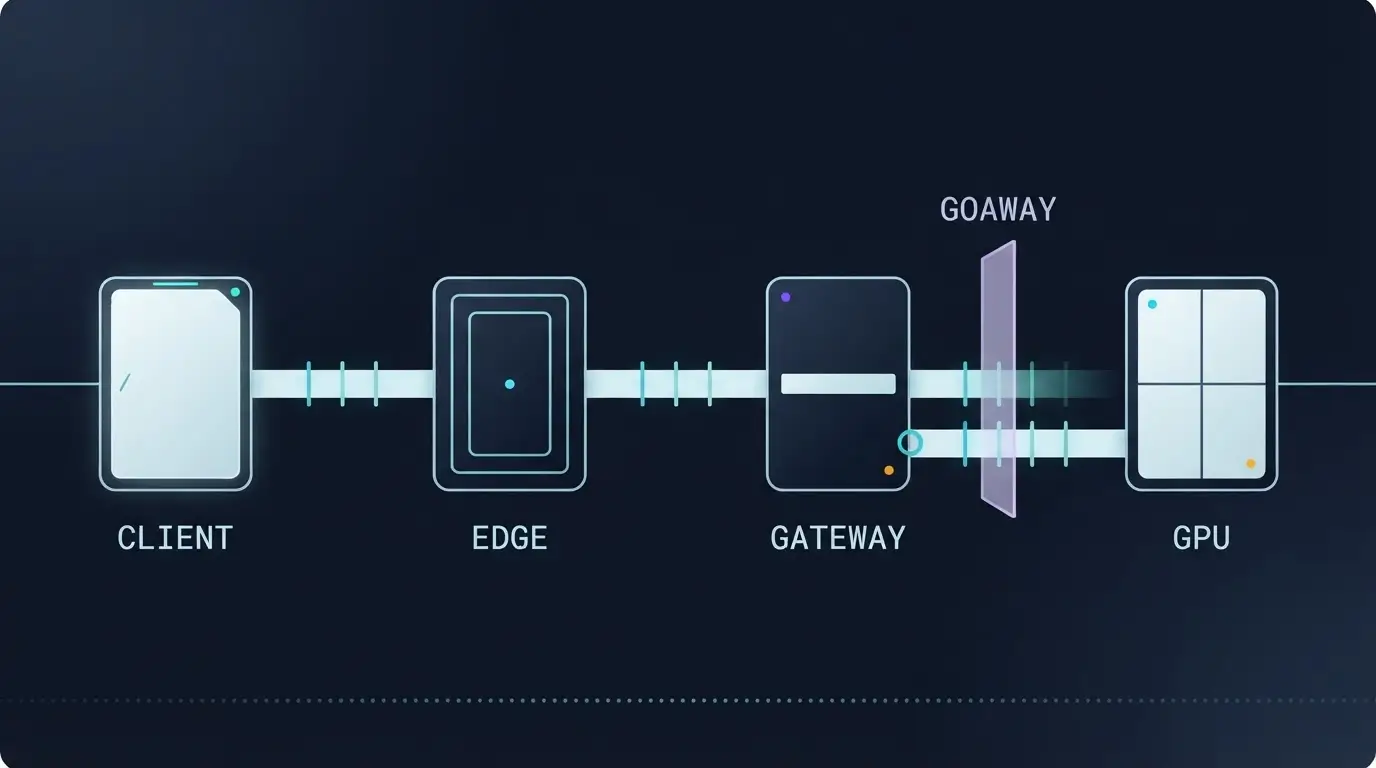
В production один логический запрос обычно проходит несколько transport-плечей: клиент → edge/LB, edge → gateway, gateway → inference backend. На каждом плече свой HTTP/2 connection, свои PING, idle timeout, max connection age и drain. Настройка gRPC-клиента не меняет upstream connection Envoy, а TCP keepalive в NGINX не заменяет gRPC HTTP/2 PING. Пока команда не нарисовала эти границы, она меняет параметры наугад.
Составьте карту: кто инициирует connection, где завершается TLS, какой компонент отправил GOAWAY и где RPC становится application work. Сопоставьте request ID или trace ID на входе и выходе gateway. Если событие видно только downstream, проверяйте edge и клиентскую библиотеку. Если upstream cluster одновременно закрывает много streams, ищите drain, max connection duration, рестарт sidecar либо backend gRPC server.
Полезный контрфакт: временно направьте небольшой canary напрямую к тому же backend через отдельный контролируемый hop. Если GOAWAY исчез, это не доказывает вину GPU-сервера; оно локализует проблему в исключённом intermediary. Близкие темы — TLS handshake storm на LLM gateway и HTTP/3 для AI API, но здесь нас интересует именно lifecycle HTTP/2 connection.
Соберите evidence chain до изменения таймаутов
Нужны три независимых доказательства. Первое — transport evidence: error code, debug data, Last-Stream-ID, направление и момент GOAWAY. Второе — effective state: фактические параметры клиента, proxy и сервера на затронутом pod или узле, а не только desired YAML в репозитории. Третье — application outcome: доля успешных RPC, TTFT, завершение stream, wasted GPU work и повторная обработка.
Начните со структурированного access log. Envoy умеет записывать protocol, response flags, duration, upstream host и request ID; официальный формат описан в документации access logging. Добавьте channelz или transport logs в gRPC-клиенте там, где библиотека это поддерживает. Не делайте packet capture единственным источником: при TLS он покажет TCP lifecycle, но не расшифрует HTTP/2 frames без ключевого материала.
Пример: deployment считает rollout успешным, readiness зелёный, но пик UNAVAILABLE точно совпадает с завершением старых pods. Transport log показывает NO_ERROR, а application trace — что часть streams уже получила response headers. Значит, проблема не в detection мёртвого connection: shutdown grace короче реальной длительности stream или клиент повторяет committed вызов.
curl -fsS http://127.0.0.1:9901/stats?filter='http2|cx_destroy|cx_drain|upstream_cx' > /tmp/envoy-http2-stats.txt
kubectl get pods -n inference -o wide > /tmp/inference-pods.txt
kubectl get events -n inference --sort-by=.lastTimestamp > /tmp/inference-events.txt
journalctl -u envoy --since '-15 min' > /tmp/envoy-journal.txt
Согласуйте gRPC keepalive, не создавая ping storm
gRPC keepalive использует HTTP/2 PING, чтобы проверить живость transport, и не равен TCP keepalive. Официальное руководство gRPC отдельно предупреждает: клиентские параметры нужно согласовывать с владельцем сервиса. Если клиент шлёт PING чаще, чем разрешает сервер, тот может закрыть connection через GOAWAY с debug data too_many_pings.
Сначала ответьте, зачем нужен keepalive. Для коротких unary RPC он редко является главным механизмом: deadline и обычная ошибка подключения дают более понятную семантику. Для долгого streaming RPC PING помогает обнаружить сломанный path, когда данные временно не идут. Но слишком агрессивный интервал повышает CPU/traffic overhead и может конфликтовать с policy gateway или managed load balancer.
Меняйте policy в безопасном порядке: сначала сделайте server enforcement совместимым с будущим клиентом, затем раскатывайте клиентские интервалы. Откат — в обратном порядке. Не копируйте «магические 20 секунд» из чужого примера: timeout должен учитывать RTT, потери, TCP retransmission и возможные pause процесса. Disqualifier прост: если active stream регулярно передаёт DATA, а обрывы совпадают с max connection age, keepalive не лечит корень проблемы.
Разведите graceful drain, idle timeout и max connection age
Три таймера часто называют одним словом «таймаут», хотя они решают разные задачи. Idle timeout закрывает неиспользуемый connection. Max connection duration периодически обновляет transport и может распределять клиентов между backend после изменения topology. Drain timeout задаёт окно между уведомлением о закрытии и финальным прекращением connection. У Envoy для HTTP/2 drain предусмотрена последовательность GOAWAY; актуальные поля и поведение проверяйте в официальной таблице timeout.
Для LLM streaming критично сравнить grace window с наблюдаемой длительностью полезного stream, а не со средним unary latency. Если генерация может идти дольше, короткий drain уничтожит работу после уже отправленных токенов. Бесконечный grace тоже плох: старые pods не уходят, rollout зависает, а connection pinning сохраняет неравномерную нагрузку.
Практичный canary: один gateway получает новый max age и drain policy, другой остаётся baseline. Создайте длинный stream, затем инициируйте плановый drain. Новые RPC должны перейти на новый connection; текущий stream — завершиться в пределах согласованного grace. После теста верните canary к baseline и повторите: это отрицательный контроль, который доказывает связь результата именно с policy.
http_connection_manager:
  stat_prefix: llm_gateway
  drain_timeout: 45s
  common_http_protocol_options:
max_connection_duration: 30mНе повторяйте committed RPC вслепую
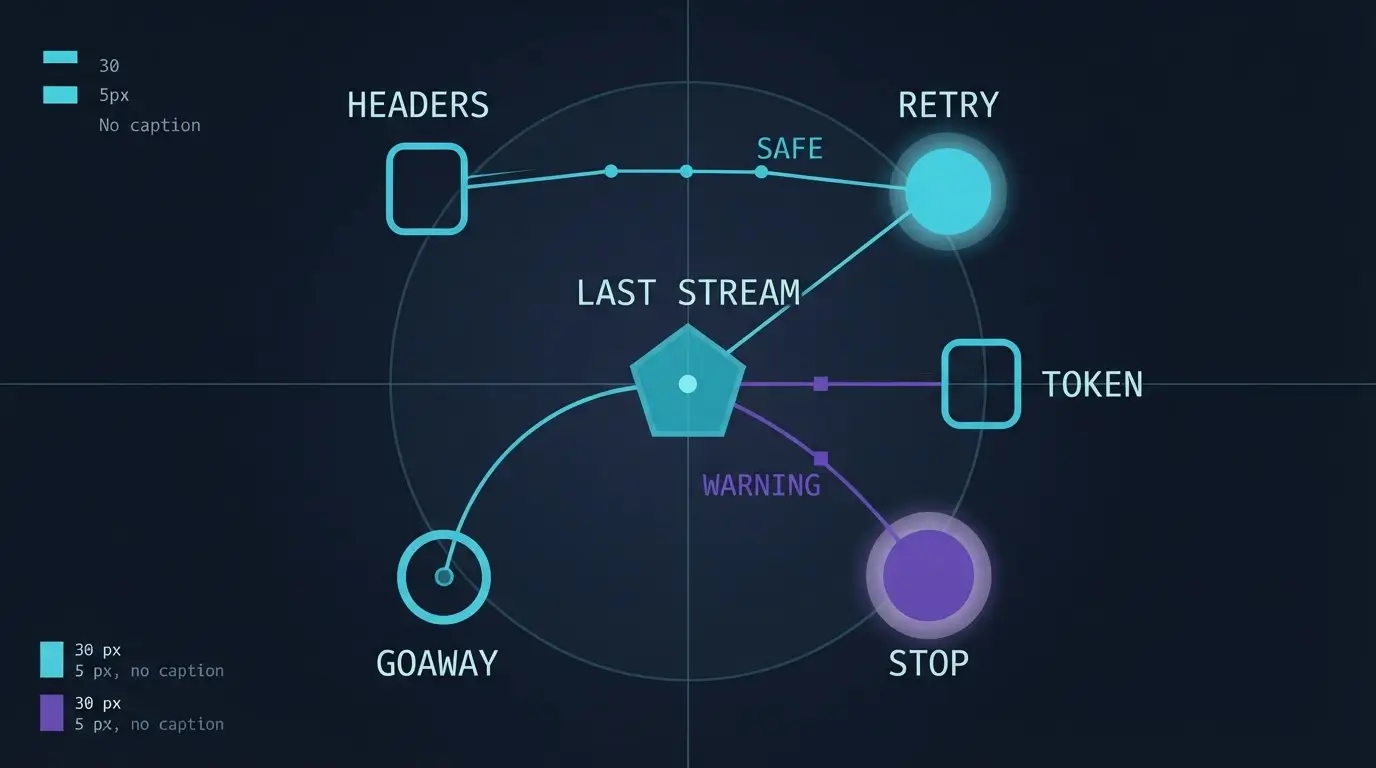
HTTP/2 даёт полезную границу: streams с номером выше Last-Stream-ID из GOAWAY считаются не обработанными и могут быть повторены на новом connection. Для streams с меньшим или равным ID такой гарантии нет. Если connection оборвался без GOAWAY, неопределённость ещё выше. Это особенно важно для LLM API, где POST может уже запустить GPU-работу, списать квоту или записать историю диалога.
gRPC также различает transparent retry и настраиваемую retry policy. В официальном руководстве Retry указано: после получения response headers RPC считается committed, и автоматический retry прекращается. Для application retry одной ошибки UNAVAILABLE недостаточно — нужна идемпотентность, request ID или серверный dedup, оставшийся deadline budget и лимит попыток с backoff.
Streaming response после первого токена нельзя «прозрачно продолжить» на новом connection, если протокол приложения не поддерживает resume token или offset. Правильнее вернуть клиенту явный статус и решить на уровне продукта: начать заново, показать частичный результат или возобновить с checkpoint. Скрытый retry способен удвоить GPU work и создать дубликат операции, хотя transport graph выглядит здоровее.
{
  "methodConfig": [{
    "name": [{"service": "inference.v1.Model", "method": "Generate"}],
    "timeout": "30s",
    "retryPolicy": {
      "maxAttempts": 3,
      "initialBackoff": "0.2s",
      "maxBackoff": "2s",
      "backoffMultiplier": 2,
      "retryableStatusCodes": ["UNAVAILABLE"]
    }
  }]
}
Проведите canary-тест, который отделяет transport от модели
Хороший тест воспроизводит событие и содержит negative control. Подготовьте два одинаковых gateway-пути: baseline и canary. На обоих используйте один backend pool, одну модель и одинаковый prompt-набор. Разница должна быть только в одной policy — например, client keepalive или drain window. Иначе снижение ошибок нельзя приписать конкретному изменению.
Проверьте минимум четыре сценария: короткий unary RPC, долгий server-streaming RPC, idle channel без active call и плановый drain во время активного stream. Для каждого сохраните transport frame/error, фактический peer, gRPC status, количество client attempts и application result. Deadline задавайте явно: по документации gRPC по умолчанию клиент может ждать фактически бесконечно.
Stop condition нужен заранее. Если canary увеличивает retry attempts, wasted GPU work, хвост TTFT или долю незавершённых streams, откатывайте policy даже при уменьшении числа GOAWAY в логах. Снижение transport-событий не является победой, если SLO приложения ухудшился. Проверяли ли вы это после последнего обновления gateway, а не только в synthetic health check?
grpcurl -max-time 30 -H 'x-canary: baseline' gateway.example:443 list
grpcurl -max-time 30 -H 'x-canary: candidate' gateway.example:443 list
# Для production-метода используйте безопасный тестовый tenant и idempotency key.
Алерт должен видеть последствия, а не любой GOAWAY
Алерт на каждый GOAWAY быстро превращается в шум: graceful restart обязан их генерировать. Разделите события по error code, debug data, sender hop и причине drain. Отдельно считайте connections, которые закрылись без GOAWAY, и streams, завершившиеся после получения response headers. Эти категории имеют разную retry semantics и разный риск дубликатов.
На application-слое свяжите transport с четырьмя метриками: доля успешных RPC, TTFT, длительность и completion rate streams, а также wasted work после client cancellation. Добавьте количество attempts на логический request ID. Если attempts растут быстрее полезных завершений, retry маскирует инцидент и умножает нагрузку на GPU.
Не забудьте deployment context: версия client library, gateway build, backend revision и причина shutdown. Для Envoy admin interface держите endpoint на localhost или в защищённой сети: официальная документация предупреждает, что он содержит чувствительные данные и допускает изменяющие операции.
Выберите платформу по границе контроля, а не по обещанию latency
Сначала исправьте client pooling, retry storm и несовместимую keepalive policy. Новое железо этого не лечит. Но placement gateway определяет, чем команда действительно управляет: версией proxy, TLS termination, connection age, drain hooks, conntrack limits, kernel policy и change window. Именно эта граница контроля — честная причина обсуждать VPS или выделенный edge.
Shared VM подходит, когда нагрузка умеренная, transport policy стандартна и допустим небольшой noisy-neighbor risk. Отдельный VPS для gateway даёт изоляцию процесса и понятный rollout, сохраняя быстрый reprovision. Выделенный сервер оправдан, когда нужны стабильный network path, высокий connection churn, точный kernel/IRQ baseline и независимый canary-пул. Managed LB снижает on-call burden, но часть PING, timeout и drain semantics остаётся политикой провайдера.
Decision helper: если вы не можете назвать владельца GOAWAY и измерить application outcome, оставайтесь на текущей платформе и улучшайте observability. Если причина доказана и исправление требует control plane, которого нет, переносите сначала один canary gateway. Материал о BBR и fq для LLM-стриминга полезен после локализации sender и очереди; DNS failover для LLM API — когда проблема связана с выбором нового peer, а не HTTP/2 drain.
Пять ошибок, которые делают инцидент дороже
Ошибка 1 — считать любой GOAWAY потерей запроса. При корректном graceful drain часть активных streams завершится нормально, а новые уйдут на другое соединение. Если алерт не различает NO_ERROR и protocol failure, on-call начинает отменять штатные rollout и ухудшает доступность собственными действиями.
Ошибка 2 — увеличивать все таймауты одновременно. Больший idle timeout, drain grace и RPC deadline могут временно скрыть симптом, но оставят неизвестным работающий механизм. Меняйте один параметр, сохраняйте effective config и возвращайте baseline после canary. Иначе следующий инцидент начнётся с конфигурации, смысл которой уже никто не помнит.
Ошибка 3 — включать keepalive без договора с сервером. Клиент начинает чаще слать PING, server enforcement считает их нарушением и отвечает too_many_pings. Команда видит больше GOAWAY и ещё сильнее уменьшает интервал — получается положительная обратная связь. Сначала расширяйте допустимую server policy, потом раскатывайте клиентов; ужесточайте в обратном порядке.
Ошибка 4 — считать UNAVAILABLE разрешением на retry. Статус описывает результат попытки, но не доказывает, что application handler не начал работу. Для генерации, записи истории, биллинга и tool call нужен request ID и серверная дедупликация. После первого response token автоматический повтор особенно опасен: клиент может получить два расходящихся ответа.
Ошибка 5 — покупать capacity до локализации owner. Дополнительный gateway действительно полезен для canary и изоляции, но не исправляет неправильный client pool или policy. Сначала докажите дефицит control plane: невозможность управлять версией proxy, drain hook, kernel path или change window. Только после этого инфраструктурное расширение становится инженерным решением, а не дорогим способом отложить диагностику.
Runbook инцидента: от симптома до безопасного rollback
Шаг 1. Зафиксируйте symptom window, затронутые client versions и тип RPC. Не объединяйте unary и streaming ошибки в один график. Шаг 2. Получите GOAWAY code, debug data и Last-Stream-ID на каждом видимом hop. Если frame не записан, отметьте connection close как отдельную неопределённую категорию.
Шаг 3. Постройте карту connection owners и сопоставьте событие с rollout, drain, max age, idle timeout и server keepalive enforcement. Шаг 4. Проверьте application commitment: пришли ли headers или токены, могла ли операция изменить состояние, есть ли idempotency key. До этого не расширяйте retry.
Шаг 5. Выберите одно изменение и один canary. Для too_many_pings согласуйте client/server policy; для NO_ERROR во время rollout сопоставьте grace с stream duration; для protocol error снимите точные версии и минимальный воспроизводимый path. Шаг 6. Сравните transport и application metrics. Шаг 7. Верните canary к baseline тем же способом и подтвердите обратимость.
Типичная ловушка — увидеть меньше UNAVAILABLE после увеличения retry и закрыть инцидент. Если attempts и GPU-seconds выросли, вы лишь перенесли стоимость внутрь системы. Исправление считается доказанным, когда уменьшается исходный transport failure, сохраняется deadline/SLO и не растёт duplicate work.
Вывод: лечите конкретный connection lifecycle
GOAWAY — не диагноз, а указатель на смену состояния HTTP/2 connection. Надёжный разбор связывает frame и его отправителя, фактическую policy на каждом hop и результат конкретного LLM RPC. Keepalive нужен для обнаружения мёртвого transport, drain — для управляемого завершения, deadline — для ограничения работы, а retry допустим только там, где понятна commitment и idempotency boundary.
Начните с одного безопасного действия: выберите недавний инцидент, восстановите карту CLIENT → EDGE → GATEWAY → GPU и подпишите owner каждого connection. Затем повторите событие на canary с прежней policy и с одним изменением. Если для такого теста нужна отдельная управляемая площадка, используйте изолированный VPS или dedicated gateway-пул как воспроизводимый baseline, а не как обещание автоматического ускорения.