Оглавление
- Симптом: кластер здоров, а длинные ответы рвутся
- Обычный ECMP и resilient buckets: в чём разница
- Проверьте prerequisites и границы topology
- Снимите baseline: route, bucket, wire и application outcome
- Создайте resilient group без скрытой смены владельца
- Настройте idle_timer и unbalanced_timer осознанно
- Проведите A/B/A canary с реальным отказом пути
- Не перепутайте красивый bucket dump с успехом
- Типичные ошибки и disqualifiers
- VPS, dedicated gateway или managed fabric: что выбирать
- Production-чеклист rollout и rollback
- Вывод: сохраняйте flows, но доказывайте результат
Один uplink уходит на обслуживание, кластер остаётся зелёным, а часть длинных LLM-ответов внезапно рвётся. Обычный ECMP может переназначить больше потоков, чем действительно затронуто отказом, и это превращает аккуратный route change в трудноуловимый application-инцидент. Linux resilient nexthop groups уменьшают такой flow churn с помощью bucket-таблицы, но требуют точной настройки timers и честного failure drill. Ниже — production-runbook: от доказательства effective path до A/B/A rollback без обещаний «магической отказоустойчивости».
Готовы перейти на современную серверную инфраструктуру?
В King Servers мы предлагаем серверы как на AMD EPYC, так и на Intel Xeon, с гибкими конфигурациями под любые задачи — от виртуализации и веб-хостинга до S3-хранилищ и кластеров хранения данных.
- S3-совместимое хранилище для резервных копий
- Панель управления, API, масштабируемость
- Поддержку 24/7 и помощь в выборе конфигурации
Результат регистрации
...
Создайте аккаунт
Быстрая регистрация для доступа к инфраструктуре
Симптом: кластер здоров, а длинные ответы рвутся
Сбой ECMP редко выглядит как «маршрут пропал». Чаще оба uplink подняты, BGP-сессии установлены, GPU-ноды отвечают, а часть длинных LLM-потоков внезапно получает reset, дублированные паузы или скачок time to first token. Особенно неприятен false green: синтетическая проверка с новым коротким соединением проходит, тогда как уже открытый stream после изменения next hop приходит по пути с другой задержкой или stateful-границей.
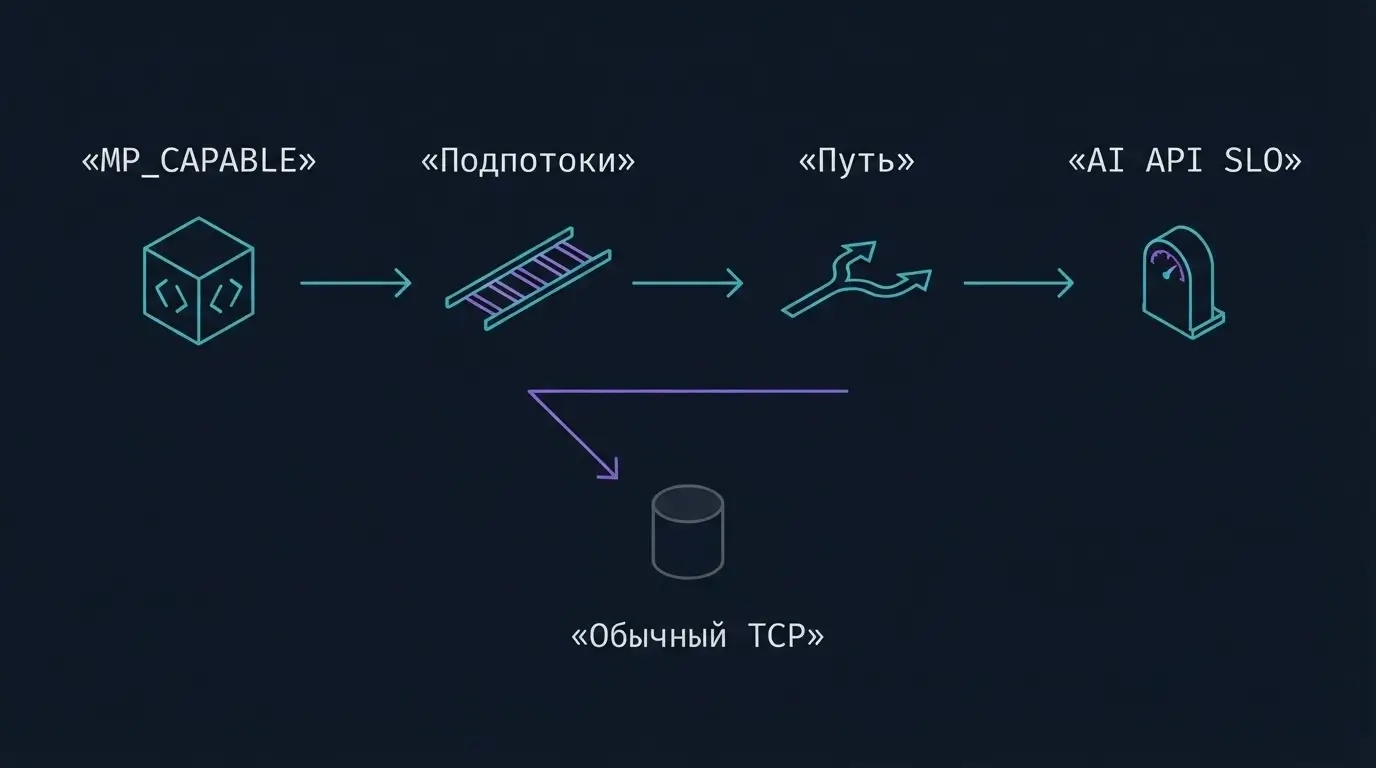
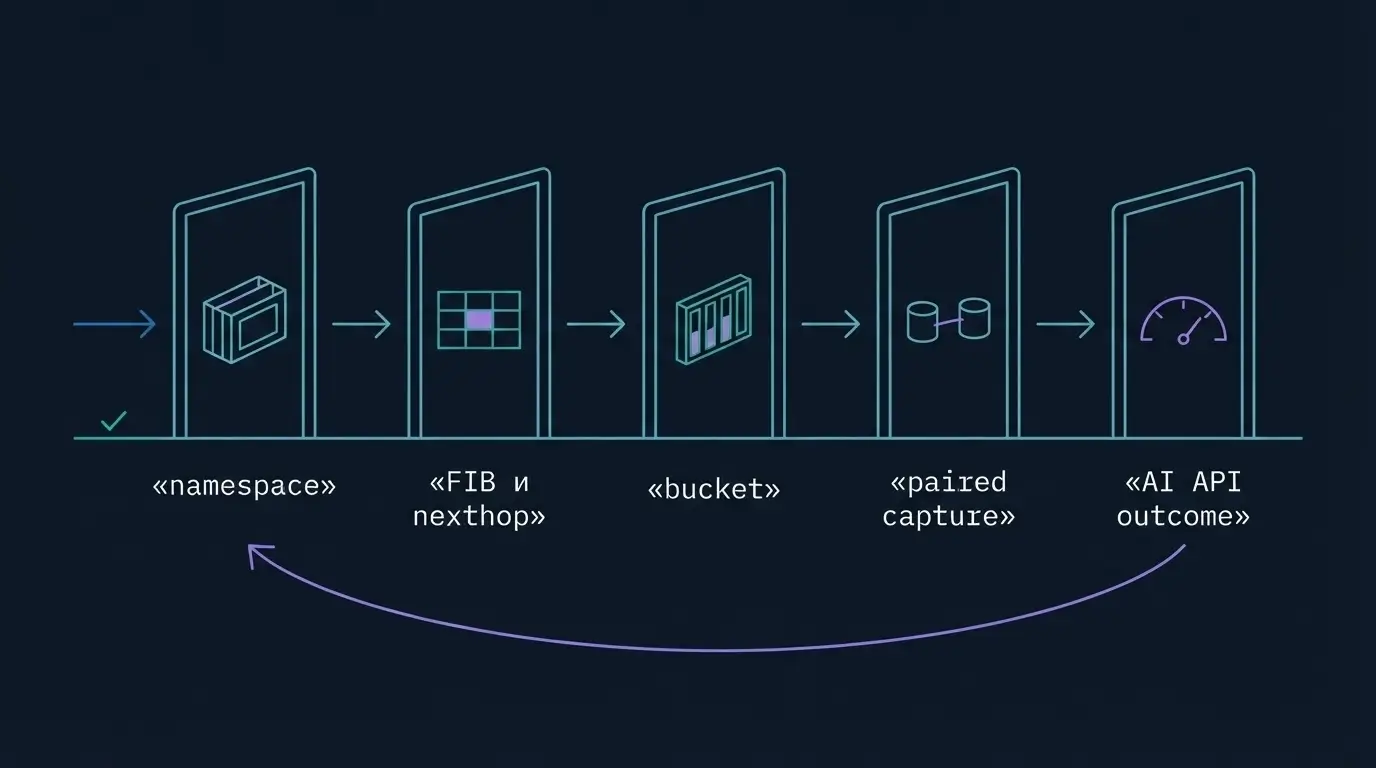
Первое правило расследования: не называйте виновником ECMP только потому, что инцидент совпал с route change. Тот же симптом дают proxy buffering, client read rate, HTTP/2 flow control, conntrack, TLS churn и очередь backend. Нужна цепочка доказательств: effective namespace → FIB и nexthop group → bucket конкретного flow → paired capture → результат AI API. Если цепочка обрывается, изменение маршрутизации остаётся гипотезой.
Практический пример: SRE выводит один leaf на обслуживание. Общий error rate почти не меняется, но клиенты с длинными streaming-ответами жалуются на повторное подключение. Это не повод срочно покупать более быстрый сервер. Сначала сравните long-lived и fresh connections, сохраните tuple, проверьте реальный egress и только затем решайте, связан ли ущерб с массовым remapping потоков.
Resilient nexthop group полезна именно там, где обычная перестройка hash space создаёт лишний churn. Она не обеспечивает HA сама по себе: детектор отказа, удаление неисправного next hop, симметричный обратный путь и корректное поведение приложения всё равно имеют собственных владельцев.
Обычный ECMP и resilient buckets: в чём разница
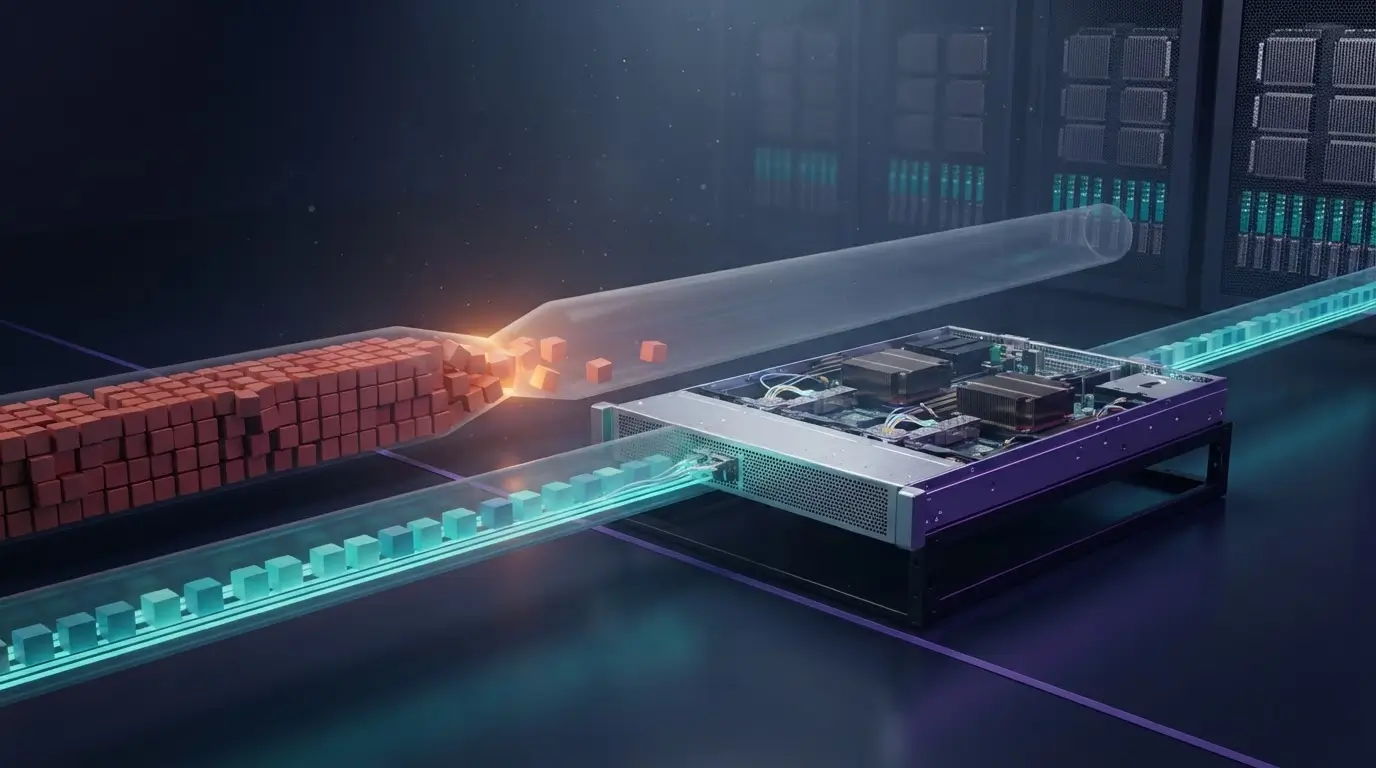
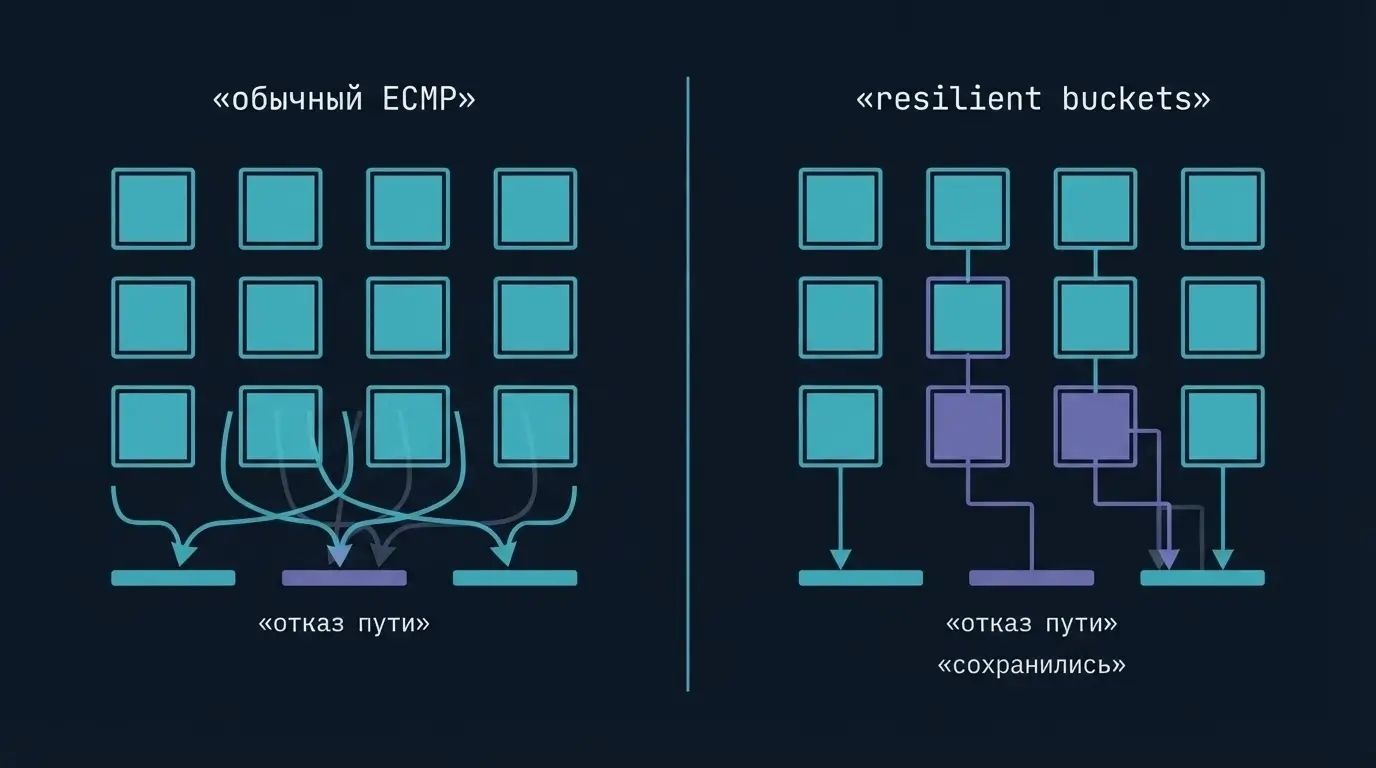
Классическая multipath-группа Linux использует hash-threshold: каждому next hop принадлежит непрерывный диапазон хэшей. Когда состав группы меняется, диапазоны пересчитываются. Из-за этого новый путь может получить не только потоки отказавшего участника, но и часть потоков, которые до события шли через исправные участники. Для stateless UDP это иногда незаметно; для TCP, QUIC, NAT или stateful middlebox внезапная смена пути способна вызвать reordering, потерю состояния и reset.
Resilient group добавляет таблицу buckets между hash space и next hop. Хэш flow выбирает bucket, а bucket уже указывает на next hop. При удалении участника нужно переназначить его buckets; соответствия исправных участников можно оставить. Это не магическая «липкость навсегда», а контролируемое уменьшение blast radius. Официальная документация ядра Linux отдельно описывает busy и idle buckets, wants count и принудительное выравнивание.
В контексте AI API выигрыш проще формулировать через риск: меньше посторонних long-lived flows меняют путь во время изменения topology или weight. Проверяли ли вы, сколько соединений переключилось, хотя их next hop не отказал? Без ответа невозможно доказать, что resilient hashing улучшил ситуацию.
Проверьте prerequisites и границы topology
Начните с версии kernel и iproute2, доступности nexthop API и поддержки вашей control-plane системой. Команда `ip nexthop help` должна показывать тип resilient и параметры buckets, idle_timer, unbalanced_timer. Если группу программирует FRR, учитывайте его собственную матрицу: документация FRR указывает Linux 5.19+ для resilient nexthop groups. Возможность ядра и возможность конкретного routing daemon — разные проверки.
Затем нарисуйте topology до уровня failure domain. Два next hop через один виртуальный switch, одну NIC-функцию или один top-of-rack не дают независимости. Resilient hashing уменьшит remapping, но не создаст второй путь из общей точки отказа. Аналогично два адреса одного stateful firewall могут вести в общий connection table. Кто удаляет failed next hop: BFD, routing daemon, orchestration или оператор? Как быстро этот владелец реагирует? Где хранится state?
На Linux-шлюзе проверьте VRF, network namespace, policy rules и таблицу, которая реально обслуживает поток. Команда в root namespace может показывать идеальную группу, пока traffic проходит в контейнерном namespace или по другой RPDB rule. Эта ошибка особенно типична у API gateway в Kubernetes и service mesh.
uname -r
ip -Version
ip netns list
ip rule show
ip route show table all
ip nexthop help
ip nexthop show groups
Снимите baseline: route, bucket, wire и application outcome
Baseline должен отвечать не на вопрос «сеть работает?», а на вопрос «какой конкретно flow каким путём идёт и что видит клиент». Зафиксируйте source/destination IP и ports, protocol, namespace, VRF, fwmark и route lookup. Для локально инициированного трафика полезен `ip route get` с source address и mark; для forward path этого недостаточно, поэтому добавьте capture на ingress и обоих egress.
Снимите `ip nexthop show` и `ip nexthop bucket show id GROUP_ID` до изменения. Bucket dump показывает mapping и idle time, но не заменяет packet evidence. Один и тот же bucket может быть корректно привязан к next hop, а соседний firewall всё равно терять state. Сопоставляйте kernel state с пакетами по tuple и времени.
Application baseline включает fresh и long-lived сценарии. Для LLM gateway измеряйте handshake outcome, TTFT, межтокенные паузы, завершение stream, reset и retry. Держите healthy negative control через путь, которого изменение не касается. Если после route event деградируют оба контроля, причина, вероятно, шире ECMP.
Сохраните также CPU softirq, NIC drops и retransmission delta. Абсолютный счётчик со старого инцидента ничего не доказывает. Если обнаружен RX pressure, используйте отдельный runbook по NIC ring buffers; если растёт tail retransmission, сопоставьте вывод с диагностикой RACK/TLP.
Для воспроизводимости сохраните тестовые tuples и не полагайтесь на один `curl`. Один новый connection может всегда попадать в тот же bucket и создавать иллюзию равномерности. Генерируйте набор соединений с разными source ports, но не превращайте это в нагрузочный тест без лимитов. Цель — увидеть mapping и судьбу потоков, а не доказать максимальную пропускную способность. Отдельно отметьте соединения, существовавшие до изменения: именно они показывают цену remapping.
В распределённой схеме часы и идентификаторы важнее объёма логов. Запишите monotonic timestamp route event, request ID, client tuple и выбранный next hop. Логи gateway без tuple трудно сопоставить с capture, а capture без application outcome показывает лишь движение пакетов. Хороший evidence bundle позволяет другому инженеру повторить вывод без устного контекста автора теста.
ip route get 203.0.113.80 from 198.51.100.10
ip nexthop show
ip nexthop bucket show id 100
ss -tin '( dport = :443 )'
tcpdump -ni uplink0 host 203.0.113.80 -w uplink0-before.pcap
tcpdump -ni uplink1 host 203.0.113.80 -w uplink1-before.pcap
Создайте resilient group без скрытой смены владельца
Конфигурацию лучше собирать из независимых nexthop objects и отдельной group ID. Сначала создаются участники, затем resilient group, после чего route ссылается на её `nhid`. Так route prefix и жизненный цикл next hop не смешиваются в одной длинной команде. Пример ниже использует адреса из документационных диапазонов; замените интерфейсы и gateways на собственные.
Число buckets задаётся при создании и, согласно `ip-nexthop(8)`, не меняется у существующей группы. Поэтому не копируйте число из чужой схемы. Слишком маленькая таблица грубо выражает weights; слишком большая увеличивает state и объём наблюдения. Выберите размер по числу участников, требуемой гранулярности weights и возможностям hardware offload, затем проверьте распределение реальными flow tuples.
Команда `replace` удобна для изменения состава или weights, но это change event. Не запускайте её одновременно с обновлением BGP policy, firewall и proxy: иначе невозможно установить причинность. Перед изменением сохраните точный обратный набор команд и убедитесь, что ID не конфликтуют с routing daemon.
ip nexthop add id 11 via 192.0.2.1 dev uplink0
ip nexthop add id 12 via 198.51.100.1 dev uplink1
ip nexthop add id 100 group 11/12 type resilient \
  buckets 128 idle_timer 120 unbalanced_timer 0
ip route replace 203.0.113.0/24 nhid 100

ip nexthop show id 100
ip nexthop bucket show id 100Настройте idle_timer и unbalanced_timer осознанно
`idle_timer` определяет, сколько времени bucket должен не получать traffic, чтобы считаться idle. В man page default — 120 секунд. Это не «правильное значение для LLM», а исходная семантика. У длинных streams bucket может оставаться busy дольше обычного HTTP-запроса, поэтому агрессивное уменьшение timer рискует признать активность завершённой слишком рано относительно приложения или offload telemetry.
`unbalanced_timer` задаёт, сколько группа может оставаться невыравненной до принудительной миграции buckets. Default 0 означает отсутствие такого forced rebalance: таблица может ждать появления idle buckets. Ненулевое значение ограничивает период дисбаланса, но допускает перенос busy bucket, а значит, потенциальный churn. Это классический обмен между равномерностью распределения и стабильностью установленных потоков.
Смотрите на timers через workload. Если AI API держит соединение минуты, а deploy меняет weights каждые несколько минут, постоянное стремление к идеальному балансу может быть вреднее временного skew. Если же next hop возвращён с большей capacity и новые соединения продолжают обходить его, слишком осторожная политика может продлить перегрузку. Правильный вопрос: какой ущерб дороже — временный дисбаланс или перемещение активного flow?
Меняйте один owner за раз. Сначала weights или состав, затем timers в отдельном canary. Иначе bucket migration, route convergence и application retries смешаются в одну картину.
Проведите A/B/A canary с реальным отказом пути
Canary должен повторять тот класс события, ради которого внедряется resilient group. Простое добавление route не проверяет удаление next hop. Выберите небольшой контролируемый сегмент, создайте long-lived streams и fresh requests, затем инициируйте отказ через тот механизм, которым владеет production: withdraw в routing daemon, выключение тестового интерфейса или административное удаление участника. Не выдёргивайте кабель в общей фабрике без change window.
Фаза A фиксирует обычную multipath-группу или текущую конфигурацию. Фаза B включает resilient group при тех же traffic profile и probes. Фаза A после rollback подтверждает обратимость. На каждой фазе сохраните bucket mapping, paired capture и application outcome. Нельзя сравнивать утреннюю низкую нагрузку с вечерним пиком и приписывать разницу хэшированию.
Stop condition должна быть машинно понятной: рост reset, stream failures, reordering или error rate относительно контрольного пути; исчезновение next hop без восстановления application path; неожиданный уход трафика в другой VRF; невозможность вернуть исходный route. Не используйте выдуманный универсальный процент — порог берётся из SLO конкретного сервиса.
После положительного canary проверьте не только surviving connections, но и новые. Resilient mapping может сохранить старые flows и одновременно оставить новый next hop underweight. В этом случае нужно решить, приемлем ли временный дисбаланс или требуется аккуратная настройка timers.
Обязательно проверьте degraded capacity. После удаления одного из двух равных next hop оставшийся путь получает больше новых flows; стабильный mapping не спасёт его от saturation. Сравните drops, queueing и application latency до и после события. Если surviving path не выдерживает расчётную нагрузку, resilient hashing лишь делает отказ аккуратнее, но не делает систему работоспособной.
Затем верните участника и наблюдайте обратный процесс. Возврат next hop часто сложнее удаления: хочется немедленно восстановить равный weight, однако busy buckets могут не мигрировать, а forced rebalance снова затронет активные streams. Начните с controlled weight, дождитесь доказательств на новых flows и только потом расширяйте долю. Это обычный rollout, а не «снятие аварии одной командой».
ip monitor nexthop route link
ip nexthop bucket show id 100 > buckets-before.txt

# Выполните change через production-владельца.
ip nexthop replace id 100 group 11 type resilient \
  buckets 128 idle_timer 120 unbalanced_timer 0

ip nexthop bucket show id 100 > buckets-after.txt
ss -tin '( dport = :443 )'
Не перепутайте красивый bucket dump с успехом
Kernel view отвечает, куда должен идти packet, но production outcome рождается на всём пути. Bucket мог остаться на прежнем next hop, тогда как underlay ECMP внутри фабрики выбрал другой leaf. Hardware offload мог принять group, но не обновить отдельный bucket. Stateful firewall мог увидеть обратный traffic через другой узел. Поэтому нужны три независимых слоя: kernel objects, wire evidence и application metrics.
В `ip nexthop bucket show` сравнивайте nhid, idle time и фактические миграции. В `ip monitor nexthop` сохраняйте момент изменения. На wire смотрите sequence, retransmission, out-of-order, ICMP и реальный интерфейс. На application уровне связывайте события с request ID без публикации пользовательских данных. Один общий график p95 не покажет, что страдают только long-lived connections на одном next hop.
Учтите compatibility mode. Kernel sysctl documentation предупреждает: при включённом `nexthop_compat_mode` legacy route dumps могут неполно или неверно отражать modern features, включая resilient type. Это не повод глобально менять sysctl во время инцидента. Используйте native nexthop commands и убедитесь, что ваш collector понимает netlink objects.
Если проблема проявляется как queueing без route change, проверьте bufferbloat и fq_codel. Resilient hashing не лечит перегруженный egress; оно только ограничивает ненужное перераспределение flow mapping.
Для offloaded group ищите признаки `offload`, `trap` и `offload_failed` там, где их предоставляет driver. ACK от netlink означает, что объект принят kernel, но не всегда доказывает программирование ASIC. Если driver или switch не поддерживает требуемую семантику, зафиксируйте software path как отдельный вариант с собственным CPU budget; не выдавайте его за эквивалент hardware forwarding.
Alerting стройте на расхождении слоёв. Например: kernel удалил next hop, но packets продолжают появляться на его egress; bucket migration завершилась, но reset rate растёт; control plane вернул участника, а fresh flows его не выбирают. Такие алерты диагностичнее общего «ECMP unhealthy», потому что сразу указывают владельца следующей проверки.
Типичные ошибки и disqualifiers
Первая ошибка — считать любой dual uplink независимым. Если оба пути входят в один switch, один provider edge или общий firewall cluster без независимого state, отказ остаётся общим. Вторая — лечить skew увеличением buckets до проверки hash inputs. Низкая энтропия source ports, NAT перед gateway или несколько длинных elephant flows могут давать перекос при любой разумной таблице.
Третья ошибка — включать `fib_multipath_use_neigh` и ожидать полноценного failure detection. Neighbor state — один сигнал; он не доказывает доступность дальнего path или приложения. Владельцем удаления next hop может оставаться routing daemon с BFD либо orchestration. Четвёртая — принудительно выравнивать busy buckets, а затем удивляться reset. Ненулевой unbalanced timer является осознанным разрешением на такой риск.
Есть и прямые disqualifiers. Если capture показывает один route без multipath, resilient group ничего не изменит. Если reset генерирует proxy, занимайтесь drain и keepalive. Если client читает медленно, исправляйте backpressure. Если latency появляется после попадания запроса в inference queue, сетевой hash не ускорит GPU. Если reverse path асимметричен и stateful middlebox отбрасывает ответы, сначала исправьте policy routing; полезен отдельный runbook по ip rule, rp_filter и fwmark.
Наконец, не путайте минимизацию disruption с zero disruption. Buckets отказавшего next hop обязаны переехать. Вопрос не в том, будет ли изменение, а в том, ограничено ли оно необходимым набором flow и переживает ли его приложение.
VPS, dedicated gateway или managed fabric: что выбирать
Платформу имеет смысл менять только после доказанного control gap. На VPS оператор часто управляет Linux FIB и nexthop objects, но не видит hardware offload, physical uplink и underlay. Этого достаточно для небольшого software gateway, если provider гарантирует предсказуемую сеть и rollback. Но тест «два интерфейса видны в VM» ещё не доказывает независимые failure domains.
Dedicated gateway даёт больше контроля над NIC queues, drivers, IRQ locality, hardware counters и change window. Это важно, когда evidence показывает, что bottleneck или ambiguity находится между kernel и физическим портом. Цена — собственный lifecycle: firmware, routing daemon, spare capacity, мониторинг и on-call. Покупать dedicated только ради модного слова ECMP бессмысленно.
Managed fabric полезна, когда команда не хочет владеть BGP/BFD, switch telemetry и hardware offload. Тогда договор должен описывать не «низкую latency», а наблюдаемость, failure domains, процедуру изменения weights, время реакции, экспорт событий и rollback. Спросите provider, можно ли доказать, какие flows были remapped во время failure drill.
Для King Servers-ориентированного решения практичный default таков: сохраняйте текущую платформу, пока canary не доказал нехватку контроля. После доказательства сравнивайте варианты по доступу к kernel/NIC telemetry, независимости путей и возможности повторить A/B/A. Инфраструктура продаёт воспроизводимый baseline и управляемое окно изменений, а не автоматическое исчезновение tail latency.
Закрепите ownership в change record: кто управляет route objects, кто подтверждает физическую независимость, кто видит hardware counters и кто принимает решение о rollback. Без этой карты даже дорогая платформа оставляет слепые зоны. С ней небольшой gateway может быть надёжнее сложной фабрики, которую никто не умеет проверять в момент сбоя.
Production-чеклист rollout и rollback
Перед rollout сохраните полный inventory: kernel, iproute2, routing daemon, namespace, VRF, nexthop IDs, route prefixes, bucket count, timers и owner каждого change. Проверьте, что automation не перезапишет manual objects при следующем reconcile. Подготовьте отдельный synthetic workload с long-lived и fresh connections, а также healthy и forbidden controls.
Во время rollout меняйте один слой: создайте objects, привяжите canary prefix или traffic slice, наблюдайте bucket mapping, wire и application outcome. Не меняйте одновременно firewall policy, proxy version и NIC offload. Сохраняйте timestamps в одном часовом источнике, иначе route event и reset невозможно связать.
Rollback должен быть симметричным. Верните исходный route/group, восстановите участника, повторите те же probes и убедитесь, что старый failure mode не остался из-за connection cache или stale neighbor. Удаляйте тестовые nexthop IDs только после отвязки routes. Если rollback улучшил application outcome, это сильнее красивого графика распределения.
Готовность к production означает: нет лишнего remapping исправных flows; отказавший path удаляется владельцем; surviving path имеет capacity; reverse path и stateful boundaries согласованы; observability видит kernel, wire и приложение; оператор умеет вернуть исходную схему. Любой пропуск — причина оставить изменение в canary.
Перед расширением canary проведите независимый review. Инженер, который не собирал группу, должен по сохранённым командам определить effective path, объяснить роль каждого timer и выполнить rollback. Если для этого нужен автор схемы, runbook ещё не готов. Заодно проверьте persistence после reboot и reconcile: ручной объект, исчезающий после перезапуска network manager, создаёт отложенный инцидент.
После rollout не удаляйте baseline. Он становится контрольным пакетом для следующего kernel, iproute2, FRR или firmware upgrade. Повторите тот же failure drill после изменения версии; совместимый CLI не гарантирует прежнюю offload-семантику или timing control plane.
Вывод: сохраняйте flows, но доказывайте результат
Linux resilient nexthop groups уменьшают ненужный ECMP churn: bucket-indirection позволяет при изменении состава сохранить mapping исправных потоков и перенести то, что действительно затронуто. Для длинных AI API streams это полезный инструмент, но не готовая отказоустойчивость.
Начните с evidence chain, проверьте topology и владельцев, создайте группу через native nexthop API, настройте timers под жизненный цикл соединений и проведите A/B/A failure drill. Решение принимайте по reset, reordering, TTFT и завершению stream, а не по одной таблице buckets.
Следующий шаг простой: соберите baseline на одном gateway и воспроизведите управляемый отказ в canary. Если выяснится, что вам не хватает контроля kernel, NIC или failure domain, выбирайте инфраструктуру уже с этим доказательством — так разговор о VPS, dedicated gateway или managed fabric становится инженерным, а не рекламным.