Оглавление
- Когда TLS становится скрытой очередью перед GPU
- Сначала снимите baseline, который переживёт спор команд
- Три gate: TLS mechanism, transport reuse и LLM outcome
- Session resumption: cache, tickets и граница балансировщика
- Keepalive важнее магии TLS, если соединения можно не закрывать
- Минимальная конфигурация и почему её нельзя копировать вслепую
- Метрики, которые отделяют handshake storm от соседних аварий
- Canary rollout: меняйте один механизм и оставляйте путь назад
- Когда нужен отдельный gateway, VPS или dedicated edge
- Runbook инцидента: от алерта до доказанного восстановления
- Главный вывод: сначала соединение, затем криптография, потом железо
Готовы перейти на современную серверную инфраструктуру?
В King Servers мы предлагаем серверы как на AMD EPYC, так и на Intel Xeon, с гибкими конфигурациями под любые задачи — от виртуализации и веб-хостинга до S3-хранилищ и кластеров хранения данных.
- S3-совместимое хранилище для резервных копий
- Панель управления, API, масштабируемость
- Поддержку 24/7 и помощь в выборе конфигурации
Результат регистрации
...
Создайте аккаунт
Быстрая регистрация для доступа к инфраструктуре
Когда TLS становится скрытой очередью перед GPU
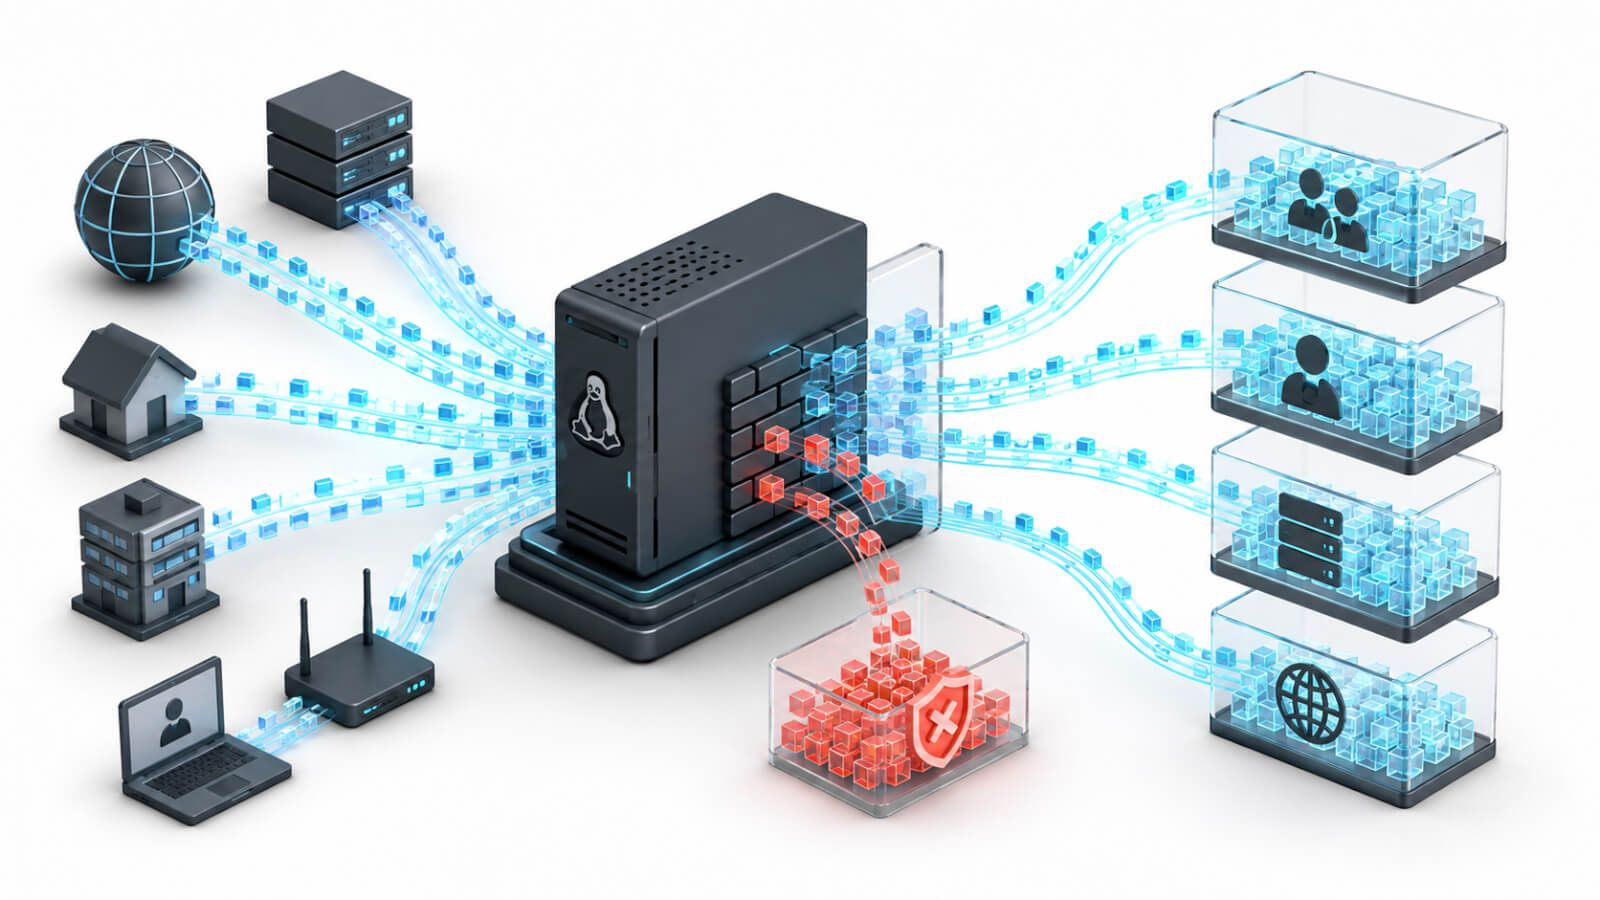
График GPU utilization просел, TTFT вырос, а число запросов почти не изменилось. На gateway одновременно подскочили CPU и новые TCP-соединения. Это типичная картина, когда дорогим ресурсом внезапно становится не inference, а создание защищённых соединений: клиенты перестали переиспользовать transport, session resumption не срабатывает или балансировщик обнуляет его эффект.
Важно сразу провести границу с соседними проблемами. Если поток уже установлен, но токены идут рывками, полезнее начать с очереди BBR/fq или существующего материала про reverse proxy. Здесь другой intent: найти, почему gateway выполняет слишком много полных TLS handshakes, и доказать связь именно с application SLO.
Один handshake сам по себе не авария. Авария начинается, когда отношение новых соединений к полезным LLM-запросам резко меняется, CPU gateway уходит в насыщение, а TTFT ухудшается при стабильном времени генерации на backend. Проверяли ли вы эти три ряда на одной шкале времени? Без такой корреляции легко «лечить» сертификаты, хотя виноват client pool.
Материал рассчитан на NGINX-подобный TLS terminator, но метод переносится на Envoy, HAProxy и managed load balancer. Команды и директивы сверяйте с вашей версией: например, текущая документация NGINX отдельно описывает shared session cache, tickets и keepalive, а поведение upstream keepalive менялось между ветками.
Сначала снимите baseline, который переживёт спор команд
До изменения конфигурации соберите evidence bundle: точную версию gateway и TLS-библиотеки, effective config, topology termination points, частоту новых соединений, долю reused sessions, CPU по worker-процессам, ошибки handshake и application-метрики. Владелец шага — команда edge/platform; stop condition — вы не знаете, где именно завершается клиентский TLS.
Не ограничивайтесь средней загрузкой узла. Handshake storm часто выглядит как короткие пики по отдельным worker, которые растворяются в минутном average. Сопоставьте rate новых соединений с completed requests, а не только с RPS: один streaming-запрос может жить долго, тогда как неудачный клиент создаёт десятки соединений и почти не даёт полезной работы.
Хороший baseline включает спокойное окно и окно инцидента одинаковой длины. Зафиксируйте p50/p95 TTFT, CPU gateway, accepted connections, TLS handshakes, resumption hits, 4xx/5xx и время inference без сетевой части. Не придумывайте универсальные пороги: сравнивайте сервис с его собственным стабильным периодом и SLO.
- Identity: hostname, VIP, pod/VM, версия NGINX/OpenSSL.
- Transport: новые TCP-соединения, keepalive reuse, resets и timeouts.
- TLS: полные и resumed handshakes, протокол, certificate path.
- Application: TTFT, queue time backend, tokens/sec и error budget.
nginx -V 2>&1
nginx -T > /var/tmp/nginx-effective.conf 2>&1
ss -s
ss -Htan state established '( sport = :443 )' | wc -l
pidstat -p "$(pgrep -d, -x nginx)" 1 10
Три gate: TLS mechanism, transport reuse и LLM outcome
Разделите расследование на три независимых доказательства. TLS mechanism gate отвечает, умеет ли клиент возобновить сессию на том же termination point. Transport gate показывает, переиспользуются ли клиентские и upstream-соединения. Application gate проверяет, изменились ли TTFT и error budget. PASS в первом gate не гарантирует PASS в третьем.
Для TLS gate выполните повторные соединения одним и тем же тестовым клиентом и смотрите, сообщает ли инструмент о reuse. Для transport gate сравните число connect/accept с completed requests и длительностью соединений. Для application gate проведите одинаковый canary workload с фиксированными моделью, prompt и лимитом output tokens.
Отрицательный контроль обязателен. Запустите тот же canary с отключённым client pooling или через другой termination point, где cache/ticket заведомо не разделяется. Если метрика не расходится, вы не доказали механизм. Важно не направлять этот контроль на production-пользователей: достаточно малой изолированной выборки.
openssl s_client \
  -connect api.example.com:443 \
  -servername api.example.com \
  -tls1_3 \
  -reconnect &1 | \
  grep -E 'New,|Reused,|Protocol|Cipher|Verify return code'
Session resumption: cache, tickets и граница балансировщика
NGINX прямо указывает два способа сократить дорогие операции: keepalive и повторное использование параметров TLS-сессии. Shared cache доступен worker-процессам и настраивается через ssl_session_cache; время повторного использования задаёт ssl_session_timeout. В актуальной документации ngx_http_ssl_module также описаны session tickets и ротация ticket keys.
Ловушка появляется на нескольких gateway-репликах. Stateful cache на одном экземпляре не поможет клиенту, который при каждом reconnect попадает на другую реплику. Tickets могут пережить балансировку только при согласованной политике ключей; слишком долгая жизнь ключа расширяет окно риска, слишком быстрая несогласованная ротация обрушает reuse. Владельцу security нужно участвовать в решении, а не получать готовую настройку постфактум.
Для TLS 1.3 resumption основан на PSK и NewSessionTicket; это не повод включать 0-RTT автоматически. Early data имеет отдельные replay-риски и не требуется, чтобы получить пользу от обычного resumption. Сверяйтесь с RFC 8446 и политикой вашего клиента.
Проверяйте effective context. NGINX предупреждает, что параметры сессий могут зависеть от default server при выборе виртуального сервера. Мини-кейс: команда правит cache в одном SNI server block, а реальные сессии обслуживаются настройкой default server. Конфиг выглядит правильно, но resumption miss не меняется.
Keepalive важнее магии TLS, если соединения можно не закрывать
Session resumption делает новый handshake дешевле, но keepalive вообще убирает необходимость в новом соединении. Поэтому сначала спросите: почему соединение закрывается? Причиной могут быть client connection pool, max requests, idle timeout на LB, graceful reload, proxy policy, upstream close или ограничение SDK. Настраивать cache, не ответив на этот вопрос, — оптимизация второго порядка.
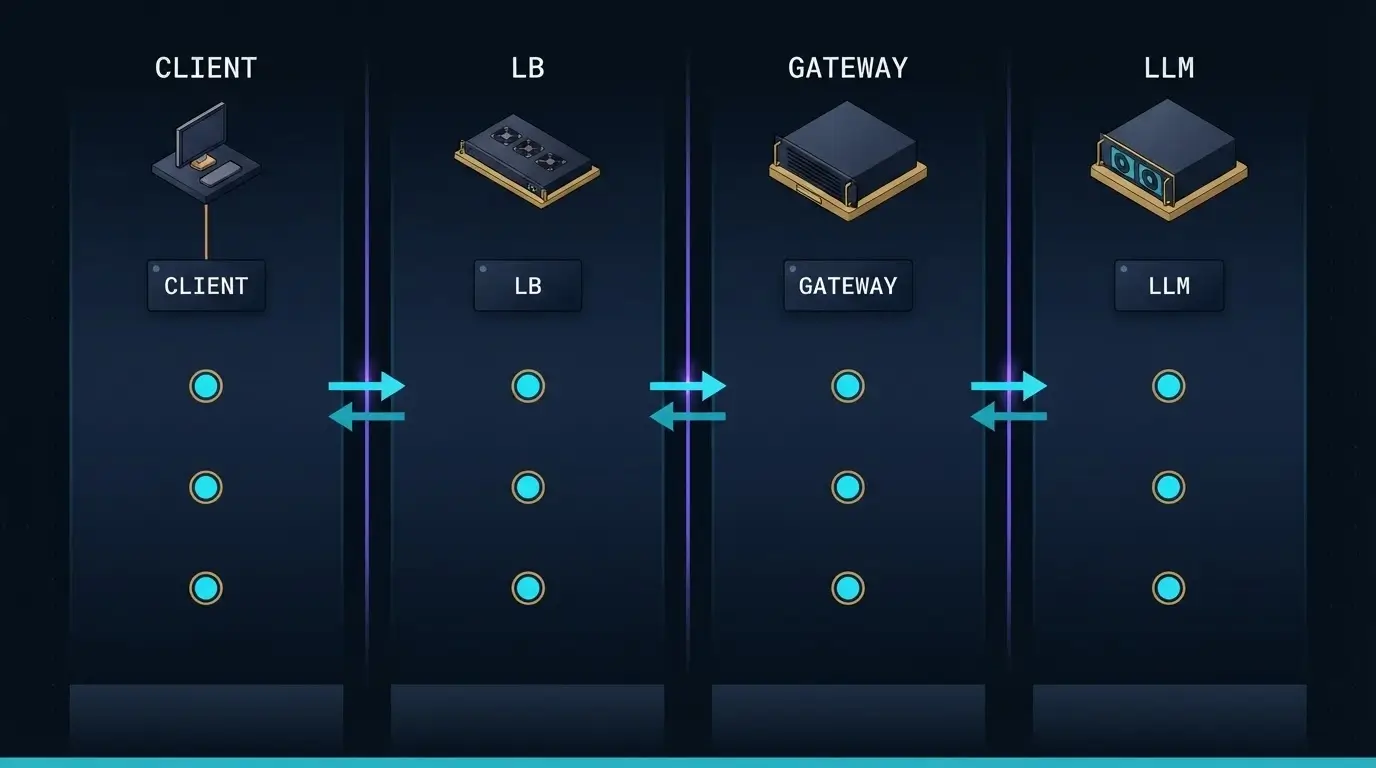
Разделяйте два плеча: client → gateway и gateway → LLM backend. Клиентский HTTP/2 может мультиплексировать запросы в одном соединении, а gateway при этом создавать новый upstream TCP/TLS на каждый вызов. И наоборот, upstream pool может быть здоров, но mobile-клиент или serverless worker постоянно пересоздаёт внешний transport.
В документации NGINX upstream подчёркнуто, что размер keepalive cache — это число idle connections на worker, а не лимит всех соединений. Слепо поставить огромное значение опасно: backend всё равно должен принимать новые соединения, а память и file descriptors конечны.
Негативный контроль здесь прост: небольшой canary без pooling должен показывать больше connect events на тот же объём полезных запросов. Если разницы нет, ищите termination между клиентом и gateway, принудительное закрытие или неверную телеметрию. Знакомо, когда команда считает HTTP requests, а настоящий TLS заканчивается на внешнем LB, чьи метрики никто не открыл?
Минимальная конфигурация и почему её нельзя копировать вслепую
Ниже — baseline, а не универсальный рецепт. Он включает shared session cache и keepalive, но размеры и время жизни нужно выбирать по реальному числу активных клиентов, памяти, security-политике и topology. Перед применением проверьте синтаксис вашей ветки NGINX: defaults и доступные директивы менялись.
Не добавляйте 0-RTT только ради красивого latency-графика. Для LLM API запрос может менять состояние, списывать квоту или создавать дорогостоящую генерацию; replay такого запроса требует отдельной модели идемпотентности. Обычный TLS 1.3 resumption и keepalive дают пользу без автоматического принятия early data.
После reload подтвердите именно effective state: nginx -T, новые worker PID, отсутствие ошибок загрузки ключей и поведение canary. Успешная команда reload доказывает лишь то, что master принял сигнал. Она не доказывает reuse, снижение CPU или улучшение TTFT.
worker_processes auto;

http {
    ssl_session_cache shared:TLS:20m;
    ssl_session_timeout 10m;
    ssl_session_tickets on;

    keepalive_timeout 75s;
    keepalive_requests 1000;

    upstream llm_backend {
        server 10.0.0.11:8000;
        server 10.0.0.12:8000;
        keepalive 32;
    }

    server {
        listen 443 ssl;
        server_name api.example.com;

        ssl_certificate     /etc/nginx/tls/fullchain.pem;
        ssl_certificate_key /etc/nginx/tls/privkey.pem;
        ssl_protocols TLSv1.2 TLSv1.3;

        location /v1/ {
            proxy_http_version 1.1;
            proxy_set_header Connection "";
            proxy_pass http://llm_backend;
        }
    }
}
Метрики, которые отделяют handshake storm от соседних аварий
Начните с причинной цепочки, а не с коллекции панелей: new connections → full handshakes → gateway CPU → request admission/queue → TTFT. К ней добавьте resumption reuse, connection lifetime, client cohort и termination replica. Если рост CPU не следует за full handshakes, ищите certificate loading, WAF, logging или другой workload на том же узле.
Сравните с conntrack и SNAT runbook. При исчерпании state table или портов новые соединения тоже ломаются, но signature другая: drops, allocation failures, retransmits и ошибки connect. TLS tuning не расширяет tuple space и не исправляет retry storm.
Отдельно проверьте DNS и peer identity. После failover клиент может держать старое соединение или старый IP; это разобрано в статье про DNS failover для LLM API. Здесь resumption miss будет следствием смены termination point, а не первопричиной инцидента.
- Qualifier: full handshake rate растёт быстрее полезных запросов, reuse падает, CPU gateway коррелирует.
- Disqualifier: CPU стабилен, но backend queue растёт; проблема вероятнее в inference capacity.
- Disqualifier: connect failures идут вместе с conntrack/SNAT pressure.
- Disqualifier: только один SDK churn-ит соединения; исправление принадлежит клиенту.
Canary rollout: меняйте один механизм и оставляйте путь назад
Canary должен отличаться одной гипотезой. Если одновременно увеличить session cache, поменять tickets, keepalive, worker count и LB policy, вы получите улучшение без attribution. Начните с самого дешёвого control: восстановите client pooling или устраните слишком короткий idle timeout. Затем отдельно проверяйте resumption.
Закрепите canary за отдельной gateway-репликой или hostname, но сохраните одинаковые certificate chain, модель, prompt distribution и backend pool. Сравнивайте не абсолютный latency двух разных потоков, а нормализованные показатели на полезный запрос: CPU/request, new connections/request, full handshakes/request и TTFT при сопоставимом output.
Stop condition задаётся заранее: рост handshake errors, 4xx/5xx, reset rate, ухудшение TTFT или нарушение security-policy. Rollback должен возвращать прежние cache/ticket/keepalive параметры и повторять те же три gate в обратном порядке. Только так возврат к baseline становится контрфактом, а не ритуалом.
Практический случай: после увеличения cache reuse растёт, но TTFT не меняется. Это частичный PASS. Механизм работает, однако bottleneck находится дальше — например, в admission queue backend. Не продавайте это как ускорение LLM; оставьте изменение только если снижение CPU gateway само по себе оправдывает сложность.
Когда нужен отдельный gateway, VPS или dedicated edge
Default простой: не покупайте новый сервер, пока не доказали дефицит ресурса и границу контроля. Если проблема в SDK, который закрывает соединение после каждого запроса, более мощный gateway лишь дороже переварит тот же churn. Если виноваты несогласованные ticket keys в managed LB, перенос без исправления ownership тоже не даст устойчивого результата.
Выделенный gateway оправдан, когда evidence показывает CPU saturation на TLS termination, соседние workloads создают непредсказуемый steal/noisy-neighbor эффект, а команде нужны управляемые версии OpenSSL/NGINX, воспроизводимый hardware profile и собственное change window. Для малого private API иногда достаточно VPS; высокий handshake rate, жёсткий SLO и большой blast radius чаще ведут к dedicated edge-пулу.
Коммерческий bridge к инфраструктуре KingServers здесь не про обещание «ускорить TLS одной кнопкой». Ценность — в контроле: закрепить gateway profile, отделить canary, наблюдать CPU и network path, проводить симметричный rollback. Архитектурный контекст private endpoint, квот и gateway можно связать со статьёй про Private AI API.
Decision helper должен учитывать owner. Client team отвечает за pooling и lifecycle SDK; edge team — за TLS policy, cache и termination; network team — за LB и path; LLM platform — за queue, batching и TTFT decomposition. Пока owner не назван, любой тюнинг рискует стать временной заплаткой.
Runbook инцидента: от алерта до доказанного восстановления
Шаг 1. Подтвердите симптом: TTFT или error rate вышли за SLO, а workload сопоставим с baseline. Шаг 2. Найдите TLS termination point и владельца. Шаг 3. Сохраните effective config, версии, worker CPU и connection counters. Шаг 4. Разделите full handshake, resumed handshake и already-open keepalive.
Шаг 5. Проведите безопасный отрицательный контроль: тестовый клиент без pool либо отдельный termination point без общего resumption state. Шаг 6. Выберите один fix — client pooling, idle timeout, shared cache или согласованная ticket policy. Шаг 7. Прокатите на canary с фиксированным workload и stop condition. Шаг 8. Повторите TLS, transport и application gates.
Шаг 9. Сделайте rollback-контрфакт: верните прежнее значение и проверьте, возвращается ли симптом. Если нет, причинность остаётся недоказанной. Шаг 10. Только после повторяемого результата расширяйте rollout. Обновите runbook реальными метриками вашего сервиса, но не превращайте наблюдавшийся порог в универсальный закон.
Важная производственная деталь: graceful reload сам может временно увеличить число соединений, если старые worker завершаются, а клиенты переподключаются. Не оценивайте canary только в первые секунды после reload; выделите warmup и стабильное измеряемое окно.
Главный вывод: сначала соединение, затем криптография, потом железо
TLS handshake storm — это не синоним «медленного шифрования». Сначала докажите, что сервис создаёт слишком много соединений на полезный запрос; затем проверьте session resumption на реальном termination point; после этого свяжите механизм с CPU gateway и TTFT. Такая последовательность защищает от красивого, но бесполезного тюнинга.
Рабочий change plan короткий: baseline, три evidence gate, один canary-fix, отрицательный контроль и симметричный rollback. Keepalive обычно сильнее оптимизации нового handshake, а новый сервер имеет смысл только после подтверждённого resource bottleneck и понятной границы ownership.
Следующий практический шаг — взять одно стабильное и одно проблемное окно, посчитать new connections/request и повторить OpenSSL probe через каждую gateway-реплику. Если причина подтверждена, перенесите минимальный fix на canary. Если нет — сохраните результат: честный disqualifier экономит больше времени, чем ещё одна директива в конфиге.