Оглавление
- Быстрый вердикт: когда zones действительно нужны
- Как возникает коллизия одинаковых tuple
- Evidence chain до изменения ruleset
- Правильный порядок nftables: zone до lookup
- Canary и A/B/A без потери существующих соединений
- Ёмкость conntrack и наблюдаемость по zone
- Типичные ошибки и точная диагностика
- Zone, network namespace или VRF: что выбрать
- Когда VPS достаточно, а когда нужен dedicated gateway
- Production checklist перед расширением rollout
- Вывод: изолируйте state только после доказательства
Два клиента отправляют запросы к LLM API с одинаковых приватных адресов, SYN доходит до Linux gateway, backend отвечает — но один поток внезапно становится INVALID или получает чужое NAT-состояние. В такой аварии легко обвинить маршрутизацию, firewall или GPU, хотя конфликт живёт в общей таблице conntrack. Zones позволяют развести одинаковые tuple по отдельным доменам состояния, но только если назначить их до lookup и симметрично проверить reply path. Ниже — production-runbook без магических sysctl: evidence chain, минимальный nftables ruleset, A/B/A canary, resource budget и честная граница между исправлением конфигурации и сменой инфраструктуры.
Готовы перейти на современную серверную инфраструктуру?
В King Servers мы предлагаем серверы как на AMD EPYC, так и на Intel Xeon, с гибкими конфигурациями под любые задачи — от виртуализации и веб-хостинга до S3-хранилищ и кластеров хранения данных.
- S3-совместимое хранилище для резервных копий
- Панель управления, API, масштабируемость
- Поддержку 24/7 и помощь в выборе конфигурации
Результат регистрации
...
Создайте аккаунт
Быстрая регистрация для доступа к инфраструктуре
Быстрый вердикт: когда zones действительно нужны
Conntrack zone нужна не каждому шлюзу. Она решает узкую задачу: позволяет ядру хранить одинаковые сетевые tuple в разных логических доменах состояния. Если два клиента приходят через разные интерфейсы, но используют одинаковый адрес 10.0.0.5, одинаковый исходный порт и один и тот же VIP, обычная общая таблица conntrack может перестать различать эти потоки так, как ожидает ваша tenant-модель. Особенно неприятно это проявляется рядом с DNAT/SNAT: SYN виден, backend жив, но reply привязывается не к тому состоянию или пакет получает INVALID.
Практический default прост: не добавляйте zones, пока не доказали коллизию или смешение state на конкретном пути. Сначала зафиксируйте ingress-интерфейс, original/reply tuple, NAT-преобразование и результат свежего запроса к AI API. Если tuple уже уникальны благодаря отдельным network namespaces, VRF, адресам или портам, zone станет ещё одним owner, который придётся документировать и поддерживать. Она не чинит неверный route, MTU, медленного клиента, proxy buffering, retry storm или очередь на GPU.
Для multi-tenant LLM gateway полезен следующий критерий: разные арендаторы разделяют адресное пространство, но сходятся в одном network namespace и используют общий stateful firewall/NAT. Тогда zone — небольшой и проверяемый механизм изоляции. Общую архитектуру private AI API разумно сначала сверить с гайдом по внутреннему AI API, а этот runbook применять только к state path на Linux edge.
Как возникает коллизия одинаковых tuple
Conntrack описывает поток через протокол и адреса/порты original и reply direction. NAT опирается на эту запись: преобразование выбирается для первого пакета, а последующие пакеты используют уже сохранённое состояние. Поэтому проблема редко выглядит как «сломался firewall». Один tenant получает стабильные ответы, второй периодически видит reset, timeout или INVALID, причём backend-логи могут показывать лишь часть запросов.
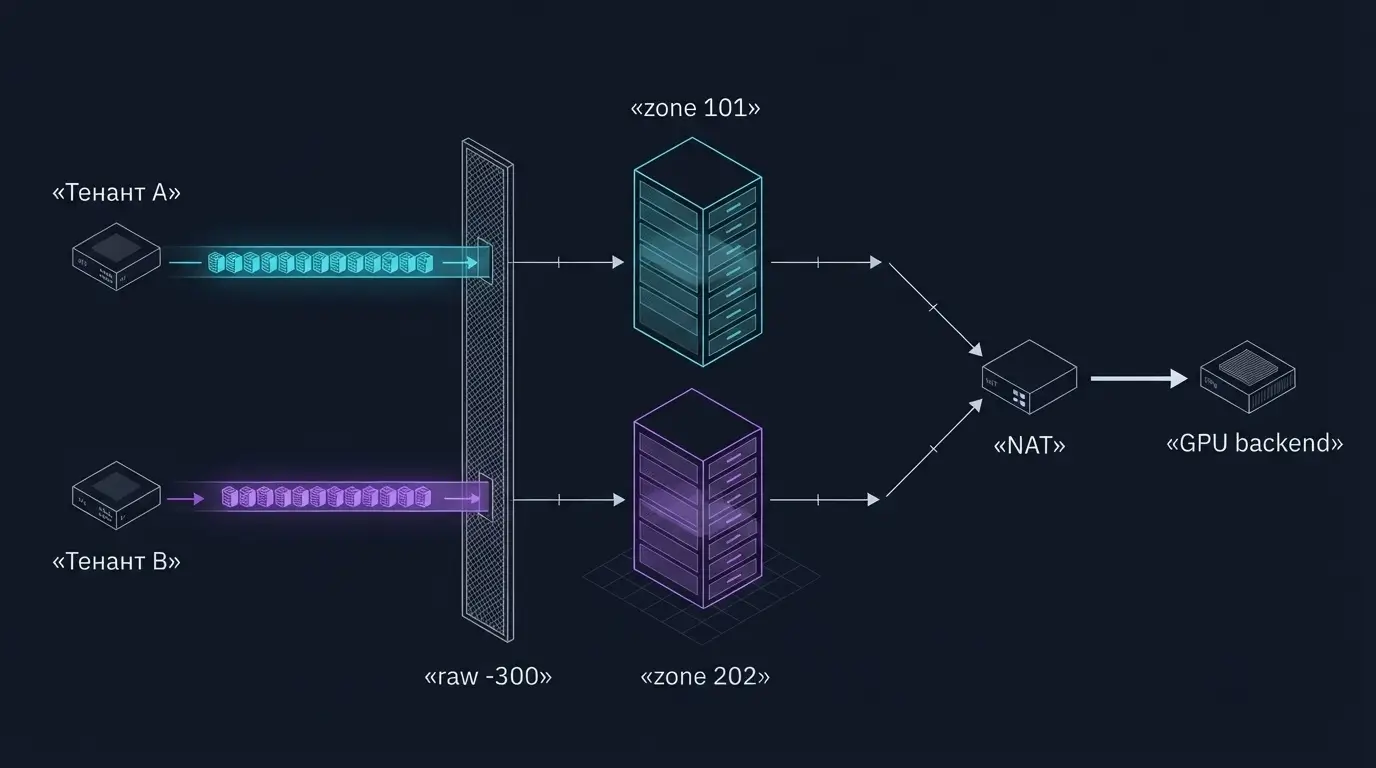
Представьте два изолированных клиентских сегмента. В обоих приложение выходит с 10.0.0.5:41000 на VIP 192.0.2.20:443 по TCP. На одном Linux gateway эти четыре поля вместе с протоколом совпадают. Интерфейсы разные, но интерфейс не является частью обычного tuple-ключа. Zone добавляет ещё один логический идентификатор: поток tenant A живёт в zone 101, поток tenant B — в zone 202. Совпадающие адреса перестают означать одно и то же состояние.
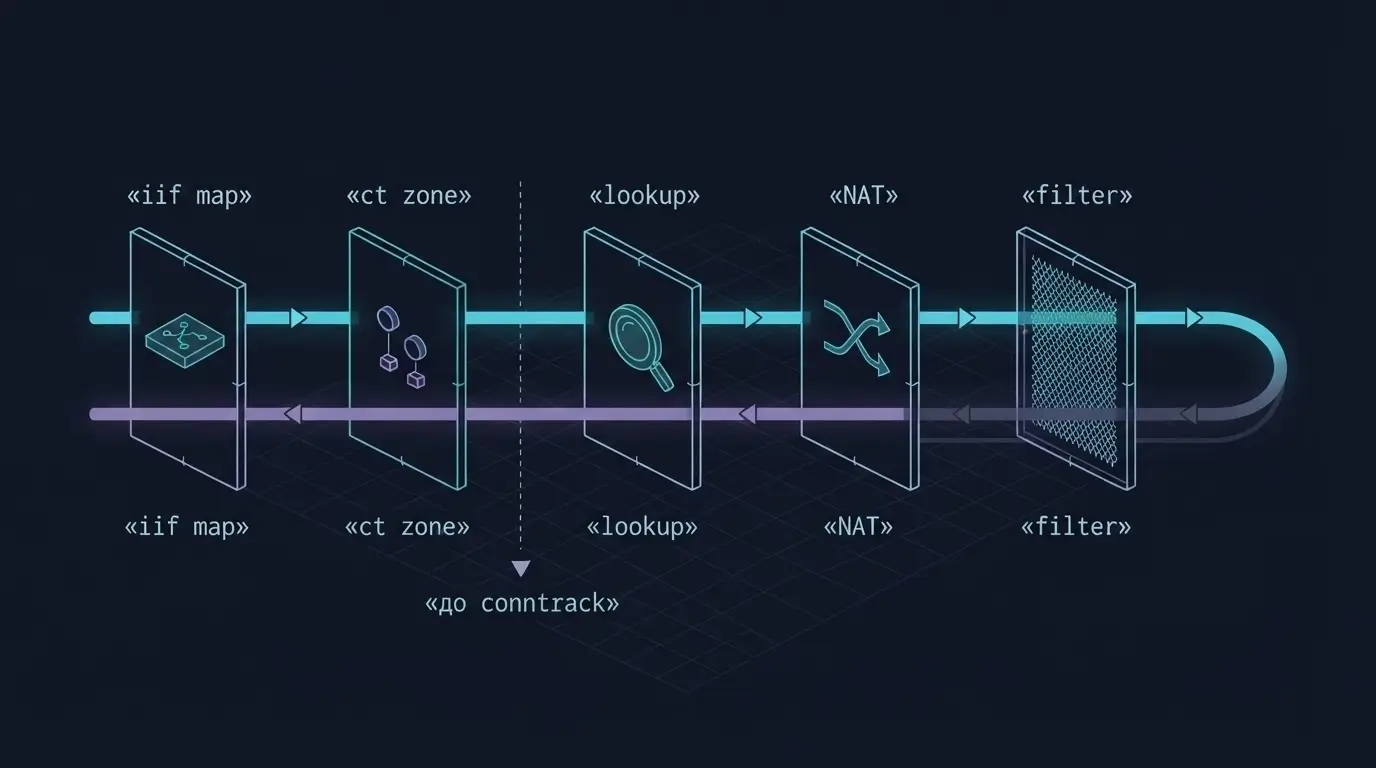
Важно не путать zone с mark. ct mark — метаданные уже найденной connection entry, полезные для policy routing или фильтрации. Zone должна быть назначена до conntrack lookup; официальный nftables man page прямо требует ранний hook с priority raw (-300). Если поставить ct zone set после lookup, правило выглядит убедительно, счётчик растёт, но нужную таблицу состояния пакет уже выбрал.
Evidence chain до изменения ruleset
Начните из effective network namespace процесса, который принимает tenant-трафик. Это защищает от типичной ошибки: оператор смотрит conntrack в host namespace, хотя NAT выполняет sidecar, отдельный namespace или виртуальный роутер. Зафиксируйте ip netns identify для процесса, интерфейсы, адреса, route lookup и действующий ruleset. Отдельно отметьте, где терминируется TLS: после termination исходный client tuple может исчезнуть, и zone на другом hop ничего не изменит.
Следующий gate — state. Для каждого арендатора создайте новый TCP connection, а не переиспользуйте keepalive. Одновременно снимите события conntrack и paired capture на ingress и backend-интерфейсе. Ищите не просто строку ESTABLISHED, а согласованную цепочку: SYN вошёл через ожидаемый интерфейс; original tuple принадлежит нужному tenant; reply tuple соответствует NAT; статус получает SEEN_REPLY/ASSURED; приложение возвращает корректный tenant-specific ответ.
Healthy control обязателен. Возьмите поток с заведомо уникальным tuple и прогоните те же probes. Forbidden control тоже полезен: попытка tenant A обратиться к адресу или credential tenant B должна остаться запрещённой. Без этих сравнений легко принять общий сетевой сбой за проблему zones. Похожий принцип «сначала path, затем fast path» используется в нашем runbook по nftables flowtable.
# Выполняйте в effective network namespace шлюза
ip -br link
ip -br address
ip route get 10.50.0.10 from 10.0.0.5

conntrack -L -w 101 -o extended
conntrack -E -w 101 -o timestamp

tcpdump -ni veth-a tcp port 443 -w /tmp/tenant-a-ingress.pcap
tcpdump -ni backend0 host 10.50.0.10 and tcp port 8443 \
  -w /tmp/tenant-a-backend.pcap
Правильный порядок nftables: zone до lookup
Минимальный дизайн связывает zone с неизменным признаком ingress: выделенным veth, VLAN subinterface, tunnel device или другим контролируемым интерфейсом. Не выводите zone из адреса, если адресные пространства как раз пересекаются. И не назначайте её по HTTP header: L7-идентичность появляется позже, чем conntrack lookup. Owner mapping должен быть понятен дежурной смене без чтения всей платформенной схемы.
В nftables zone назначают в base chain на hook prerouting с priority raw. Для локально созданного трафика может потребоваться симметричная логика в output; конкретное правило зависит от того, какой интерфейс и route известны на этой стадии. Не копируйте output mapping механически: сначала проследите local flow. Значение zone — 16-битное целое, поэтому заведите registry «tenant/failure domain → zone ID» и запретите случайное переиспользование.
DNAT, stateful filtering и другие решения идут позже. В примере ниже deliberately нет полного production firewall: он показывает только критический порядок. Сначала проверьте синтаксис через nft -c, затем загрузите ruleset атомарно из файла. Актуальная ветка Netfilter на дату запуска — nftables 1.1.7 и conntrack-tools 1.4.9 по официальным release announcements; дистрибутив может поставлять более старый backport, поэтому сверяйте nft --version и kernel support на целевом узле.
table inet tenant_ct {
    chain prerouting_zone {
        type filter hook prerouting priority raw; policy accept;
        ct zone set iif map {
            "veth-a" : 101,
            "veth-b" : 202
        }
    }
}

table ip tenant_nat {
    chain prerouting {
        type nat hook prerouting priority dstnat; policy accept;
        iifname "veth-a" tcp dport 443 dnat to 10.50.0.10:8443
        iifname "veth-b" tcp dport 443 dnat to 10.50.0.10:8443
    }
}
Canary и A/B/A без потери существующих соединений
Главная ловушка rollout — ожидание, что новая zone «переместит» уже существующие connection entries. Она не мигрирует state автоматически. Длинные SSE-потоки, WebSocket и keepalive могут продолжать жить в старом домене, пока fresh connections идут в новом. Поэтому заранее разделите две проверки: поведение новых соединений и drain старых. Резко очищать всю conntrack table на production gateway ради чистого теста нельзя.
Выберите одного tenant и небольшой контролируемый источник трафика. Сохраните baseline ruleset, counters и application outcome. Примените candidate атомарно, затем создайте серию новых connections с уникальным request ID. Для каждого сопоставьте ingress capture, запись conntrack -w ZONE, backend log и ответ API. Success означает не только отсутствие timeout: forbidden control не проходит, tenant identity не смешивается, а latency/error rate не ухудшаются относительно healthy control.
A/B/A завершает причинную связь. После положительного B верните baseline, дождитесь или организуйте drain canary connections и повторите те же probes. Если симптом возвращается в A и снова исчезает при повторном B, гипотеза становится сильнее. Если он исчез и без zone, ищите race, route asymmetry или приложение. Сценарий похож на безопасный rollout SO_REUSEPORT/eBPF: один owner за изменение, явные stop conditions и симметричный rollback.
# Baseline включает flush, чтобы rollback был воспроизводимым
{ echo 'flush ruleset'; nft list ruleset; } > /root/nftables-baseline.nft

nft -c -f /etc/nftables/tenant-zones.nft
nft -f /etc/nftables/tenant-zones.nft

# Fresh connection: запретите клиенту reuse существующего TCP session
curl --no-keepalive --connect-timeout 3 \
  -H 'X-Request-ID: zone-canary-a1' https://tenant-a.example/v1/models

# Rollback тем же артефактом и повтор тех же probes
nft -f /root/nftables-baseline.nft
Ёмкость conntrack и наблюдаемость по zone
Zones разделяют ключи, но не создают бесплатную память. На одном network namespace entries по-прежнему расходуют общий conntrack budget. Проверяйте nf_conntrack_count рядом с nf_conntrack_max, hash buckets, insert failures и drops. Официальная kernel documentation уточняет, что accounting добавляет 64-битные counters пакетов и байтов к каждому flow, а размер hash table имеет собственные ограничения. Включать дополнительные extensions следует осознанно, с оценкой памяти и причины.
Не ставьте алерт только на процент заполнения. Нужны три слоя: ресурс, state path и приложение. Ресурс показывает count/max и kernel statistics; state path — NEW/UPDATE/DESTROY по выбранной zone, UNREPLIED, INVALID, ранние уничтожения; приложение — долю успешных fresh connections, time to first token, resets и tenant mismatch. Рост count сам по себе может быть нормальным пиком, а редкий insert failure способен ударить по клиентам раньше красивого threshold.
Собирайте метрики с ограниченной cardinality. Zone ID допустим как label, если registry ограничен и стабилен; request ID, tuple и client IP в metric labels быстро раздуют хранилище. Для расследования tuple оставляйте в событиях или краткоживущем capture. И обязательно следите за ENOBUFS у consumer conntrack events: потерянные netlink events создают «дырявую» картину даже при здоровом kernel state.
sysctl net.netfilter.nf_conntrack_count
sysctl net.netfilter.nf_conntrack_max
sysctl net.netfilter.nf_conntrack_buckets

conntrack -S
conntrack -L -w 101 -o extended
conntrack -L -w 202 -o extended

# События canary zone; остановите после диагностического окна
conntrack -E -w 101 -e NEW,UPDATES,DESTROY -o timestamp
Типичные ошибки и точная диагностика
Первая ошибка — назначить zone слишком поздно. Симптом коварный: ct zone может отображаться в последующем match, но первая запись уже создана в default zone. Проверяйте hook и priority в полном ruleset, а не отдельный фрагмент. Вторая ошибка — настроить только original direction. Reply приходит другим интерфейсом или local output path, не получает согласованный zone context и становится INVALID. Исправление начинается не с копирования правил, а с paired capture обоих направлений.
Третья ошибка — считать любой UNREPLIED коллизией. Backend мог не слушать порт, security group мог отбрасывать ответ, а route мог быть асимметричным. Сопоставляйте wire evidence: если SYN ушёл к backend, но SYN-ACK не вернулся, zone ещё не главный подозреваемый. Если SYN-ACK физически вернулся на gateway, но не сопоставился с entry ожидаемой zone, гипотеза сильнее. Аналогично INVALID — состояние, а не диагноз.
Четвёртая ошибка — смешать zones и policy. Zone изолирует state, но не даёт tenant A право на backend B и не заменяет allowlist, authentication или quota. Stateful accept должен оставаться ограниченным нужным интерфейсом, zone и destination policy. Для больших динамических наборов адресов используйте отдельный подход из статьи про nftables sets, не превращая zone registry в список безопасности.
Наконец, не лечите exhaustion созданием множества zones. Общий memory pressure останется, а on-call получит больше измерений для расследования. Сначала найдите owner длительных entries: streaming clients, слишком долгие timeouts, health checks, retry storm или утечку соединений. Изменение timeout — отдельный canary с пониманием TCP states; глобальное сокращение способно оборвать легитимные long-lived AI streams.
Zone, network namespace или VRF: что выбрать
Conntrack zone — самый узкий инструмент: она разделяет connection state внутри общей сетевой плоскости. Network namespace создаёт отдельный network stack, включая интерфейсы, routes, sockets и собственный conntrack context. VRF в первую очередь разделяет L3 routing domains через отдельные FIB tables, но sockets, firewall hooks и state ownership всё равно требуют явной проверки. Эти механизмы не являются ступенями зрелости; они отвечают на разные вопросы.
Если tenant isolation уже реализована отдельными netns, дополнительная zone часто избыточна: одинаковые tuple находятся в разных conntrack instances. Если нужны разные routing tables в одном namespace, VRF может быть уместен, но не гарантирует автоматически нужный state split для конкретного datapath. Если route общий, а пересекаются только state tuples на одном NAT gateway, zone даёт меньше operational debt. Проверяли ли вы, где именно исчезает уникальность — в route, socket или conntrack key?
Выбор фиксируйте через ownership. Кто выдаёт zone IDs, кто создаёт veth/VLAN, кто меняет NAT, кто проводит drain и кто хранит baseline? Для namespace добавляются lifecycle и service placement; для VRF — l3mdev rules и socket binding; для zone — ранний mapping и симметрия directions. Более сложный control plane оправдан только доказанным failure domain, а не желанием «усилить изоляцию» без threat model.
Когда VPS достаточно, а когда нужен dedicated gateway
Платформу меняют после доказательства control gap, а не после первого timeout. VPS подходит, если гипервизор и provider дают стабильные виртуальные интерфейсы, предсказуемый network namespace, нужные nftables/kernel capabilities и доступ к conntrack telemetry. Для умеренного потока и небольшой tenant map это может быть самым экономным вариантом: меньше hardware ownership, быстрый rollback образа, понятный лимит ответственности.
Dedicated gateway становится разумным, когда evidence показывает дефицит именно на edge: нужен контроль версий kernel/NIC driver, физических очередей, IRQ/NUMA locality, большого state budget, capture без соседского шума или независимого failure domain. Но отдельный сервер не исправит поздний ct zone set, конфликт ID, неправильный reply mapping, L7 retry storm или GPU saturation. Commercial value здесь — воспроизводимый baseline и change window, а не обещание абстрактно меньшей latency.
Сравнивайте варианты по четырём полям: видимость state и wire; владелец kernel/NIC lifecycle; изоляция отказа; время rollback. Добавьте стоимость on-call: кто обновляет ruleset, проверяет совместимость nftables userspace с kernel и восстанавливает mapping после redeploy. Для защиты handshake отдельным механизмом пригодится наш runbook по SYN cookies и SYNPROXY, но не смешивайте его canary с rollout zones.
Production checklist перед расширением rollout
Перед переходом от одного canary tenant к нескольким соберите evidence bundle, который другой инженер сможет воспроизвести без устных подсказок. В него входят схема интерфейсов и namespace, registry zone IDs, полный ruleset с version control, вывод version/kernel, original/reply entries, paired captures, application request IDs и результаты healthy/forbidden controls. Артефакт должен отвечать не только «что поменяли», но и «какую гипотезу это подтвердило».
Зафиксируйте stop conditions: рост INVALID, отсутствие reply в нужной zone, tenant mismatch, потеря событий, приближение к conntrack budget или ухудшение application outcome. Для long-lived streams определите drain window и способ отличить старые connections от новых. Rollback owner должен иметь готовый baseline файл и право применить его, а не искать доступ во время инцидента.
Расширяйте rollout по одному failure domain: сначала tenant, затем gateway instance, затем зона доступности. После каждого шага повторяйте одинаковые probes. Не считайте отсутствие жалоб проверкой: у тихого tenant может просто не быть tuple collision в окне наблюдения. Нужен намеренно созданный overlap test на разрешённом стенде или canary path, плюс запретный тест, который подтверждает сохранение isolation policy.
Последний вопрос — что произойдёт при redeploy? Имена интерфейсов, порядок создания veth и zone registry должны быть стабильны или генерироваться одним controller. Ручное правило, зависящее от эфемерного имени, переживёт canary и сломается после следующего restart. Production-ready означает, что lifecycle механизма так же наблюдаем, как его datapath.
Вывод: изолируйте state только после доказательства
Conntrack zones полезны там, где разные tenant paths намеренно используют одинаковые адреса и порты, сходятся в одном network namespace и должны оставаться независимыми для stateful firewall/NAT. Ключ к безопасному внедрению — не само число zone, а порядок: определить tenant до lookup, назначить zone на raw priority, проверить original и reply direction, а затем связать kernel state с результатом свежего AI API connection.
Хороший rollout оставляет после себя больше, чем рабочий ruleset. У команды есть healthy и forbidden controls, resource budget, ограниченная cardinality метрик, A/B/A evidence и симметричный rollback. Если проверка указывает на route, proxy или GPU queue, zone честно исключается из решения. Это экономит время и удерживает control plane компактным.
Начните с одного overlap test и одного canary tenant. Соберите paired capture, отфильтруйте conntrack по zone и повторите запрос после rollback теми же probes. Когда causal chain подтверждена, переносите mapping в управляемый конфигурационный артефакт и расширяйте rollout по одному failure domain. Если для этого нужен gateway с контролируемым kernel/NIC baseline и отдельным change window, инфраструктуру можно выбирать уже по измеренным требованиям, а не по тревожному графику без диагноза.