Оглавление
- Когда SPIFFE/SPIRE действительно нужен LLM-платформе
- Trust domain, SPIFFE ID и SVID: что именно мы доверяем
- Архитектура SPIRE в Kubernetes без скрытой магии
- Registration entries и attestation: привязываем identity к workload
- Workload API, CSI и SDS: как доставить SVID приложению
- mTLS для LLM inference: authentication ещё не authorization
- Четыре evidence gate: от узла до ответа модели
- Canary и rollback: меняем одного owner за раз
- Federation между кластерами: когда один trust domain уже мешает
- Эксплуатация: метрики, ротация ключей и типовые отказы
- Практическая матрица выбора и план внедрения
Готовы перейти на современную серверную инфраструктуру?
В King Servers мы предлагаем серверы как на AMD EPYC, так и на Intel Xeon, с гибкими конфигурациями под любые задачи — от виртуализации и веб-хостинга до S3-хранилищ и кластеров хранения данных.
- S3-совместимое хранилище для резервных копий
- Панель управления, API, масштабируемость
- Поддержку 24/7 и помощь в выборе конфигурации
Результат регистрации
...
Создайте аккаунт
Быстрая регистрация для доступа к инфраструктуре
Когда SPIFFE/SPIRE действительно нужен LLM-платформе
Короткий вердикт: SPIFFE/SPIRE стоит внедрять, когда обычной сетевой доступности уже недостаточно и вам нужно доказуемо отвечать на вопрос «какой workload вызвал модель». Это особенно заметно в Kubernetes-кластере, где gateway, RAG-оркестратор, vector database и inference-сервис масштабируются независимо, а IP-адрес пода живёт меньше, чем сертификат, выписанный вручную.
SPIFFE задаёт формат идентичности и API получения удостоверений, а SPIRE реализует control plane: аттестует узлы и процессы, сопоставляет selectors с registration entries и выдаёт короткоживущие SVID. В актуальном на дату запуска релизном ряду SPIRE последней стабильной версией является 1.15.3; перед production-rollout всё равно сверяйте release notes и совместимость chart с вашей версией Kubernetes. Официальный Kubernetes quickstart проверен авторами документации на версиях 1.29–1.34, поэтому за пределами этого диапазона нужен отдельный compatibility test.
Не путайте это с «включить service mesh». Mesh может потреблять workload identity, но не заменяет модель доверия. У KingServers уже есть отдельный обзор service mesh; здесь задача уже: построить evidence chain от Kubernetes ServiceAccount до успешного LLM-запроса и безопасно откатить изменение.
Есть и честный disqualifier. Если у вас один сервис, один namespace и нет требования различать вызывающие workload, SPIRE добавит control plane, state, мониторинг и on-call обязанности без соразмерной пользы. Сначала зафиксируйте threat model и owner, затем выбирайте технологию.
Trust domain, SPIFFE ID и SVID: что именно мы доверяем
Trust domain — административная граница доверия, а не красивый DNS-суффикс. Идентификатор вида spiffe://ai.example/ns/inference/sa/model-gateway должен выражать стабильную роль workload, а не имя конкретного пода. Тогда replica replacement не меняет policy, но чужой ServiceAccount не получает тот же доступ автоматически.
X509-SVID содержит SPIFFE ID в URI SAN и проверяется по bundle соответствующего trust domain. Важно сохранить пару «trust domain → bundle»: объединять все корни в один безымянный пул опасно, потому что один домен тогда может начать выдавать идентичности за другой. Это требование прямо закреплено в SPIFFE Trust Domain and Bundle.
Для LLM-платформы удобно разделить роли: gateway вызывает inference, RAG worker читает vector storage, telemetry collector принимает метрики, batch evaluator ходит в отдельный endpoint. Не выдавайте одну универсальную identity всему namespace. Реальный сбой здесь выглядит прозаично: новый debug-под запускают под общим ServiceAccount, и он неожиданно получает доступ к model endpoint. Negative control с «чужим» ServiceAccount должен закончиться отказом mTLS или authorization policy, а не HTTP 200.
Архитектура SPIRE в Kubernetes без скрытой магии
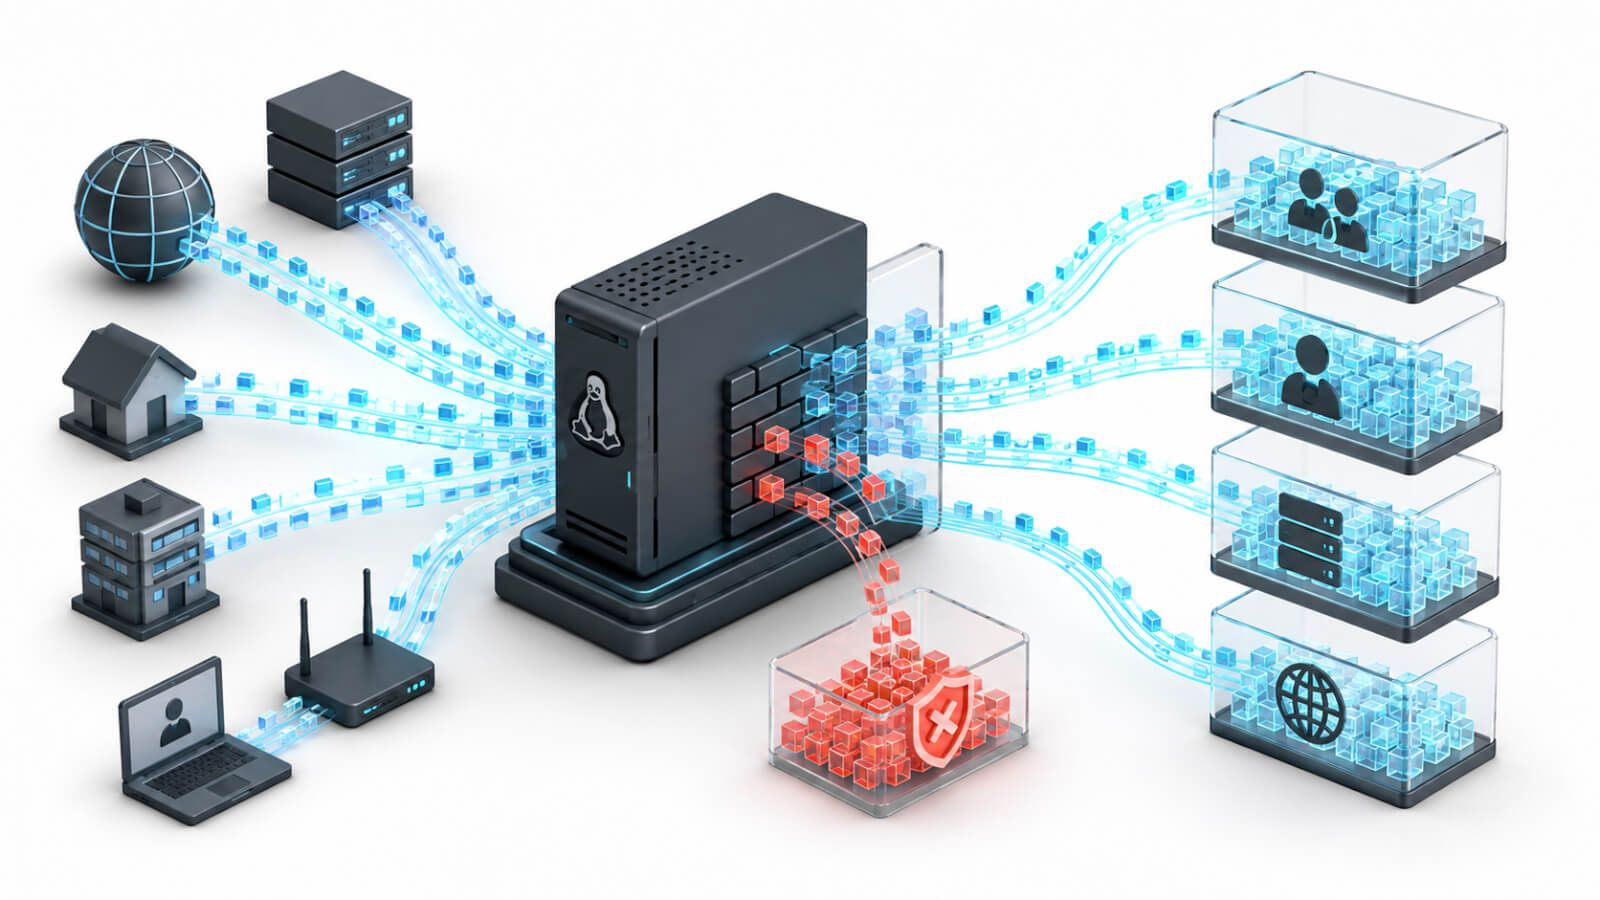
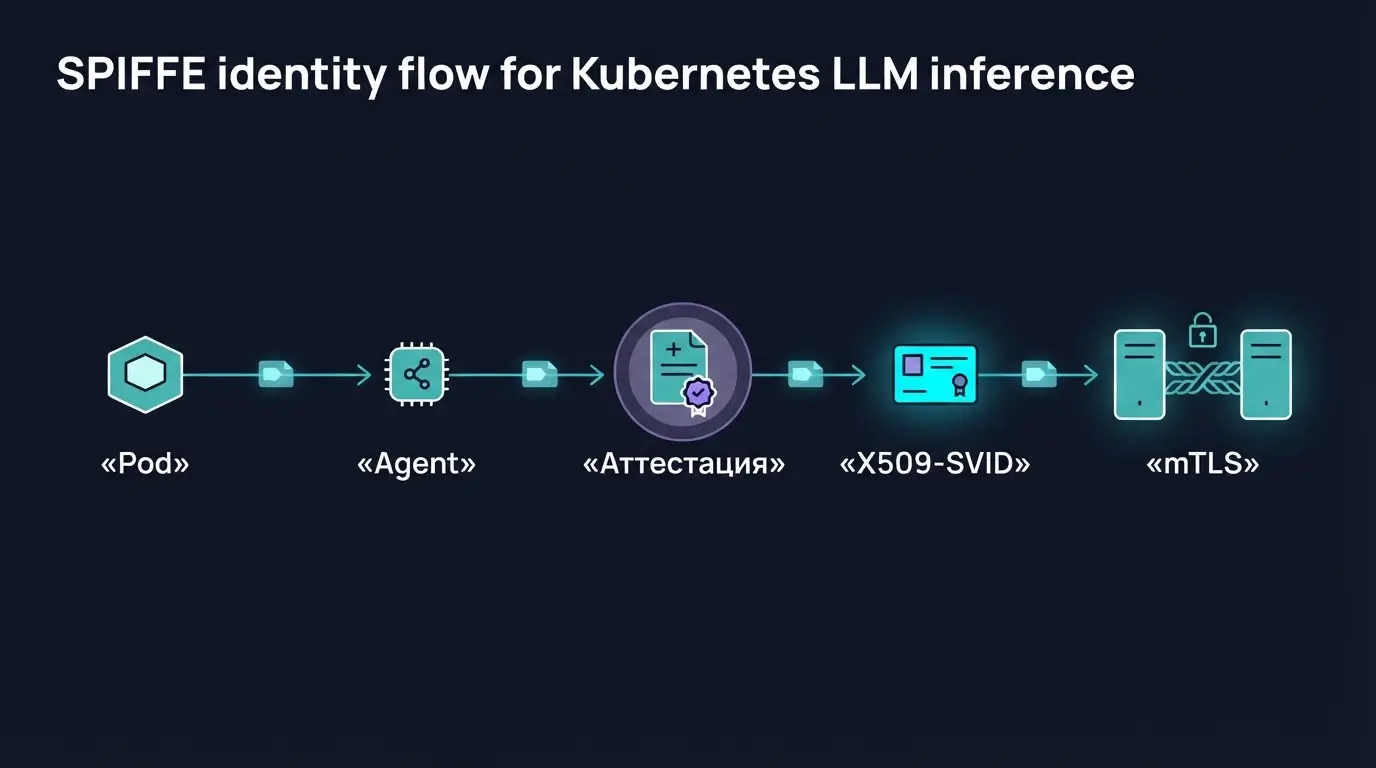
Базовая топология состоит из SPIRE Server, SPIRE Agent на каждом worker node и способа доставки Workload API workload. Server хранит registration entries и подписывает SVID; Agent проходит node attestation, получает разрешённые entries, а затем локально аттестует вызывающий процесс. Согласно SPIRE Concepts, Agent определяет PID клиента локального Unix-сокета и через workload attestor получает Kubernetes selectors, включая namespace и ServiceAccount.
Для production Kubernetes официальный hardened Helm stack включает Server, Agent, Controller Manager, OIDC Discovery Provider и CSI Driver. Не включайте всё машинально: JWT-SVID и OIDC bridge нужны не каждому. Зафиксируйте владельца datastore, резервное копирование Server state, anti-affinity и поведение при недоступности signer. Agent обычно DaemonSet, но его доступ к hostPath socket и kubelet API — часть security boundary, а не техническая мелочь.
Сначала разверните control plane без перевода application traffic. Проверьте health, readiness, server quorum, node attestation и наличие Agent на нужных GPU-узлах. Если GPU node tainted, DaemonSet без подходящего toleration оставит именно критичные inference-поды без Workload API. Знакомо? Control plane формально зелёный, а нужный узел выпал из identity coverage.
kubectl -n spire get pods -o wide
kubectl -n spire get statefulset,daemonset
kubectl -n spire logs statefulset/spire-server --tail=100
kubectl -n spire get pods -l app.kubernetes.io/name=spire-agent   -o custom-columns=NAME:.metadata.name,NODE:.spec.nodeName,READY:.status.containerStatuses[0].ready
Registration entries и attestation: привязываем identity к workload
Registration entry связывает SPIFFE ID, parent ID агента и selectors. Для Kubernetes минимальная полезная пара selectors — namespace и ServiceAccount. Добавлять pod label можно, но тогда жизненный цикл label становится частью security policy: кто имеет право его поставить, проверяется ли admission policy, что случится при rename?
Не создавайте entry по принципу «пока заработало». Сначала выпишите таблицу: caller, callee, разрешённый метод или endpoint, ожидаемый SPIFFE ID, selectors, owner. Для model gateway это может быть только ns:ai-serving и sa:model-gateway. RAG worker получает другую identity, даже если оба вызывают один inference endpoint. Так authorization layer сможет различать online traffic и batch.
Kubernetes projected ServiceAccount token полезен для attestation: он имеет audience и срок действия, а kubelet обновляет его. Возможность projection стабильна с Kubernetes 1.20; приложение или интеграция должны перечитывать ротируемый token. Документация Kubernetes подчёркивает, что token bound к Pod/ServiceAccount и становится недействительным после удаления объекта. Это лучше долгоживущего Secret, но audience и issuer всё равно надо проверять.
kubectl exec -n spire statefulset/spire-server --   /opt/spire/bin/spire-server entry create   -spiffeID spiffe://ai.example/ns/ai-serving/sa/model-gateway   -parentID spiffe://ai.example/spire/agent/k8s_psat/cluster-a/REPLACE_NODE_UID   -selector k8s:ns:ai-serving   -selector k8s:sa:model-gateway

kubectl exec -n spire statefulset/spire-server --   /opt/spire/bin/spire-server entry show
Workload API, CSI и SDS: как доставить SVID приложению
Есть три типовых потребителя. SPIFFE-aware приложение подключается к Workload API и получает поток X509-SVID плюс bundles. Proxy вроде Envoy может получать секреты через SDS. Legacy-приложение иногда требует файлы сертификата и ключа; для него используют CSI или вспомогательный процесс, но нужно доказать корректную reload-семантику.
SPIFFE Workload API стримит обновления, поэтому правильный клиент меняет credential без рестарта. Это важнее короткого TTL: если библиотека прочитала сертификат один раз при старте, ротация превратится в отложенный outage. Для Envoy SDS позволяет принять новый secret без redeploy, но listener или upstream cluster зависит от доступности SDS и валидности ответа. Наблюдайте не только expiration SVID, но и последнее успешное обновление.
CSI socket нельзя монтировать во все pod «для удобства». Доступ к Workload API даёт возможность запросить identity, разрешённую selectors конкретного процесса; ошибка в isolation или selectors расширяет blast radius. В threat model отдельно рассмотрите privileged pod, hostPID и доступ к hostPath.
mTLS для LLM inference: authentication ещё не authorization
Успешная проверка X509-SVID отвечает на вопрос «кто подключился», но не «что ему разрешено». После TLS handshake gateway должен сопоставить SPIFFE ID с policy: model-gateway может вызвать streaming inference, evaluator — batch endpoint, telemetry collector — только metrics. Иначе вы замените общий сертификат общим allow rule.
Для streaming LLM особенно важно не смешивать identity rollout с timeout, retry и buffering. Длинное соединение может продолжать жить на старом SVID до закрытия, хотя новый уже выдан. Проверяйте отдельно новые и существующие connections. Материал про HTTP/2 GOAWAY и gRPC keepalive помогает отделить graceful drain от identity failure.
Application gate должен измерять не только TLS. Отправьте небольшой детерминированный inference-запрос, подтвердите first token и завершение stream, а затем повторите его с чужой identity. Если оба проходят, криптография работает, но authorization нет. Если оба падают, сначала смотрите bundle, SAN и time sync, а не GPU utilization.
openssl x509 -in /run/spiffe/svid.pem -noout   -subject -issuer -dates -ext subjectAltName

openssl verify -CAfile /run/spiffe/bundle.pem /run/spiffe/svid.pem

# Выполняйте из canary workload с ожидаемым ServiceAccount
curl --cert /run/spiffe/svid.pem --key /run/spiffe/svid-key.pem   --cacert /run/spiffe/bundle.pem   https://model-gateway.ai-serving.svc/v1/models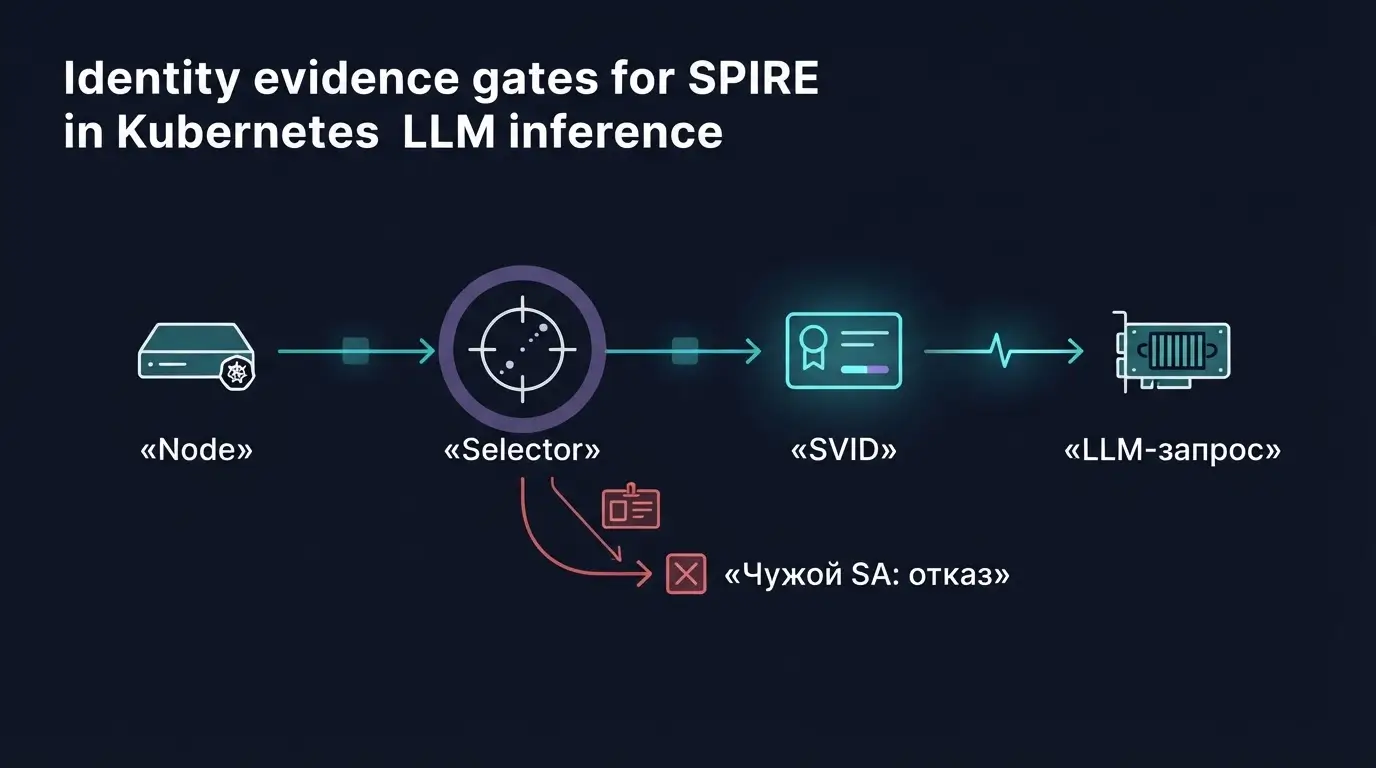
Четыре evidence gate: от узла до ответа модели
Чтобы не получить false green, разделите проверку на четыре независимых gate. Первый — node attestation: Agent действительно допущен нужным Server и виден на конкретном GPU-узле. Второй — workload selectors: фактический PID/Pod сопоставлен ожидаемой entry. Третий — credential path: клиент получил SVID и bundle, peer проверил SPIFFE ID, ротация дошла без рестарта. Четвёртый — application outcome: авторизованный запрос завершился, неавторизованный был отклонён, latency и error rate остались в бюджете.
Не переносите доказательство между слоями. Наличие SVID на диске не доказывает, что Envoy использует его. Успешный handshake не доказывает, что policy проверила нужный URI SAN. HTTP 200 от health endpoint не доказывает, что streaming route видит GPU backend. Для каждого gate сохраните команду, timestamp, node, pod UID и ожидаемый результат.
NetworkPolicy остаётся отдельным слоем. SPIFFE identity не запрещает пакет, а policy сети не удостоверяет вызывающий процесс. Практический default-deny и negative controls разобраны в материале про Kubernetes NetworkPolicy для LLM inference. Эти механизмы дополняют друг друга, но имеют разных owners и разные rollback.
date -u
kubectl get pod -n ai-serving -l app=model-gateway -o wide
kubectl get pod -n ai-serving -l app=model-gateway   -o jsonpath='{range .items[*]}{.metadata.uid}{" "}{.spec.serviceAccountName}{"\n"}{end}'
kubectl -n spire logs daemonset/spire-agent --since=10m |   grep -E 'attest|selector|SVID|error'
kubectl -n ai-serving logs deploy/model-gateway --since=10m | grep -E 'spiffe|tls|denied|upstream'Canary и rollback: меняем одного owner за раз
Начните с одной пары caller–callee и одного route. Baseline должен включать успешный запрос штатного клиента, отказ negative-control клиента, текущий error rate и поведение долгого stream. Затем включите SVID только для canary replica или отдельного hostname, не меняя одновременно retries, proxy version и NetworkPolicy.
A/B/A полезнее красивого dashboard. В A сохраняется старый путь. В B canary использует SPIFFE identity и выдаёт ожидаемый application outcome. В финальном A вы возвращаете старый credential path и повторяете те же probes. Если симптом не возвращается или исчезает несимметрично, причинность не доказана. После этого снова включайте B и расширяйте долю.
Rollback должен быть выполним, пока команда уставшая: вернуть route weight, восстановить предыдущую TLS policy, проверить старый Secret и удалить canary entry. Но не держите общий static certificate бесконечно «на всякий случай» — назначьте срок удаления. Для каждой фазы запишите stop condition: рост handshake failures, недоступность Workload API, SVID ближе к expiry без update или ухудшение application SLO.
Federation между кластерами: когда один trust domain уже мешает
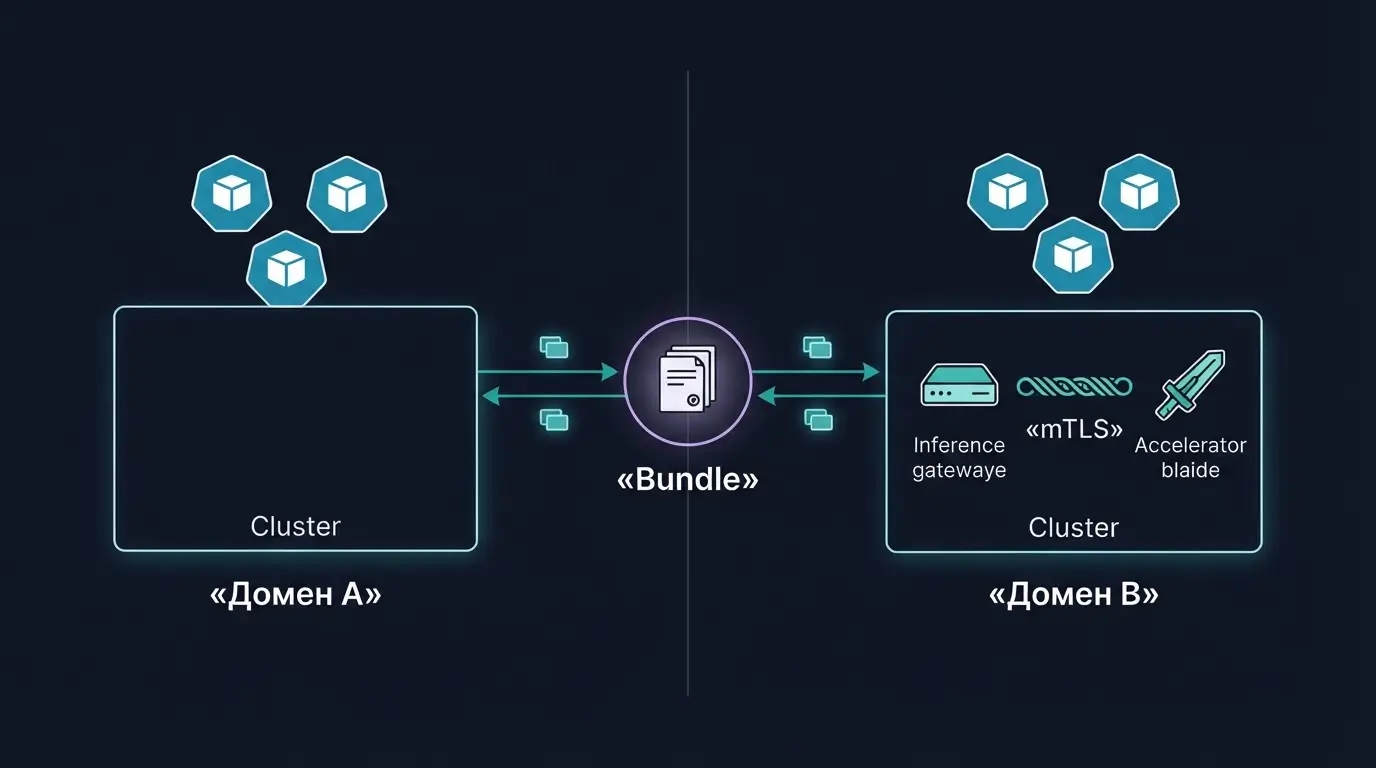
Federation нужна, когда два административно независимых trust domain должны аутентифицировать workload друг друга. Например, edge gateway в одном кластере вызывает GPU inference в другом, а команды независимо управляют signer, entries и release windows. Сливать их в один root проще только до первого incident review: граница ответственности исчезает.
SPIFFE Federation обменивает bundles через bundle endpoints. Отношение одностороннее; для взаимной аутентификации требуются отношения в обе стороны. Клиент обязан связывать endpoint, profile и trust domain, а новые signing keys публиковать заранее. Спецификация рекомендует дать получателям несколько refresh intervals до начала выдачи SVID новым ключом.
Не начинайте с federation. Сначала докажите локальный identity path в каждом кластере, затем bundle retrieval, затем server authentication, затем cross-domain application request. Negative control — SPIFFE ID из третьего или неразрешённого domain. Long chains доверия усложняют анализ компрометации; официальный SPIFFE Federation spec прямо предупреждает об этом.
Эксплуатация: метрики, ротация ключей и типовые отказы
У SPIRE есть собственный SLO. Следите за успешностью node attestation, числом активных agents, ошибками Workload API, возрастом последнего SVID update, временем до expiry, состоянием datastore и refresh federated bundles. Метрика «Server pod Ready» не ловит Agent, который потерял доступ к kubelet или не может обновить entry cache.
Отдельный failure drill — ротация signing key. Сначала новый ключ появляется в bundle, затем начинается выдача SVID, подписанных им, и только после истечения старых SVID прежний ключ удаляется. Если убрать ключ рано, вы получите выборочные handshake failures: новые клиенты работают, старые long-lived процессы падают после reconnect. Time sync на nodes и proxies тоже входит в identity SLO.
DNS остаётся bootstrap-зависимостью для Server, federation endpoint и application peers. Не диагностируйте certificate error как DNS и наоборот. Для кластерного кэша и node-dependent path пригодится runbook про NodeLocal DNSCache.
Capacity вопрос появляется позже. Выделенные узлы или серверы дают больше контроля над NIC, kernel, HSM/KMS integration, datastore latency и maintenance window. Но новое железо не исправит широкий selector, общий ServiceAccount, неверный trust bundle или приложение, которое не перечитывает credential. Инфраструктурный апгрейд оправдан после доказанного resource или control gap, а не вместо него.
Практическая матрица выбора и план внедрения
Выбирайте SPIFFE-aware library, когда вы контролируете код и хотите проверять peer ID непосредственно в приложении. Выбирайте Envoy/SDS, когда протокол уже проходит через proxy и команда готова владеть его lifecycle. CSI или файловый адаптер — переходный вариант для legacy, но он переносит риск в permissions и reload. Service mesh уместен, если помимо identity нужны routing, telemetry и policy на большом числе сервисов; для пары сервисов он может быть избыточен.
План на первый sprint: описать trust domain и пять–десять SPIFFE ID, развернуть Server/Agent без влияния на traffic, создать одну entry, получить SVID, проверить authorized и unauthorized handshake, провести rotation drill, затем canary application request. Только после этого расширяйте охват. Для общей архитектуры serving можно свериться с материалом про Kubernetes для AI inference, но identity policy держите отдельным артефактом.
Итог простой: ценность SPIFFE/SPIRE не в том, что сертификаты становятся «автоматическими». Ценность в проверяемой цепочке node → selectors → SVID → peer policy → результат LLM-запроса. Начните с одной связи, сохраните negative control и симметричный rollback. Когда этот путь воспроизводится дежурным инженером без помощи автора схемы, у вас появилась workload identity, а не ещё один сертификатный сервис.