Оглавление
- Почему LLM workload нужен отдельный сетевой контракт
- Как NetworkPolicy принимает решение на самом деле
- Снимите карту зависимостей до default-deny
- Введите default-deny как baseline, а не как финальную политику
- Верните DNS и докажите фактический resolver path
- Разрешайте сервисы по identity, внешние endpoints — по владельцу
- Сделайте metadata endpoint отдельным отрицательным контролем
- Оставьте ingress только от реального gateway
- Наблюдайте verdict, peer и application outcome раздельно
- Проведите rollout с симметричным rollback
- Когда нужен управляемый egress или выделенная инфраструктура
- Вывод: policy должна доказывать границу, а не просто существовать
После включения default-deny LLM-под внезапно перестаёт резолвить model storage, exporter теряет collector, а readiness остаётся зелёным — знакомая картина? Хуже другое: команда открывает весь egress на 443, сервис оживает, но любая уязвимость снова получает прямой путь наружу. В этом runbook разберём NetworkPolicy как проверяемый контракт для GPU inference: от карты зависимостей и DNS до metadata endpoint, canary и rollback. Результатом будет не набор YAML «для галочки», а доказанная граница доступа, которую можно сопровождать в production.
Готовы перейти на современную серверную инфраструктуру?
В King Servers мы предлагаем серверы как на AMD EPYC, так и на Intel Xeon, с гибкими конфигурациями под любые задачи — от виртуализации и веб-хостинга до S3-хранилищ и кластеров хранения данных.
- S3-совместимое хранилище для резервных копий
- Панель управления, API, масштабируемость
- Поддержку 24/7 и помощь в выборе конфигурации
Результат регистрации
...
Создайте аккаунт
Быстрая регистрация для доступа к инфраструктуре
Почему LLM workload нужен отдельный сетевой контракт
После запуска inference-под редко общается с одним соседом. Он принимает запросы от gateway, читает модели или адаптеры из хранилища, обращается к DNS, отправляет метрики и трассировки, иногда вызывает внешние API. Если контейнер скомпрометирован через зависимость, tool call или ошибку приложения, тот же набор маршрутов превращается в канал разведки и вывода данных.
Поэтому задача NetworkPolicy не сводится к «закрыть namespace». Нужен проверяемый контракт: кто имеет право войти в pod, куда pod может выйти, какой компонент владеет каждым разрешением и каким отрицательным тестом доказано, что остальные пути закрыты. Это особенно важно для внутреннего AI API, где один gateway обслуживает несколько команд и наборов данных.
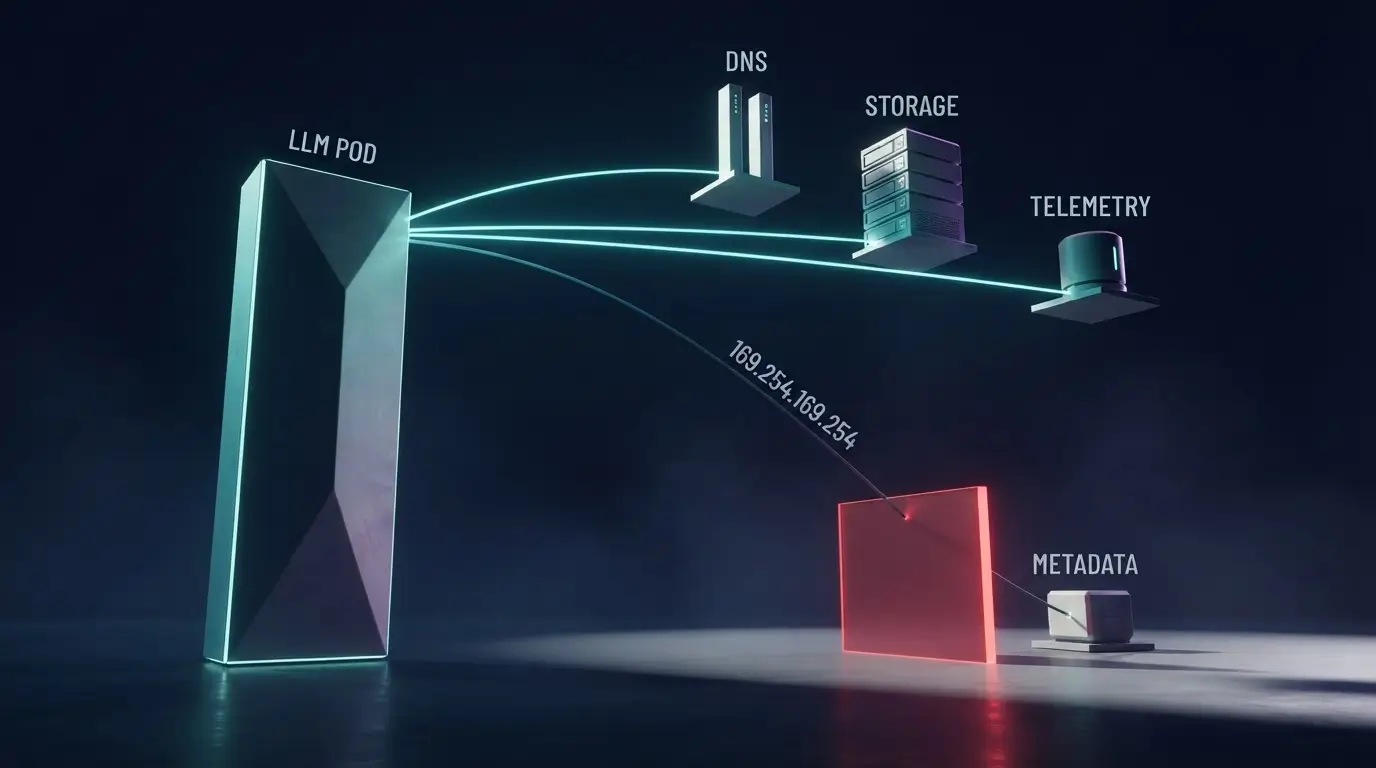
Разделите трафик на четыре плоскости. Ingress — доверенный gateway. Service egress — model storage, базы и очереди. Platform egress — DNS, telemetry и необходимые control endpoints. Запрещённая плоскость — соседние namespaces, произвольный интернет и metadata service, если workload не должен получать node- или cloud-credentials.
Типичная ловушка: команда вводит default-deny, видит падение readiness и сразу добавляет широкий egress. Инцидент как будто устранён, но граница исчезла. Правильный порядок другой: зафиксировать baseline, перечислить зависимости, разрешать их по одной и для каждой держать negative control.
Как NetworkPolicy принимает решение на самом деле
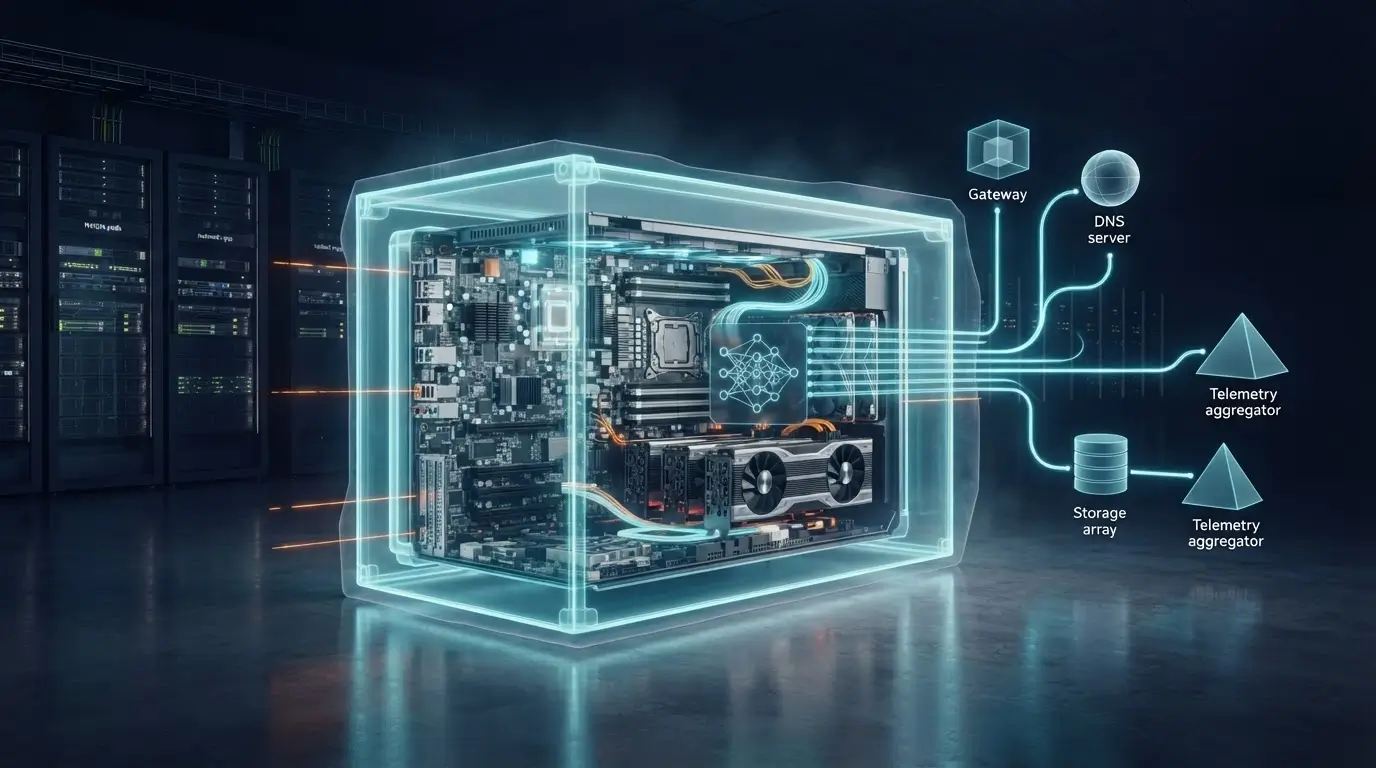
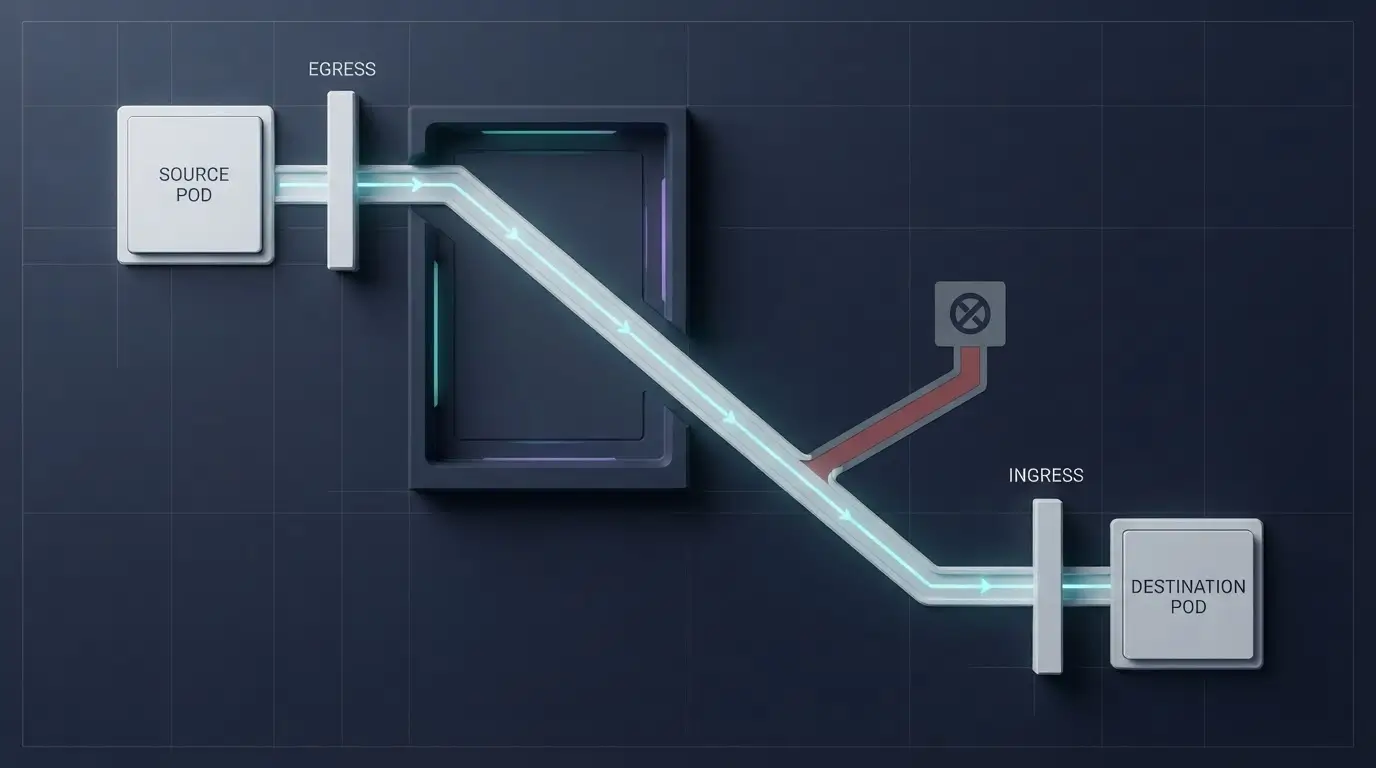
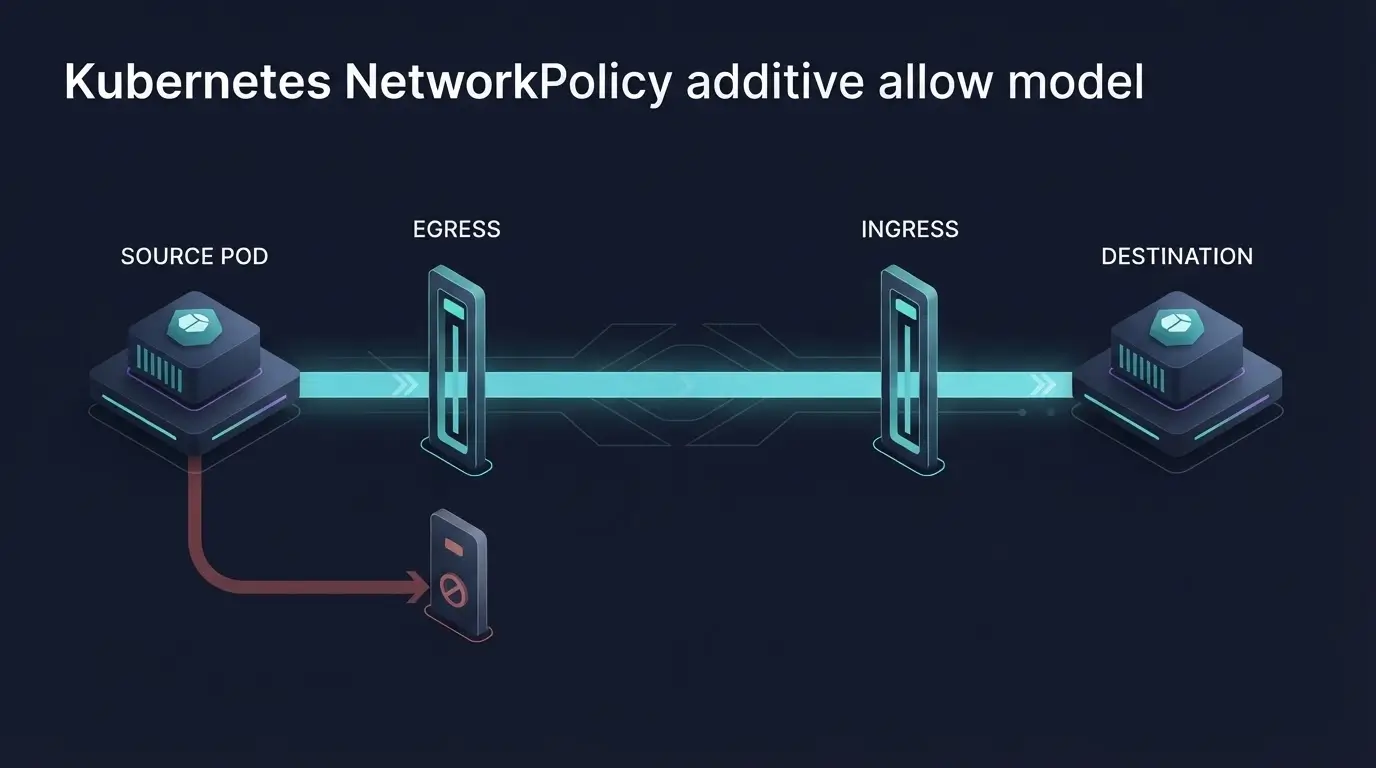
Стандартный NetworkPolicy работает на L3/L4 и описывает разрешения, а не последовательность firewall-правил. Политики аддитивны: если несколько объектов выбирают один pod, итоговый allow-list равен объединению разрешений. Порядок YAML-файлов ничего не меняет. Для соединения pod-to-pod должны одновременно разрешить трафик egress-политика источника и ingress-политика назначения.
По умолчанию pod не изолирован. Он становится изолированным по направлению, когда хотя бы одна политика выбирает его и включает соответствующий policyTypes. Значит, «у нас есть NetworkPolicy» ещё не доказывает защиту egress. Проверьте selector и оба направления отдельно.
Есть обязательный gate: CNI должен поддерживать enforcement. Kubernetes API примет объект даже тогда, когда сетевой плагин его не реализует. Официальная документация Kubernetes прямо предупреждает об этом. Самая честная проверка — canary pod и два маршрута: разрешённый и заведомо запрещённый.
Снимите карту зависимостей до default-deny
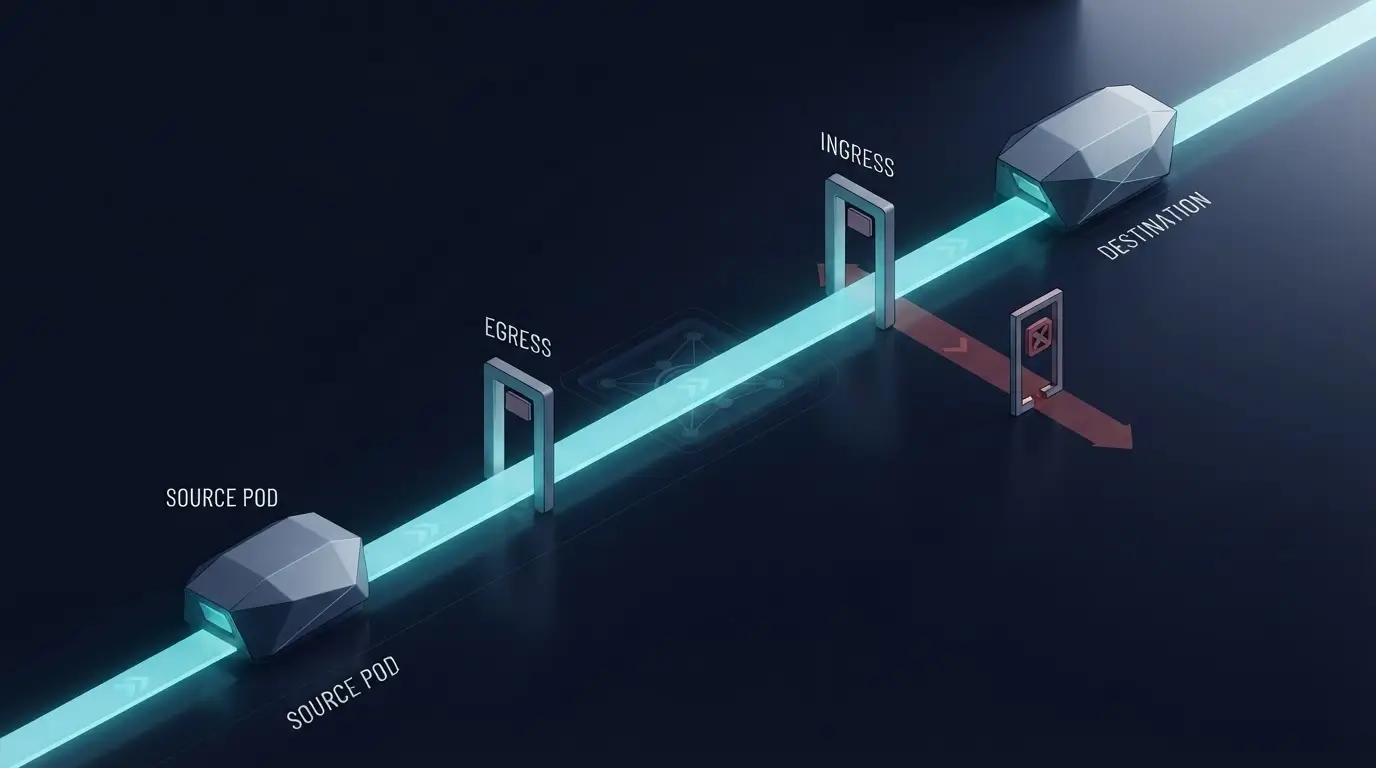
До изменения dataplane соберите наблюдаемый список направлений хотя бы за один репрезентативный цикл: cold start, загрузка модели, health checks, обычный streaming-запрос, отправка метрик и graceful shutdown. Карта из документации полезна, но runtime evidence важнее: забытый exporter или sidecar ломает rollout чаще, чем основной inference-процесс.
Для каждого потока запишите source, destination, protocol, port, способ идентификации и owner. Критический столбец — почему разрешение остаётся стабильным. Внутрикластерный Service удобно выбирать через namespaceSelector + podSelector. Внешний SaaS с меняющимися адресами не становится стабильным только потому, что сегодня dig вернул два IP.
Разделите bootstrap и steady state. Если init container скачивает веса, а основной контейнер только обслуживает GPU, постоянный доступ runtime-пода к registry может быть лишним. Иногда лучше загрузить артефакт через контролируемую Job или локальный read-only volume. Обзор Kubernetes-платформы для AI inference показывает соседние компоненты; здесь каждый из них должен стать явной сетевой зависимостью.
- Ingress: gateway, probes и административный путь, если он нужен.
- Egress: DNS, object storage, telemetry, KMS или внешняя модель.
- Cluster services: очередь, vector DB, cache, model controller.
- Negative set: соседний namespace, случайный публичный адрес, metadata endpoint.
Не переносите наблюдённый трафик в allow-list автоматически. Сначала спросите owner-а, действительно ли зависимость нужна. Компрометированный контейнер тоже создаёт «наблюдаемый» трафик, а старый sidecar может продолжать обращаться к уже ненужному endpoint.
Введите default-deny как baseline, а не как финальную политику
Baseline должен быть коротким: выбрать все pods в целевом namespace и изолировать ingress с egress. Он не содержит исключений и не пытается угадать архитектуру. Именно поэтому его удобно ревьюить и применять к canary namespace до production.
Не накатывайте baseline поверх общего namespace, где живут unrelated workloads. Если selectors и ownership размыты, сначала разнесите приложения или введите обязательные labels. Иначе первое «временное» разрешение быстро станет широким правилом для всех.
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: default-deny-all
  namespace: llm-prod
spec:
  podSelector: {}
  policyTypes:
    - Ingress
- EgressПосле применения DNS и service paths перестанут работать, пока вы их явно не разрешите. Это не дефект baseline, а доказательство того, что dependency map ещё не перенесена в policies. Если canary продолжает ходить к произвольному адресу, остановитесь: selector, namespace или CNI enforcement не соответствуют ожиданию.
Верните DNS и докажите фактический resolver path
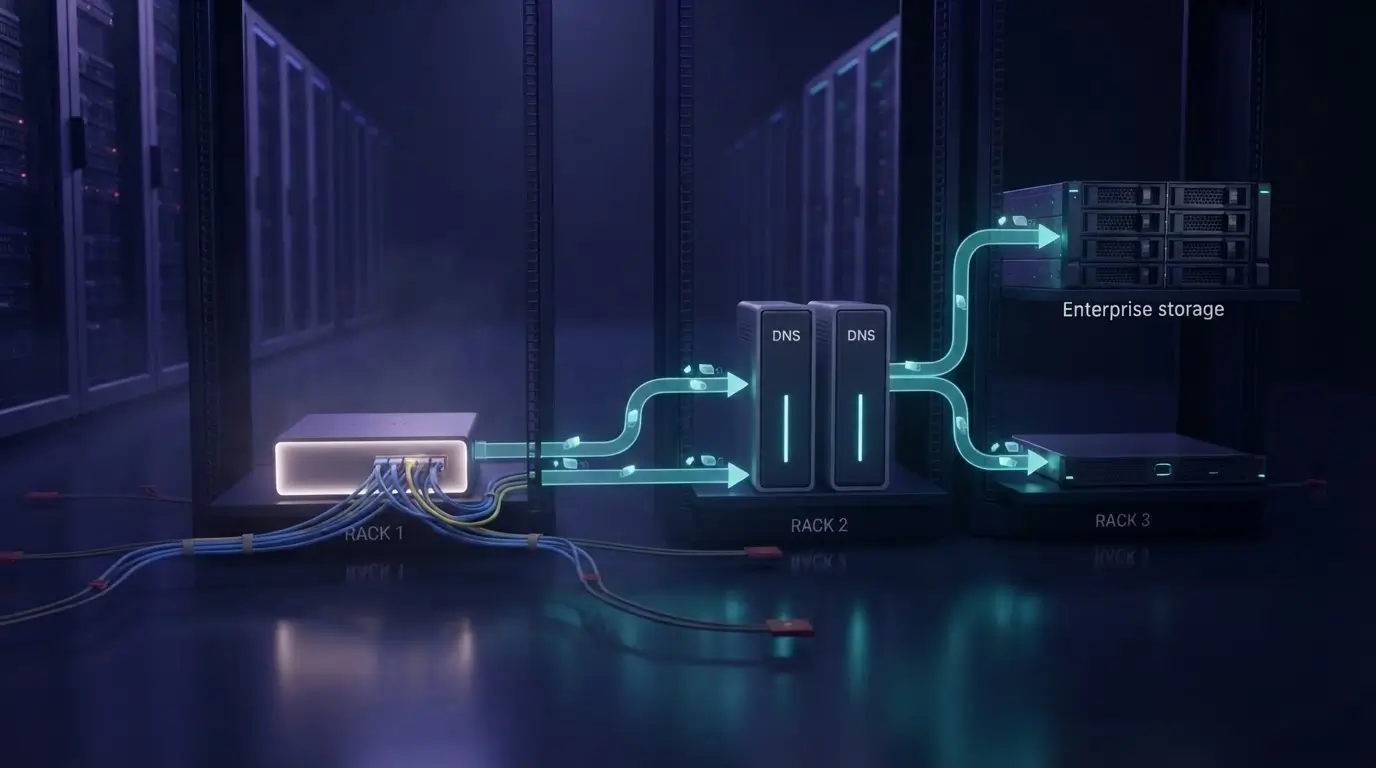
Default-deny egress блокирует DNS. Но правило «разрешить kube-system:53» тоже может оказаться неверным: NodeLocal DNSCache, иной namespace или кастомный resolver меняют фактический путь. Сначала посмотрите /etc/resolv.conf внутри canary pod, затем найдите Service и EndpointSlice resolver-а.
В типовой установке CoreDNS Service называется kube-dns, а pods сохраняют label k8s-app=kube-dns ради обратной совместимости. Разрешайте UDP и TCP 53: TCP нужен для крупных ответов и fallback. DNS runbook Kubernetes предлагает проверять resolver, Service, pods и EndpointSlice отдельно.
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: allow-cluster-dns
  namespace: llm-prod
spec:
  podSelector:
    matchLabels:
      app.kubernetes.io/name: llm-server
  policyTypes: [Egress]
  egress:
    - to:
        - namespaceSelector:
            matchLabels:
              kubernetes.io/metadata.name: kube-system
          podSelector:
            matchLabels:
              k8s-app: kube-dns
      ports:
        - {protocol: UDP, port: 53}
- {protocol: TCP, port: 53}Проверка должна различать три исхода: запрос дошёл до resolver-а, resolver вернул ответ, приложение установило новое соединение к нужному endpoint. Успешный nslookup доказывает первые два шага. Он не доказывает egress на полученный IP и не проверяет reuse существующего connection pool.
Разрешайте сервисы по identity, внешние endpoints — по владельцу
Для cluster-internal зависимостей сочетайте namespaceSelector и podSelector в одном элементе to. Это логическое AND: нужные pods только в нужном namespace. Два отдельных элемента означали бы OR и открыли больше, чем кажется при беглом ревью.
Named ports снижают риск расхождения номера порта между Service и workload, но политика сопоставляется с портом конечного pod. Проверьте реализацию CNI и EndpointSlice, особенно если Service использует другой targetPort. Ниже inference разрешает telemetry только к pods коллектора.
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: allow-otel
  namespace: llm-prod
spec:
  podSelector:
    matchLabels:
      app.kubernetes.io/name: llm-server
  policyTypes: [Egress]
  egress:
    - to:
        - namespaceSelector:
            matchLabels:
              kubernetes.io/metadata.name: observability
          podSelector:
            matchLabels:
              app.kubernetes.io/name: opentelemetry-collector
      ports:
- {protocol: TCP, port: 4317}Внешние сервисы сложнее. Стандартный NetworkPolicy оперирует IP/CIDR, а не доменными именами. Адреса object storage, SaaS telemetry или внешнего LLM API могут меняться. Не превращайте это в 0.0.0.0/0:443 без решения владельца риска. Варианты: управляемый egress proxy, CNI с DNS-aware policy или выделенный network edge.
Если используете Cilium toFQDNs, учитывайте DNS proxy и lifecycle кеша; подробный практический разбор есть в статье о Cilium FQDN egress для LLM API. Документация Cilium объясняет, что ответы DNS превращаются в динамические L3-разрешения. Это расширение Cilium, а не переносимый объект Kubernetes.
Для model registry полезно разделить роли: отдельная Job с egress загружает проверенный digest, runtime pod монтирует read-only volume. Такой дизайн уменьшает постоянный outbound surface и упрощает разбор инцидента: сетевой owner bootstrap не смешивается с owner serving.
Сделайте metadata endpoint отдельным отрицательным контролем
Адрес 169.254.169.254 нельзя считать «просто ещё одним внешним IP». В AWS там работает IMDS, в Google Compute Engine — metadata server; ответы могут включать данные, связанные с identity и credentials. Конкретная семантика зависит от провайдера и конфигурации, поэтому переносить правила между облаками механически опасно.
Стандартный NetworkPolicy не имеет deny-правил с приоритетом. Если другой объект разрешает весь egress на TCP/80, отдельная политика с пустым списком не «перебьёт» это разрешение: allow-sets объединяются. Надёжная модель — default-deny и явные разрешения нужных направлений, которые не включают link-local metadata range.
ipBlock.except исключает CIDR из конкретного allow-правила, но не отменяет разрешение из другой политики. Кроме того, поведение IP вокруг Service NAT может различаться по CNI и cloud provider. Поэтому обязательны runtime negative probes из effective namespace. AWS документирует IPv4 IMDS 169.254.169.254 и отдельный IPv6 endpoint; Google также использует этот IPv4 адрес, но с собственными заголовками и правилами.
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: allow-approved-https-cidrs
  namespace: llm-prod
spec:
  podSelector:
    matchLabels:
      app.kubernetes.io/name: llm-server
  policyTypes: [Egress]
  egress:
    - to:
        - ipBlock:
            cidr: 0.0.0.0/0
            except:
              - 169.254.0.0/16
      ports:
        - {protocol: TCP, port: 443}
Пример показывает механику, но широкое HTTPS-разрешение всё равно оставляет канал вывода данных. Используйте его как промежуточный canary или осознанный trust boundary, не как желаемый финал. Предпочтительнее корпоративные CIDR, egress proxy либо DNS-aware policy с наблюдаемым owner.
Оставьте ingress только от реального gateway
Label app=gateway недостаточен, если любой пользователь namespace может поставить его на свой pod. Trust boundary включает не только selector, но и право создавать workload и менять labels. Для multi-tenant кластера закрепите gateway в отдельном namespace с ограниченным RBAC и выберите одновременно namespace и pod.
Не разрешайте ingress «от Service»: NetworkPolicy видит endpoint traffic и выбирает pods/namespace либо IPBlock. В зависимости от dataplane исходный адрес может быть gateway pod, node или внешний балансировщик. Сначала снимите фактический peer, затем пишите selector. Сохранение client IP и PROXY protocol решают другую задачу и не заменяют workload identity.
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: allow-inference-from-gateway
  namespace: llm-prod
spec:
  podSelector:
    matchLabels:
      app.kubernetes.io/name: llm-server
  policyTypes: [Ingress]
  ingress:
    - from:
        - namespaceSelector:
            matchLabels:
              kubernetes.io/metadata.name: ai-gateway
          podSelector:
            matchLabels:
              app.kubernetes.io/name: llm-gateway
      ports:
- {protocol: TCP, port: 8000}Readiness и liveness probes требуют отдельной проверки. Трафик от node к local pod может обрабатываться иначе, а модель Kubernetes разрешает ingress от node, на котором работает pod. Не делайте из успешной probe вывод, что gateway path открыт; это два разных evidence gate.
Проверьте также sidecars. Если TLS завершается в proxy-контейнере того же pod, NetworkPolicy не различает контейнеры внутри общего network namespace. Сегментация на уровне pod не заменяет аутентификацию приложения, mTLS и минимальные ServiceAccount права.
Наблюдайте verdict, peer и application outcome раздельно
Для диагностики нужны три слоя. Первый — policy verdict: какой endpoint и правило разрешили или отклонили пакет. Второй — фактический peer: куда ушло новое соединение после DNS и балансировки. Третий — outcome приложения: TTFT, streaming completion, ошибки загрузки модели и экспорт telemetry. Один зелёный слой не гарантирует остальные.
Метрики dropped packets без labels workload-а дают шум, а application timeout без сетевого контекста заставляет расширять allow-list наугад. Свяжите flow logs с pod UID, namespace, destination identity и временем rollout. Для внешнего адреса сохраните DNS answer и новый peer; существующий connection pool может пережить изменение policy и исказить тест.
Canary выполняет положительные и отрицательные пробы на fresh connections: резолвит разрешённое имя, подключается к model storage, отправляет telemetry; одновременно пытается открыть соседний namespace, случайный публичный адрес и metadata service. Проверяли ли вы, что запрещённый маршрут падает из-за policy, а не потому, что endpoint недоступен?
Проведите rollout с симметричным rollback
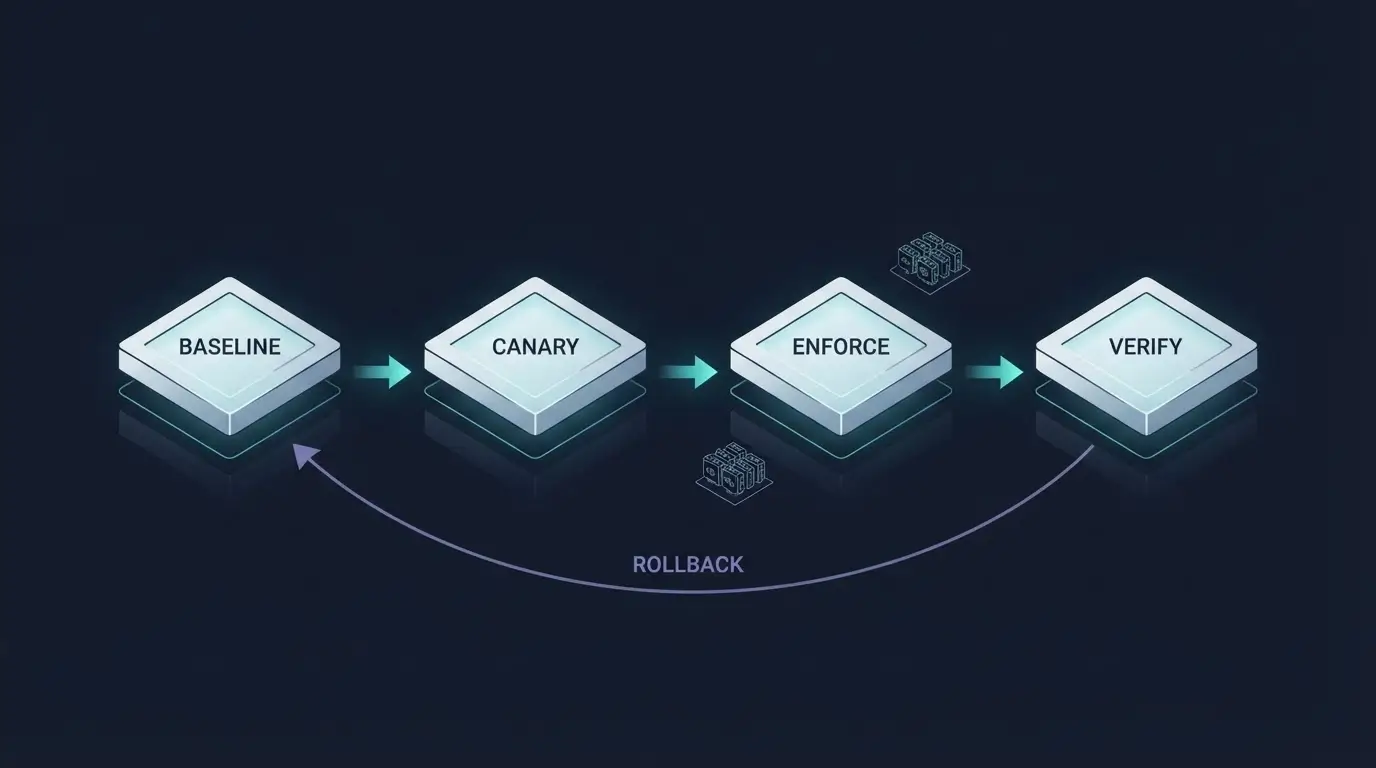
Безопасный rollout начинается не с production namespace, а с копии policy и репрезентативного canary workload. Снимите baseline до enforcement: список peer-ов, DNS answers, error rate, cold-start outcome и завершение streaming-запроса. Затем примените default-deny, добавляйте allow-правила по одному и после каждого повторяйте тот же набор probes.
Не смешивайте изменение NetworkPolicy с обновлением CNI, gateway или модели. Иначе при деградации вы не узнаете owner. Rollback должен быть симметричным: вернуть предыдущую policy revision и повторить те же positive/negative controls. Простое удаление всех политик восстановит доступность, но уничтожит границу безопасности.
- Зафиксируйте namespace labels, pod labels и effective CNI.
- Создайте canary с тем же ServiceAccount, sidecars и DNS policy.
- Проверьте baseline на fresh connections.
- Примените default-deny и подтвердите отрицательные тесты.
- Верните DNS, ingress gateway и обязательный egress по одному.
- Сравните application SLO и flow verdicts.
- Проведите rollback rehearsal до production rollout.
Когда нужен управляемый egress или выделенная инфраструктура
Не начинайте закупку с тезиса «нам нужен отдельный сервер ради NetworkPolicy». Если проблема в неверном selector, широком allow, connection reuse или отсутствии negative control, новое железо её не исправит. Procurement default — оставить текущую платформу, пока canary не доказал дефицит control plane или ownership.
Обычного NetworkPolicy достаточно, когда зависимости имеют стабильные cluster identities или контролируемые CIDR, а команда умеет наблюдать enforcement. DNS-aware CNI либо egress gateway оправдан, когда внешние адреса меняются и нужен единый audit point. Выделенные nodes или dedicated network edge полезны, если требуется контролировать CNI version, маршрутизацию, firewall, flow logs и change window без noisy-neighbor границы.
Для GPU inference ценность здесь не в обещании «меньше latency». Она в воспроизводимой границе: известный dataplane, понятный owner, ограниченный blast radius и rollback. Параллельно проверьте, что планирование GPU-нагрузки не маскирует очередь accelerator-а под сетевую деградацию.
Сравнивайте варианты по пяти вопросам: кто управляет CNI и обновлениями, где завершается egress, как связать flow с workload identity, кто меняет firewall, можно ли повторить canary и rollback. Только после этого VPS, dedicated node pool или отдельный gateway становятся инженерным решением, а не дорогой попыткой угадать причину.
Вывод: policy должна доказывать границу, а не просто существовать
Kubernetes NetworkPolicy для LLM inference работает, когда превращается в проверяемый сетевой контракт. Начните с карты зависимостей и canary, докажите CNI enforcement, введите default-deny, затем верните DNS, gateway ingress и обязательный egress по одному. Metadata endpoint, соседний namespace и случайный интернет держите как постоянные negative controls.
Главная практическая мысль проста: allow-list без runtime evidence быстро устаревает, а один широкий allow складывается со всеми остальными политиками. Сопоставляйте verdict dataplane, фактический peer и outcome приложения; для внешних FQDN заранее выберите owner — egress proxy, DNS-aware CNI или контролируемый network edge.
Возьмите один non-critical inference workload и пройдите checklist canary-rollout до production. Если текущая платформа не даёт наблюдать путь, фиксировать версии и безопасно откатывать изменения, это конкретное основание обсудить выделенную инфраструктуру King Servers — с понятными требованиями, а не с надеждой, что перенос сам исправит policy.