Оглавление
- Когда DNS действительно мешает LLM inference
- Как меняется DNS path после NodeLocal DNSCache
- Снимите baseline из effective namespace
- Три evidence gate: DNS-ответ, peer и результат приложения
- Метрики CoreDNS и node-local-dns без ложных выводов
- Ресурсный бюджет локального кэша
- Canary rollout без одновременной смены пяти переменных
- Failure drills и симметричный rollback
- Что NodeLocal DNSCache не исправляет
- Когда достаточно CoreDNS, а когда нужен выделенный node pool
- Короткий operational runbook
- Итог: локальный DNS-кэш полезен после доказательства пути
LLM API иногда «замирает» до первого токена, хотя GPU свободен и очередь пуста. На одном Kubernetes-узле всё работает, на другом появляются DNS timeout и SERVFAIL, а средняя latency CoreDNS выглядит прилично. В такой ситуации NodeLocal DNSCache может убрать лишний межузловой путь и разгрузить conntrack, но только если проблема действительно находится в DNS-плоскости. Ниже — production-runbook, который отделяет ответ resolver от выбранного endpoint и реального результата приложения.
Готовы перейти на современную серверную инфраструктуру?
В King Servers мы предлагаем серверы как на AMD EPYC, так и на Intel Xeon, с гибкими конфигурациями под любые задачи — от виртуализации и веб-хостинга до S3-хранилищ и кластеров хранения данных.
- S3-совместимое хранилище для резервных копий
- Панель управления, API, масштабируемость
- Поддержку 24/7 и помощь в выборе конфигурации
Результат регистрации
...
Создайте аккаунт
Быстрая регистрация для доступа к инфраструктуре
Когда DNS действительно мешает LLM inference
Пользователь видит знакомую картину: чат открывается быстро, но первый токен иногда приходит через несколько секунд, а часть запросов завершается ошибкой разрешения имени. GPU в это время не загружен, очередь inference короткая, gateway не упирается в CPU. Легко решить, что «тормозит CoreDNS», добавить реплики и на этом закончить расследование. Проблема в том, что такой диагноз пока ничего не доказывает.
Быстрый verdict: NodeLocal DNSCache стоит тестировать, если задержка или потери появляются между Pod и кластерным DNS, зависят от узла, сопровождаются UDP timeout, conntrack pressure или высокой долей повторяющихся запросов. Если имя разрешается стабильно, а задержка возникает после установления соединения, локальный кэш не исправит очередь модели, перегруженный gateway или медленный upstream.
Для LLM-сервиса это различие особенно важно. Один DNS lookup может предшествовать долгому SSE-сеансу, а клиентский pool способен переиспользовать соединение часами. Поэтому падение среднего времени DNS не гарантирует улучшение TTFT. Мы будем разделять три evidence gate: ответ resolver, фактически выбранный remote peer на новом соединении и результат приложения. Такой подход продолжает практику из runbook по DNS failover для LLM API, но здесь зона ответственности иная: путь внутри Kubernetes-узла, а не смена внешнего адреса.
Как меняется DNS path после NodeLocal DNSCache
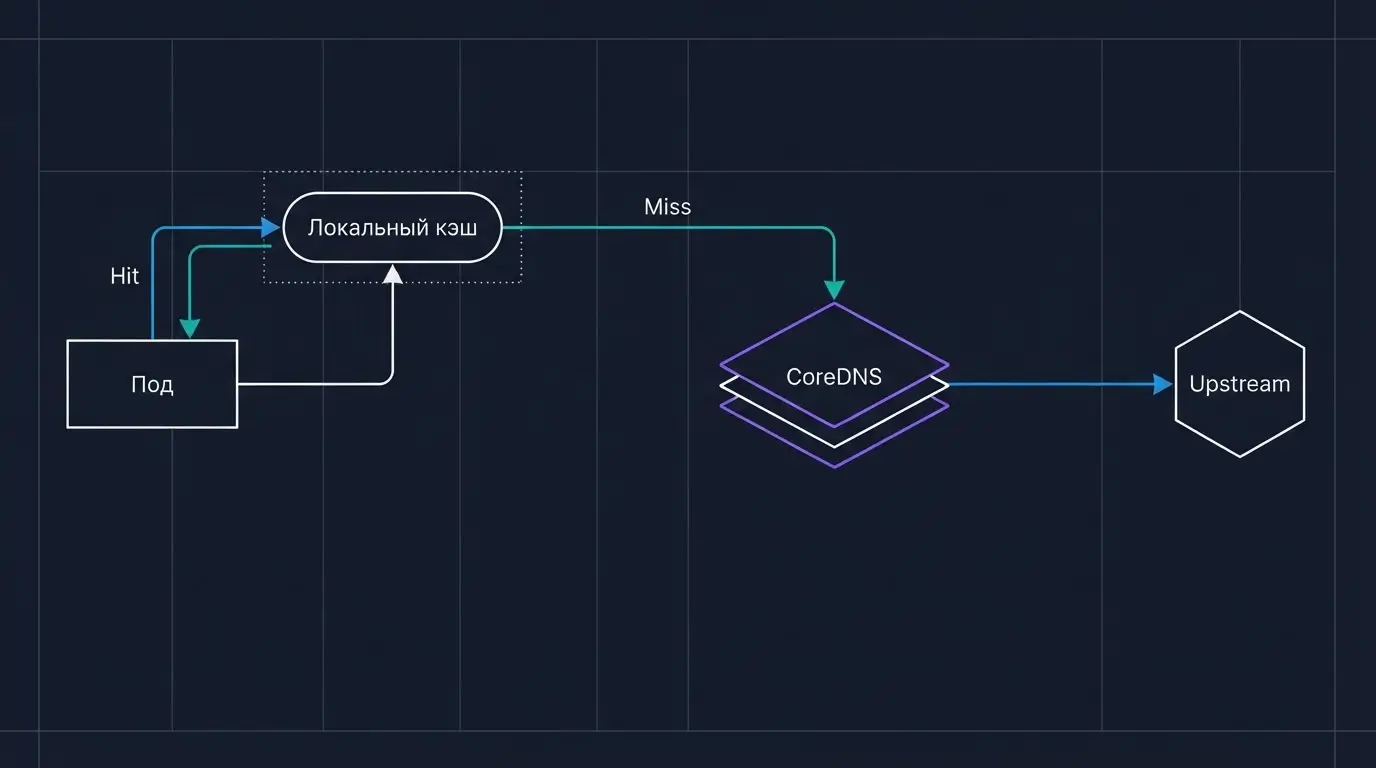
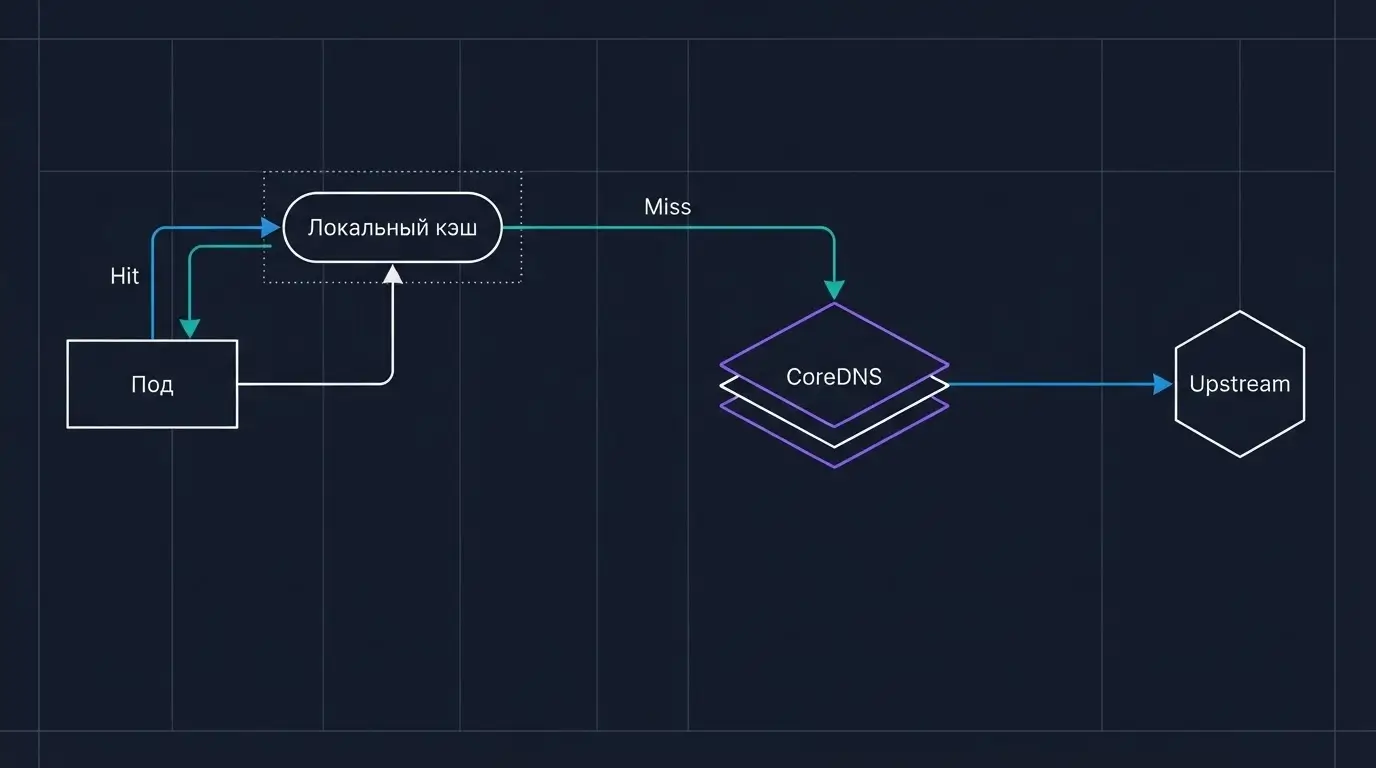
В обычной схеме Pod с политикой ClusterFirst отправляет запрос на ClusterIP сервиса kube-dns. kube-proxy или альтернативный dataplane выбирает endpoint CoreDNS; запрос может уйти на другой узел и пройти DNAT и conntrack. Официальная документация Kubernetes описывает NodeLocal DNSCache как DaemonSet: локальный агент слушает адрес на каждом узле, отвечает из кэша, а cache miss пересылает CoreDNS.
В режиме iptables агент способен слушать и service IP CoreDNS, и выделенный node-local address. В IPVS service IP уже занят интерфейсом IPVS, поэтому локальный агент слушает только node-local address, а kubelet должен выдавать этот адрес Pod через --cluster-dns. Это не косметическая деталь. Конфигурация, скопированная из другого режима kube-proxy, может дать частично рабочий кластер: одни Pod смотрят в локальный адрес, другие продолжают ходить в service IP.
Локальный hop убирает часть DNAT и UDP conntrack с горячего пути. Cache miss к CoreDNS можно передавать по TCP; запись conntrack тогда удаляется при закрытии соединения, а не ждёт UDP timeout. Но authoritative owner записей остаётся прежним: NodeLocal DNSCache не создаёт Service records и не заменяет plugin kubernetes. Он ускоряет и делает наблюдаемее доставку ответа, который сформировал CoreDNS.
Снимите baseline из effective namespace
Диагностика должна начинаться не на ноутбуке администратора и не на control-plane node, а внутри Pod того же workload, на том же node pool и с той же DNS policy. Иначе вы тестируете другой resolv.conf, другие search domains и часто совсем другой resolver. Для canary удобно создать технический Pod рядом с inference workload либо выполнить read-only команды в существующем диагностическом sidecar.
Сначала зафиксируйте nameserver, search и options. Значение ndots:5 означает, что короткое или внешнее имя может породить несколько запросов с search suffix до абсолютного lookup. Это не ошибка само по себе, но при большом QPS лишние запросы заметно нагружают кэш и upstream. Не меняйте ndots глобально в рамках первого эксперимента: иначе canary одновременно проверит две гипотезы.
Затем проверьте полное имя ClusterIP Service, headless Service и один внешний домен, который реально использует приложение. Для headless Service ответ содержит адреса Pod, и кэширование влияет на скорость lookup, но не гарантирует, что клиент выберет живой или свободный endpoint. Сохраните вывод вместе с именем узла и временем теста. Один успешный nslookup подтверждает только моментальный ответ, а не tail latency под рабочей нагрузкой.
kubectl get pod -n inference -o wide
kubectl exec -n inference deploy/llm-gateway -- cat /etc/resolv.conf
kubectl exec -n inference deploy/llm-gateway -- nslookup llm-backend.inference.svc.cluster.local
kubectl get endpointslice -n kube-system -l kubernetes.io/service-name=kube-dnsЕсли Service не разрешается, пройдите официальный чек-лист отладки DNS: health Pod CoreDNS, Service kube-dns, EndpointSlice, логи и фактический resolv.conf. NodeLocal DNSCache нельзя использовать как ширму поверх отсутствующих endpoints или forwarding loop.
Три evidence gate: DNS-ответ, peer и результат приложения
Первый gate отвечает на узкий вопрос: resolver вернул корректный набор адресов за приемлемое для вашего SLO время? Измеряйте не только среднее, а распределение и RCODE. Отдельно смотрите cache hit и miss: быстрый hit при медленном miss указывает на upstream path, а одинаково медленные hit и miss заставляют исследовать локальный агент, CPU throttling или packet path на узле.
Второй gate проверяет, куда действительно подключилось приложение. DNS-ответ с тремя адресами ещё не говорит, какой peer выбрал runtime, не остался ли старый socket в pool и не сработал ли fallback. Для теста создавайте fresh connections и фиксируйте remote address на стороне клиента либо gateway. Это особенно важно для gRPC и HTTP keepalive: повторно используемое соединение может полностью скрыть изменение DNS path.
Третий gate — outcome LLM API: доля успешных новых запросов, TTFT, обрывы до первого токена и после начала streaming, а также код ошибки, видимый клиенту. Улучшение coredns_dns_request_duration_seconds без сдвига application SLO честно называйте улучшением DNS-плоскости, а не «ускорением модели». Проверяли ли вы новый socket, или красивый график получился на старом connection pool?
Метрики CoreDNS и node-local-dns без ложных выводов
NodeLocal DNSCache запускает CoreDNS в cache mode, поэтому на каждом узле доступны метрики соответствующих plugins. Базовые сигналы: число запросов, latency, RCODE, cache hits, occupancy/evictions, ошибки forward и отказы из-за max_concurrent. В актуальном plugin prometheus есть счётчики запросов и histogram времени обработки; plugin cache экспортирует entries и hits. Метрика misses помечена deprecated: промахи следует выводить из requests и hits, учитывая зону и server block.
Не смешивайте node-local agent и центральный CoreDNS в одной серии без labels. Рост запросов на одном узле может быть нормальным следствием batch-пода, который часто резолвит внешние endpoints. А одинаковый всплеск на всех узлах чаще говорит о deploy, client retry или коротком TTL. Сопоставляйте DNS QPS с рестартами приложения, количеством новых соединений и change events.
У forward plugin отдельно полезны latency к upstream, health-check failures, connection-cache hits и max_concurrent_rejects. Если все upstream unhealthy, resolver может продолжить попытки по своей политике; быстрый локальный cache hit не отменяет риск, когда запись истечёт. Поэтому alert должен различать «кэш сейчас обслуживает трафик» и «upstream способен обслужить miss».
sum by (pod, server, zone, rcode) (rate(coredns_dns_responses_total[5m]))
histogram_quantile(0.99,
  sum by (le, pod, server, zone) (rate(coredns_dns_request_duration_seconds_bucket[5m]))
)
sum by (pod, server, type, zones) (rate(coredns_cache_hits_total[5m]))Не копируйте имя метрики вслепую между версиями: сначала откройте endpoint /metrics конкретного образа и проверьте labels. Версию фиксируйте в change record вместе с digest контейнера.
Ресурсный бюджет локального кэша
DaemonSet превращает DNS capacity в распределённый ресурс: у каждого узла свой процесс, кэш и пределы. Это снижает зависимость от межузлового пути, но добавляет новый failure domain. Официальная документация предупреждает, что память зависит от паттерна запросов и concurrent queries; полностью заполненный cache default capacity порядка 10 000 entries использует примерно 30 МБ на server block. Это ориентир документации, а не готовый limit для вашего кластера.
Практический бюджет строят по пику RSS, CPU throttling, cache entries, evictions и concurrent upstream requests на реальном node pool. Запустите без слишком тесного memory limit, соберите peak под рабочим профилем, затем добавьте запас и проверьте худший случай: cold cache после restart плюс массовый rollout приложения. VPA в recommender mode может дать дополнительную точку, но решение остаётся за владельцем платформы.
OOMKilled здесь опаснее обычного restart. Локальный агент на старте программирует packet-filtering rules; если процесс погибнет, правила могут некоторое время направлять запросы к нездоровому локальному endpoint. Результат выглядит как «CoreDNS иногда не отвечает», хотя центральные реплики полностью здоровы. Поэтому readiness Pod недостаточно: нужен synthetic lookup с каждого GPU/node pool и отдельный alert на restart loop.
Canary rollout без одновременной смены пяти переменных
Безопасный rollout начинается с одного node pool, где есть репрезентативная, но не критичная inference-нагрузка. Оставьте соседний pool на обычном ClusterIP DNS как negative control. Не меняйте одновременно ndots, TTL, число CoreDNS replicas, CNI и application retry: иначе даже при успехе будет непонятно, какая переменная сработала.
В iptables и IPVS режимах различается привязка адресов, поэтому перед применением manifest зафиксируйте kube-proxy mode. Затем проверьте DaemonSet, адрес listener, ConfigMap, фактический nameserver в новых Pod и доступность health/metrics. Старые Pod не всегда отражают изменения kubelet DNS config, поэтому rollout должен явно включать пересоздание только canary workload, а не всего GPU-кластера.
Нагрузочный профиль обязан содержать cache hits, cache misses, NXDOMAIN и внешний lookup. Для LLM outcome используйте те же prompts или replay-профиль, одинаковую concurrency и fresh connection policy на baseline и canary. Сравнивайте не абсолютные цифры разных часов, а параллельные окна. Если canary улучшил DNS p99, но увеличил SERVFAIL или рестарты агента, rollout останавливают.
kubectl -n kube-system get daemonset node-local-dns -o wide
kubectl -n kube-system get pods -l k8s-app=node-local-dns -o wide
kubectl -n kube-system get configmap node-local-dns -o yaml
kubectl exec -n inference deploy/llm-gateway-canary -- cat /etc/resolv.confДля стандартного manifest используйте текущий образец из документации вашей версии Kubernetes и подставляйте cluster domain, service IP и выбранный local address. Не вставляйте адрес из чужого кластера. Выделенный local address должен гарантированно не конфликтовать с существующими интерфейсами и маршрутами.
Failure drills и симметричный rollback
Первый drill — cache miss при недоступном upstream CoreDNS. Он показывает, переживает ли система краткий сбой на уже закэшированных именах и как ведёт себя после истечения TTL. Второй — restart одного node-local-dns Pod под запросами. Третий — потеря UDP или TCP на выбранном участке. Их нельзя заменять одним удалением Pod: разные сбои затрагивают разные слои.
Отдельно проверьте negative caching. NXDOMAIN, сохранённый локально, снижает повторный QPS, но способен продлить симптом после создания ранее отсутствовавшего Service до истечения TTL. Это не повод отключать negative cache автоматически; это повод включить в runbook точную проверку имени, namespace и времени изменения. Для внешних API смотрите TTL authoritative ответа и поведение application resolver.
Rollback должен вернуть исходный DNS path, а не только удалить DaemonSet. В IPVS-схеме потребуется восстановить kubelet --cluster-dns и пересоздать canary Pod, чтобы его resolv.conf снова указывал на service IP. После rollback повторите те же три gate: resolver, fresh peer и LLM outcome. Если проверка заканчивается фразой «Pod удалили, значит всё вернулось», она неполна.
Что NodeLocal DNSCache не исправляет
Локальный кэш не исправляет неверный Service selector, пустой EndpointSlice, блокирующую NetworkPolicy или ошибку приложения. Если стандартный Kubernetes NetworkPolicy разрешает DNS только центральным Pod CoreDNS, после смены пути может потребоваться проверить правила для local agent и upstream. Но API acceptance политики ещё не доказывает enforcement конкретным CNI. Подробный порядок проверки control plane, peer и outcome разобран в материале про default-deny для LLM inference.
Он также не решает IP churn внешнего AI API на уровне политики доступа. Если egress фильтруется по FQDN, authoritative owner может находиться в CNI, а его DNS cache живёт отдельно от application resolver и NodeLocal DNSCache. Здесь полезно сверить границы с runbook по Cilium FQDN egress: ответ DNS, policy cache и уже открытое соединение — разные состояния.
Наконец, кэш не создаёт capacity для GPU и не ускоряет generation после первого токена. В архитектуре Kubernetes для AI inference DNS — лишь bootstrap-path к gateway и backend. Очередь KServe, placement GPU, KV cache и autoscaling живут дальше. Если bottleneck там, более быстрый lookup улучшит вспомогательную метрику, но пользователь продолжит ждать.
Когда достаточно CoreDNS, а когда нужен выделенный node pool
Сравнивая варианты, добавьте стоимость operational ownership. Центральный CoreDNS требует capacity planning и anti-affinity; NodeLocal DNSCache добавляет DaemonSet, per-node alerts, управление Corefile и проверку после обновлений kubelet/CNI. Выделенный pool добавляет планирование узлов и резерв, зато уменьшает неоднородность kernel и сетевого dataplane. Решение следует принимать по тому, какой слой команда реально умеет наблюдать и откатывать.
Полезный disqualifier для закупки звучит так: если baseline не показывает node-dependent DNS loss или latency, новый сервер не является лекарством. Сначала устраните лишние lookup, неверный FQDN, search expansion или connection churn. И наоборот, когда сбой связан с общим noisy-neighbor path и требуется контролируемый canary на одинаковых узлах, выделенный контур превращает эксперимент из догадки в воспроизводимую операцию.
Procurement default здесь консервативный: не меняйте платформу, пока не доказан bottleneck на DNS path. Если CoreDNS перегружен из-за малого числа replicas или неверных requests, сначала восстановите его health и capacity. Если проблема проявляется только на узлах с высоким DNS QPS, conntrack pressure или межузловой задержкой, NodeLocal DNSCache даёт локальную границу контроля и per-node telemetry.
Выделенный node pool полезен, когда AI workload требует предсказуемого change window, одинаковой версии kernel/CNI/kubelet и изоляции failure drills. Он упрощает canary и rollback, но не исправляет forwarding loop, неправильный search suffix или агрессивный client retry. Dedicated infrastructure следует продавать не как обещание меньшей TTFT, а как воспроизводимый network and compute baseline, где команда управляет версией, ресурсным бюджетом и окном изменений.
Для небольшого private AI API на нескольких узлах отдельный pool может быть лишним. Сначала посчитайте стоимость владения DaemonSet, alerts и регулярных drills. Если команда не готова сопровождать дополнительный resolver на каждом узле, разумнее настроить центральный CoreDNS и сократить бессмысленные lookup в приложении. Архитектурный контекст приватного gateway и квот есть в руководстве по Private AI API.
Короткий operational runbook
В инциденте порядок важнее количества команд. Сначала локализуйте blast radius по узлам и namespace. Затем снимите resolv.conf, RCODE и latency из effective Pod. Сопоставьте результат с node-local metrics и центральным CoreDNS. После этого создайте fresh connection и зафиксируйте peer. Лишь затем открывайте графики TTFT и inference queue.
Если cache hits быстрые, а misses медленные, исследуйте forward path и upstream health. Если оба типа медленные только на одном узле, смотрите CPU throttling, restart, listener и packet rules локального агента. Если DNS стабилен, но приложение ошибается, передайте инцидент владельцу следующего слоя с уже собранным evidence, а не с общим ярлыком «сеть».
Любое изменение проходит через canary, negative control и симметричный rollback. Не удаляйте baseline до завершения окна наблюдения. Для streaming учитывайте, что старые соединения переживут изменение resolver; результат на них нельзя смешивать с новым connection cohort. Такой runbook короче импровизации и лучше защищает от ложного улучшения.
Итог: локальный DNS-кэш полезен после доказательства пути
NodeLocal DNSCache — зрелый механизм Kubernetes, а не универсальный ускоритель LLM. Он приносит пользу там, где Pod действительно страдает от межузлового DNS path, UDP timeout, conntrack pressure или повторяющихся lookup. Правильная проверка отделяет DNS response от выбранного peer и от результата приложения; только такая цепочка позволяет честно связать изменение с пользовательским эффектом.
Начните с baseline на одном node pool, сохраните обычный CoreDNS path как negative control и измеряйте hit, miss, RCODE, fresh connections и TTFT раздельно. Заранее задайте resource budget, failure drills и полный rollback, включая kubelet DNS config. Если bottleneck подтвердится и команде нужен управляемый Kubernetes-контур, инфраструктура King Servers может дать выделенные узлы и предсказуемое окно изменений; но конфигурацию resolver, policy и приложения всё равно придётся доказать вашими probes.
Практический следующий шаг простой: выберите один canary pool, снимите десятиминутный baseline DNS и application outcome, а затем прогоните тот же профиль с локальным кэшем. Один аккуратный эксперимент даст больше, чем неделя споров по средним графикам.