Оглавление
Готовы перейти на современную серверную инфраструктуру?
В King Servers мы предлагаем серверы как на AMD EPYC, так и на Intel Xeon, с гибкими конфигурациями под любые задачи — от виртуализации и веб-хостинга до S3-хранилищ и кластеров хранения данных.
- S3-совместимое хранилище для резервных копий
- Панель управления, API, масштабируемость
- Поддержку 24/7 и помощь в выборе конфигурации
Результат регистрации
...
Создайте аккаунт
Быстрая регистрация для доступа к инфраструктуре
Быстрый вердикт: когда виноват dual-stack
Первое практическое правило простое: не тюньте модель, batching и GPU, пока не сравнили один и тот же запрос по IPv4 и IPv6. Разница между curl -4 и curl -6 — не финальный диагноз, но сильный локализатор. Если DNS-ответ, TLS-настройки и payload одинаковы, а connect или time to first byte расходятся только по семье адресов, зона поиска сужается до resolver policy, source address selection, маршрута, ACL, ICMPv6 и конкретного edge.
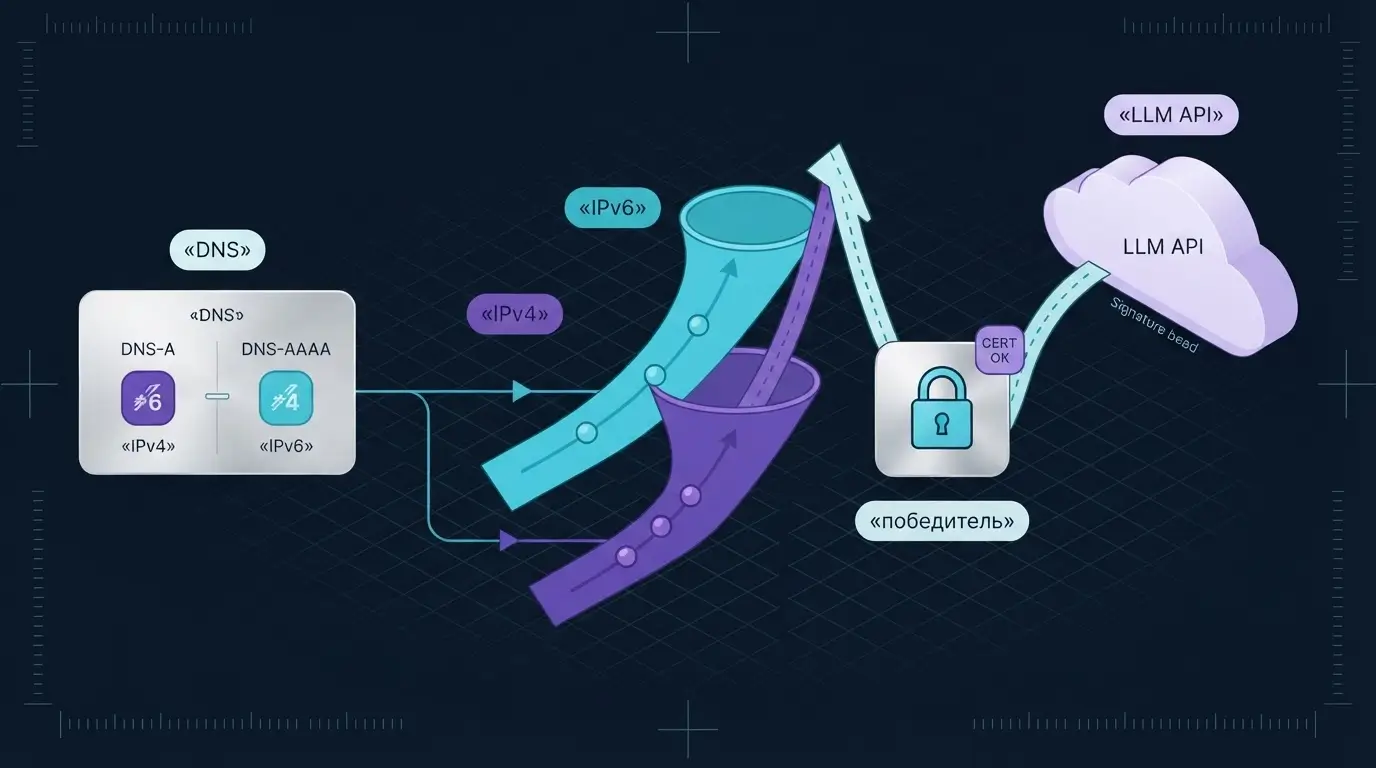
Happy Eyeballs делает пользовательский опыт лучше: клиент получает A и AAAA, формирует упорядоченный список адресов и запускает конкурирующие попытки с небольшим разносом. Победившее соединение остается, остальные отменяются. Поэтому общий request success может быть зеленым, хотя IPv6 неделями деградирует: IPv4 просто выигрывает гонку. Знакомая картина — synthetic check проходит, но мобильные клиенты или отдельный runtime дают длинный хвост latency из-за другой реализации алгоритма и иного пула соединений.
Квалифицирующий симптом для этого runbook: dual-stack hostname, непостоянная задержка до TLS или первого байта, различие между принудительными семьями либо расхождение по клиентским сетям. Disqualifier тоже важен: если -4 и -6 одинаково быстры на connect, но оба ждут первый токен, переходите к gateway и inference. Здесь поможет отдельный разбор L4/L7 proxy и SSE streaming, а не смена IP-стека.
- Сеть подозреваем первой, когда расходятся connect/TLS и выбранная семья.
- Приложение подозреваем первой, когда peer стабилен, а растут TTFT, очередь или partial responses.
- DNS failover не смешиваем с Happy Eyeballs: первый меняет набор адресов во времени, второй выбирает между доступными кандидатами в рамках соединения.
Как Happy Eyeballs выбирает путь и что скрывает
RFC 8305 описывает Happy Eyeballs v2 как последовательность из четырех фаз: асинхронное разрешение имени, сортировка адресов, запуск попыток подключения и отмена проигравших после установления одного соединения. Документ заменил исходный RFC 6555. Важно читать эту схему как клиентский механизм устойчивости, а не как доказательство здоровья IPv6.
Результат зависит не только от сети. Runtime решает, когда отправлять A и AAAA, как упорядочить кандидатов, какой интервал выдержать и можно ли переиспользовать уже открытое соединение. Например, актуальная документация curl описывает --happy-eyeballs-timeout-ms и текущий default libcurl 200 мс. Это не универсальная константа для всех приложений: браузер, Java, Go, Python-библиотека и service mesh могут вести себя иначе.
Мини-кейс. IPv6 SYN уходит в black hole, явного reject нет. Клиент ждет свой fallback delay, затем открывает IPv4 и успешно получает ответ. В метрике «request success» все хорошо, но к каждому новому connection добавляется задержка. Если keepalive живет долго, дефект проявляется всплесками после deploy, scale-out или ротации edge — именно тогда создаются свежие соединения.
Поэтому соберите три раздельные метрики: какую семью пробовали первой, какой remote peer действительно победил и что увидел пользователь. Без этой тройки спор «IPv6 или модель» превращается в угадайку. Общий обзор перехода на IPv6 объясняет базовые причины внедрения; здесь фокус уже: operational path selection для AI API.
Три evidence gate: DNS-кандидаты, фактический peer, outcome
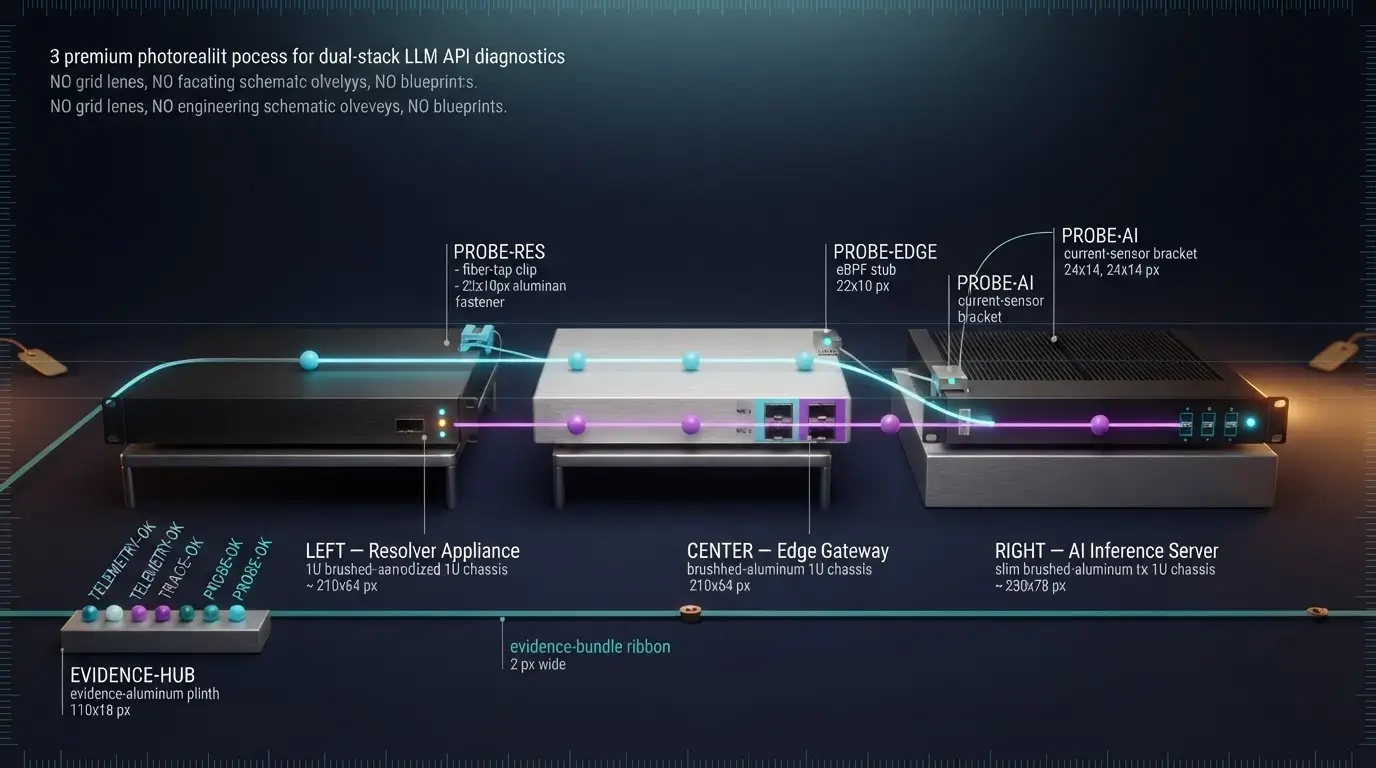
Gate 1 — resolver evidence. Зафиксируйте A и AAAA с того же namespace, контейнера или node, где работает клиент. Ответ локального ноутбука не заменяет ответ pod resolver. Сохраняйте TTL и порядок получения ответов, но не делайте вывод о соединении только по DNS. AAAA в ответе означает «кандидат существует», а не «трафик пошел по IPv6».
Gate 2 — selected peer и path. Нужны remote IP, address family, interface/source address и точка TLS termination. У HTTP gateway может быть два плеча: client → edge и edge → inference. Первое способно работать по IPv6, второе по IPv4; агрегированная метрика скроет границу. Для каждого плеча назначьте owner: клиентская команда, platform, network или vendor edge.
Gate 3 — application outcome. Измерьте DNS, connect, TLS, time to first byte, time to first token, полную длительность и тип завершения stream. Первый байт HTTP-заголовков не равен первому токену, а успешный status не исключает обрыв после начала SSE. Сравнивайте одинаковый короткий запрос без повторов: retries превращают один сетевой сбой в несколько попыток и размывают картину.
Рабочий контрфакт выглядит так: принудительный IPv4 и IPv6 получают один DNS snapshot и одинаковый payload, но создают новые соединения. Если расходится connect — исследуем путь. Если connect одинаков, а расходится TLS — termination и crypto policy. Если оба этапа одинаковы, а TTFT разный, проверяем routing на втором плече, очередь gateway и backend selection. Этот порядок продолжает подход из материала про DNS failover для LLM API, но не повторяет его: здесь адреса стабильны, меняется победитель гонки.
- Положительный gate: выбранный peer и outcome совпадают с ожиданием.
- Отрицательный контроль: принудительная другая семья дает предсказуемо иной peer.
- Stop condition: нет возможности увидеть remote IP — сначала добавьте telemetry, затем меняйте policy.
Базовая диагностика на Linux без изменения production
Начните из effective namespace клиента. Для systemd service это может быть host, для pod — отдельный network namespace, для sidecar — еще одно transport-плечо. Один и тот же hostname с jump host и из приложения способен разрешаться через разные resolver и выходить через разные egress gateway.
Снимите DNS snapshot и серию чистых запросов. В команде ниже нет «магических» порогов: сравнивайте собственный baseline. Поля remote_ip, time_namelookup, time_connect, time_appconnect и time_starttransfer позволяют разделить этапы. Не используйте production API key в shell history; для проверки достаточно безопасного health endpoint или тестового tenant.
HOST=api.example.net
dig +short A "$HOST"
dig +short AAAA "$HOST"

for family in -4 -6; do
  curl "$family" --connect-timeout 5 --max-time 20     -sS -o /dev/null     -w 'peer=%{remote_ip} dns=%{time_namelookup} connect=%{time_connect} tls=%{time_appconnect} ttfb=%{time_starttransfer} code=%{http_code}\n'     "https://$HOST/health"
doneПовторите серию с новым процессом или отключенным reuse там, где это допустимо: иначе вы измерите старое keepalive-соединение, а не выбор пути. Затем выполните обычный dual-stack запрос и сопоставьте его remote peer с принудительными тестами. Полезно временно увеличить детализацию client logs, но не логировать Authorization и пользовательские prompts.
Если -6 отвечает явным Network unreachable, зона поиска близка: адрес, route или policy. Если попытка молчит до timeout, проверьте firewall drop, недоступный next hop и ICMPv6. Если connect быстр, а TLS медленный, сравните SNI, certificate chain и termination point. А если первый токен тормозит при обеих семьях, не обвиняйте Happy Eyeballs: сеть уже прошла свой gate.
Где ломается IPv6-путь: route, NDP, firewall и PMTU
IPv6 — не «IPv4 с длинным адресом». На локальном сегменте Neighbor Discovery заменяет ARP, router advertisements влияют на маршруты и source address, а ICMPv6 выполняет критические функции. Фильтр «запретить весь ICMP» особенно опасен: он может сломать диагностику и Path MTU Discovery, оставив мелкие пакеты рабочими, а крупные TLS records или streaming traffic — зависающими.
Проверьте адреса и route в effective namespace, затем путь и PMTU. tracepath умеет выбирать -4/-6 и обнаруживать MTU вдоль пути без root. Однако отсутствие ответа от промежуточного hop не всегда означает разрыв: фильтрация diagnostic traffic возможна. Главный критерий — конечный application outcome плюс packet evidence на контролируемых точках.
ip -6 addr show
ip -6 route show
ip -6 route get 2001:db8::10
ip -6 neigh show

tracepath -6 api.example.net
ping -6 -c 3 api.example.netНа edge сравните счетчики firewall отдельно для IPv4 и IPv6. RFC 9099 подчеркивает operational reality dual-stack: вы управляете двумя стеками и должны поддерживать согласованные security policy. Типичная ловушка — разрешить TCP/443 в IPv4 ACL, забыть эквивалентное правило для IPv6 и получить silent drop вместо быстрого reject.
Для packet capture задайте узкое окно, host и порт. Увидели SYN/SYN-ACK по IPv6 — transport handshake прошел. SYN без ответа локализует дефект дальше по пути; отсутствие исходящего SYN указывает на resolver/address selection/runtime. TLS ClientHello без ServerHello переносит расследование к termination. Не храните payload: для этой задачи достаточно заголовков и timing.
sudo tcpdump -ni any 'host 2001:db8::10 and tcp port 443'
ss -tnp '( dport = :443 )'
nstat -az | grep -E 'Ip6|Icmp6|Tcp'
Dual-stack в Kubernetes: проверяем не YAML, а effective path
Kubernetes поддерживает dual-stack networking как stable feature с версии 1.23; актуальная официальная документация описывает SingleStack, PreferDualStack и RequireDualStack. Но поле в Service не гарантирует end-to-end готовность. CNI, node routes, cloud или bare-metal load balancer, firewall, egress и upstream DNS должны поддерживать выбранную семью.
Сначала прочитайте живой объект, а не manifest в репозитории. Порядок ipFamilies влияет на primary family Service, но клиентский runtime все равно может разрешать внешний hostname и выбирать адрес самостоятельно. Для egress к стороннему LLM API особенно важны node/pod source address и фактический gateway. Если используется FQDN policy, отделяйте этот слой от выбора соединения; подробнее — в runbook про Cilium FQDN egress, DNS cache и IP churn.
kubectl get svc llm-gateway -o jsonpath='{.spec.ipFamilyPolicy}{"\n"}{.spec.ipFamilies}{"\n"}{.spec.clusterIPs}{"\n"}'
kubectl get pod -o wide
kubectl exec deploy/llm-client -- sh -c 'getent ahosts api.example.net'
kubectl exec deploy/llm-client -- sh -c 'curl -4 -sS -o /dev/null https://api.example.net/health'
kubectl exec deploy/llm-client -- sh -c 'curl -6 -sS -o /dev/null https://api.example.net/health'Canary pod должен иметь те же sidecar, DNS config, NetworkPolicy и resource limits, что production, иначе сравниваются разные системы. Проверьте оба направления: client → gateway и gateway → backend. В service mesh ingress может принять IPv6, а upstream cluster остаться IPv4-only — это нормальная архитектура, если она документирована и наблюдаема.
Не переводите Service сразу в RequireDualStack ради эксперимента. Начните с отдельного canary hostname или небольшого client pool. Stop condition — рост connect errors, несогласованный peer, пропажа telemetry или невозможность быстрого возврата. Dual-stack rollout ценен только тогда, когда отказ одной семьи не остается невидимым.
Runtime, DNS-кэш и connection pools: почему тест curl не равен приложению
curl — хороший диагностический скальпель, но production client живет дольше одного процесса. Он может кэшировать DNS, держать HTTP/2 connection, использовать proxy environment, собственный resolver или библиотеку, которая иначе реализует fallback. Поэтому положительный curl gate доказывает доступность пути из данного namespace, но не доказывает поведение runtime.
Составьте owner map: кто разрешает имя, кто сортирует адреса, где хранится DNS cache, кто создает connection pool и какой слой выполняет retry. Для каждого параметра запишите effective value из процесса или конфигурации, а не ожидание из документации. После deploy старые соединения могут продолжать идти к прежнему peer; тестируйте новые connection establishment отдельно от steady-state reuse.
Мини-кейс: приложение на Java держит несколько HTTP/2 connections, а synthetic curl запускается каждую минуту. После частичной деградации IPv6 curl быстро уходит на IPv4 и зеленеет. Java-пул продолжает переиспользовать ранее установленный IPv6 connection, где растут retransmits и stalls. Оба наблюдения честные, но отвечают на разные вопросы. Нужно связать connection id, remote peer и request outcome.
Не начинайте с уменьшения fallback delay. Маленький интервал может скрыть дефект еще лучше и увеличить число параллельных попыток. Сначала почините path или осознанно выключите неготовую семью на контролируемой границе. Таймаут — policy, а не лекарство. Аналогично, retries допустимы только для безопасных операций: повтор streaming request после partial response может задвоить работу и расходы.
- Соберите runtime/version и сетевую библиотеку.
- Проверьте proxy variables и sidecar interception.
- Разделите fresh connect и reused connection.
- Логируйте remote family без секретов и payload.
- Сопоставляйте client result с gateway request id.
Canary, rollout и rollback без самообмана
Надежный rollout начинается не с переключателя IPv6, а с baseline. Зафиксируйте распределение connect, TLS, TTFT, errors и выбранных peer для стабильного IPv4-пути. Затем создайте изолированный canary с тем же workload, версией клиента и endpoint semantics. Меняется одна переменная — доступность или приоритет IPv6.
Подавайте на canary повторяемый безопасный трафик. Не выдумывайте «нормальную» задержку: сравнивайте с собственным SLO и baseline. Сегментируйте результаты по node, zone, ISP/client network и runtime. Happy Eyeballs должен оставаться страховкой, но метрика fallback rate обязана быть видна. Рост IPv4 winners после включения IPv6 — не успех dual-stack, а сигнал, что новый путь проигрывает.
Failure drill нужен до расширения. Заблокируйте IPv6 только в canary-контуре и убедитесь, что клиент быстро и безопасно выбирает IPv4. Затем верните policy и проверьте, что новые соединения снова используют ожидаемый peer. Не ломайте production для теста и не вмешивайтесь в чужие сети. Для PMTU и VPN-сценариев полезна отдельная методика из статьи про WireGuard MTU и PMTUD.
Rollback должен быть симметричен rollout: тот же traffic slice, те же метрики, тот же наблюдаемый remote peer. Если после отката показатели не возвращаются, у вас остались connection pools, DNS cache или config drift. В таком случае rollout нельзя считать доказанным, даже если средняя latency стала ниже.
- Расширяем, когда обе семьи проходят path gate, policy симметрична, fallback rate объясним, application SLO сохранен.
- Останавливаем, когда есть silent drop, неизвестный peer, потеря telemetry или рост partial responses.
- Откатываем, когда canary не возвращается к baseline тем же измерением.
Когда отдельный VPS или dedicated edge действительно помогает
Коммерческий вывод здесь не «IPv6 требует новый сервер». По умолчанию инфраструктуру менять не нужно, пока не доказан bottleneck и его owner. Ошибочный AAAA, stale DNS, несимметричный ACL или connection reuse останутся ошибками и на более мощном железе. Это обязательный disqualifier.
Отдельный VPS или dedicated edge становится разумным, когда canary показал проблему на общей границе: вы не контролируете route policy, firewall lifecycle, версию proxy, telemetry или change window. Изолированный узел дает воспроизводимый network baseline, собственные IPv4/IPv6 policy, возможность packet capture, staged rollout и быстрый rollback. Ценность — в управляемости и ownership, а не в обещании меньшей latency.
Сравните три варианта. Оставить текущий shared edge — правильный default, если обе семьи проходят SLO и policy наблюдаема. Выделить VPS edge — полезно для небольшого controlled gateway, где важны отдельные ACL, адреса и быстрые изменения. Dedicated edge оправдан при высоком потоке, строгом change control, аппаратной сетевой политике или необходимости одинакового профиля между регионами. Managed load balancer остается хорошим выбором, когда provider прозрачно показывает health каждой семьи и поддерживает rollback.
Decision helper должен завершаться владельцем действия. Network team исправляет route/ACL; platform team — Service/CNI/egress; application team — resolver, pool и retry semantics; hosting provider — адресацию и edge path в своей зоне ответственности. Когда граница доказана, команда KingServers может помочь собрать отдельный VPS или dedicated baseline для canary, но acceptance criteria все равно задают ваши remote peer, fallback rate и application SLO.
Итоговый runbook: сначала докажите путь, потом меняйте policy
Happy Eyeballs — полезная защита пользователя, но плохой заменитель наблюдаемости. Он способен превратить сломанный IPv6 в «чуть медленный, зато успешный» запрос, поэтому обычный uptime не показывает реальное состояние dual-stack. Надежное расследование держится на трех доказательствах: какие A/AAAA получил клиент, какой peer и path действительно использован, что произошло с connect, TLS и первым токеном.
Начните с принудительных curl -4/curl -6 из effective namespace, затем подтвердите route, NDP, firewall и PMTU. После этого проверьте runtime: DNS cache, Happy Eyeballs policy, connection reuse и retries. В Kubernetes читайте live Service и проверяйте CNI, load balancer и egress end to end. Наконец, проведите canary с неизменным baseline и симметричным rollback.
Практический следующий шаг на сегодня: добавьте remote address family и peer в client или gateway telemetry, снимите десять безопасных fresh-connect проб по каждой семье и запишите owner каждого расхождения. Если обе семьи проходят SLO, ничего не усложняйте. Если одна системно проигрывает, у вас будет не ощущение, а конкретный участок пути, критерий исправления и понятный план отката.
Так dual-stack перестает быть фоновым источником случайности. Он становится двумя измеряемыми production-путями, каждый из которых можно тестировать, обслуживать и включать осознанно.