Оглавление
- SYN flood или обычная перегрузка: начните с симптома, а не с названия атаки
- Две очереди Linux TCP, которые нельзя смешивать
- Evidence bundle: что собрать до первого sysctl
- SYN cookies: аварийный fallback с ограниченной областью действия
- SYNPROXY в nftables: вынести проверку handshake на edge
- Backlog, cookies или SYNPROXY: выбирайте по owner проблемы
- Canary без самообмана: A/B/A на свежих соединениях
- Наблюдаемость: связать packets, kernel и первый токен
- Типичные ошибки, которые превращают защиту в новый инцидент
- Production checklist и граница инфраструктурного решения
- Итог: защищайте handshake, но измеряйте сервис
Готовы перейти на современную серверную инфраструктуру?
В King Servers мы предлагаем серверы как на AMD EPYC, так и на Intel Xeon, с гибкими конфигурациями под любые задачи — от виртуализации и веб-хостинга до S3-хранилищ и кластеров хранения данных.
- S3-совместимое хранилище для резервных копий
- Панель управления, API, масштабируемость
- Поддержку 24/7 и помощь в выборе конфигурации
Результат регистрации
...
Создайте аккаунт
Быстрая регистрация для доступа к инфраструктуре
SYN flood или обычная перегрузка: начните с симптома, а не с названия атаки
У LLM API gateway есть неприятный режим отказа: GPU заняты не полностью, процесс inference жив, health check зелёный, но новые клиенты внезапно получают timeout ещё до первого HTTP-запроса. На графике приложения при этом может не быть всплеска 5xx — TCP-соединение просто не дошло до accept(). Команда видит сообщения о possible SYN flooding и сразу включает всё, что звучит как защита. Это понятная реакция, но она легко маскирует настоящую причину.
Одинаковый пользовательский симптом дают как минимум четыре разных механизма: переполненный SYN backlog, медленный accept loop, исчерпанный conntrack, перегруженный сетевой CPU. Настоящий spoofed SYN flood — только один вариант. Поэтому рабочий verdict должен звучать не «нас атакуют», а точнее: «на таком-то listener растут half-open запросы, ядро отправляет cookies, а доля успешных fresh connections падает».
Для LLM-сервиса это особенно важно. Длинные streaming-соединения могут оставаться здоровыми, пока новые запросы уже не проходят handshake. Средняя загрузка GPU и latency существующих сессий создают false green. Проверять нужно новый connection path: клиент → edge → handshake → accept → TLS/HTTP → очередь модели → первый токен.
Граница безопасности проста: далее речь только о диагностике и защите собственной инфраструктуры. Генерировать атакующий трафик из интернета не требуется; достаточно контролируемого canary из разрешённой сети и сохранённого baseline.
Две очереди Linux TCP, которые нельзя смешивать
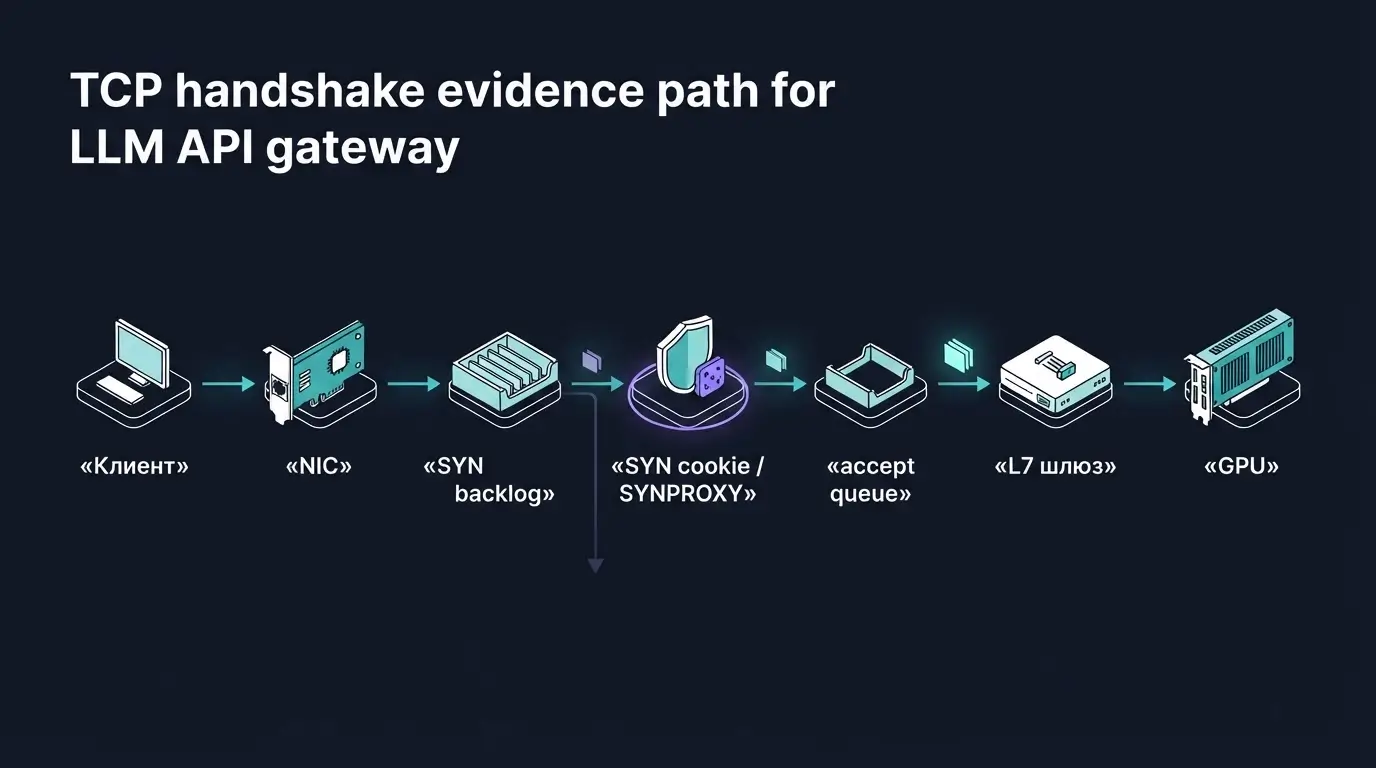
После входящего SYN ядро создаёт request socket и хранит незавершённый handshake в SYN backlog. Его верхняя граница связана с net.ipv4.tcp_max_syn_backlog и действует на listener. После финального ACK полностью установленное соединение попадает в accept queue и ждёт, пока процесс вызовет accept(). Аргумент listen(backlog) ограничивается net.core.somaxconn; в Linux 5.4 значение somaxconn по умолчанию увеличили с 128 до 4096, но приложение всё равно может запросить меньший backlog.
Разделение принципиально. Рост SYN_RECV при стабильной accept queue указывает на проблему handshake или входного потока. Рост ListenOverflows/ListenDrops при занятых workers больше похож на задержку userspace accept. Простое увеличение обоих лимитов меняет ёмкость буфера, но не ускоряет CPU, не чинит single listener и не освобождает conntrack.
Представьте турникет и зал ожидания. SYN backlog — люди, которые ещё подтверждают билет у турникета. Accept queue — уже проверенные посетители, которых не успевает забрать сотрудник. Расширить зал полезно при коротком всплеске, но бесполезно, если сотрудник остановился.
Официальные man-pages для listen(2) отдельно фиксируют эту семантику, а документация ядра по IP sysctl предупреждает: syncookies не предназначены для лечения легальной перегрузки.
Evidence bundle: что собрать до первого sysctl
До изменения параметров зафиксируйте одну и ту же временную точку на edge и в приложении. Минимальный bundle включает значения sysctl, состояние listener, количество SYN_RECV, дельты TcpExt counters, packet capture с небольшим snaplen и результат свежего клиентского запроса. Снимок нужен в baseline, во время симптома и после восстановления.
TcpExtSyncookiesSent показывает отправленные cookies, SyncookiesRecv — ответы клиентов на них, а SyncookiesFailed — невалидное декодирование MSS. Сами по себе cookies не доказывают атаку: они доказывают, что конкретный listener дошёл до fallback. ListenOverflows и ListenDrops относятся к проблемам при помещении установленного соединения в очередь; их нужно читать как дельту, а не как накопившееся за месяцы число.
Команда ниже ничего не меняет. Запускайте её в effective network namespace gateway: host, container или pod могут видеть разные counters. Если nftables/conntrack стоят на отдельном edge, снимайте evidence и там, и на backend.
date -Is
uname -r
sysctl net.ipv4.tcp_syncookies net.ipv4.tcp_max_syn_backlog net.core.somaxconn
ss -lntp
ss -n state syn-recv '( sport = :443 )'
nstat -az | grep -E 'TcpExt(Syncookies|Listen|TCPReqQFull|TCPSynRetrans)'
timeout 20 tcpdump -ni any -s 128 -w /tmp/syn-evidence.pcap 'tcp port 443 and (tcp[tcpflags] & (tcp-syn|tcp-ack) != 0)'Добавьте application probe: DNS lookup, TCP connect, TLS handshake, HTTP status и time to first token должны иметь отдельные timestamps. Иначе улучшение packet counters можно ошибочно принять за восстановление LLM API.
SYN cookies: аварийный fallback с ограниченной областью действия
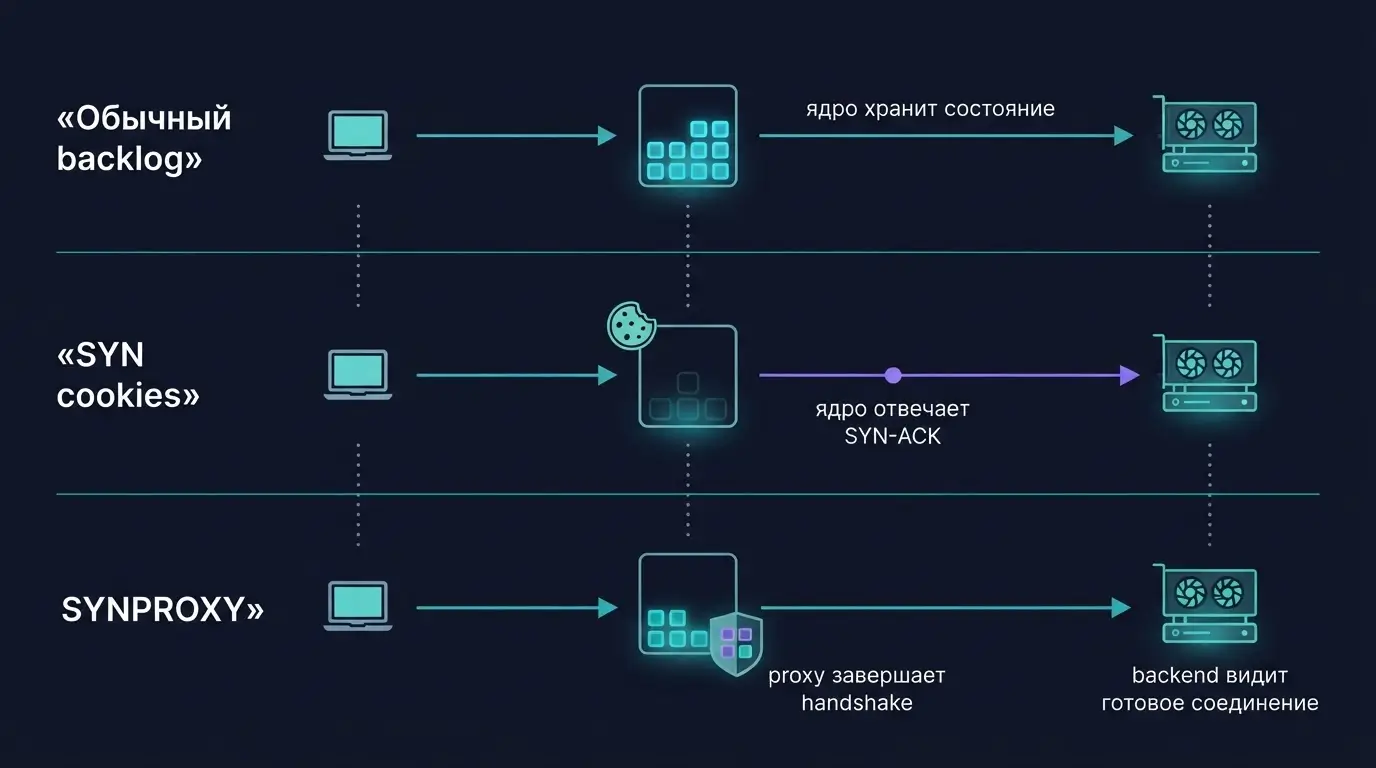
При net.ipv4.tcp_syncookies=1 Linux начинает отправлять SYN cookies, когда SYN backlog переполнен, если ядро собрано с CONFIG_SYN_COOKIES. Вместо хранения полноценного request state сервер кодирует часть параметров в sequence number SYN-ACK и восстанавливает состояние после корректного ACK. Это позволяет пережить поток half-open соединений с меньшим расходом памяти на backlog.
Но cookie не создаёт дополнительный CPU, не ускоряет accept loop и не защищает L7. Документация ядра называет механизм fallback facility и прямо запрещает использовать его как tuning для легальной нагрузки. В старых реализациях cookies ограничивали TCP options; современные ядра умеют больше, но выбор MSS и восстановление расширений всё равно следует проверять на вашей версии и реальном клиентском профиле.
Значение 2 включает безусловную генерацию cookies и предназначено для тестирования эффекта. Это не production default. Если включить его постоянно, можно потерять сигнал о реальном состоянии backlog и принять ухудшение path за норму.
Практический критерий: cookies полезны, когда входящий SYN rate временно выше способности listener хранить незавершённые handshake, а established path после ACK остаётся здоровым. Если одновременно растут ListenDrops, CPU softirq, TLS latency и queue модели, проблема шире.
SYNPROXY в nftables: вынести проверку handshake на edge
SYNPROXY отвечает на initial SYN в netfilter context и пропускает соединение к локальному listener или backend только после корректного ACK. Backend не хранит half-open state для каждого неподтверждённого клиента. В отличие от обычных cookies на endpoint, здесь граница контроля переносится на edge. Это полезно, когда вы действительно хотите изолировать дорогой L7 gateway и его conntrack/accept path.
Цена — новая stateful dependency. SYNPROXY требует connection tracking, переводит sequence numbers и должен объявлять клиенту параметры, совместимые с backend: MSS, window scale, SACK и timestamps. Ошибка в MSS способна создать PMTU-подобные black holes; неверный wscale — странную производительность уже после успешного handshake. Поэтому параметры не угадывают. Их снимают с SYN-ACK backend из внешней тестовой точки.
Актуальный manpage nftables указывает, что statement synproxy сам завершает обработку как drop-verdict с побочным эффектом, а sequence translation требует conntrack. Это влияет на порядок chains и приоритеты: соседний accept в другой base chain не должен случайно обходить задуманный path.
Ниже — лабораторный каркас, не готовая политика. Адреса, интерфейсы, hook priority и backend options должны соответствовать вашей топологии. Загружайте ruleset через nft -c и out-of-band доступ.
table inet llm_synproxy {
  chain raw_prerouting {
    type filter hook prerouting priority raw; policy accept;
    tcp dport 443 tcp flags syn notrack
  }

  chain input {
    type filter hook input priority filter; policy accept;
    ct state invalid,untracked tcp dport 443 synproxy mss 1460 wscale 7 timestamp sack-perm
    ct state invalid drop
  }
}nft -c -f synproxy-lab.nft
nft list ruleset
conntrack -S
nstat -az | grep -E 'TcpExt(Syncookies|Listen|TCPReqQFull)'
Backlog, cookies или SYNPROXY: выбирайте по owner проблемы
Увеличение tcp_max_syn_backlog оправдано, когда всплеск легальный, короткий, память рассчитана, а listener после него быстро разгребает очередь. Один request socket SYN_RECV расходует память; ядро документирует ориентир около 304 байт, но реальный бюджет включает slab, conntrack, packet queues и namespace overhead. Лимит нельзя выбирать из чужого рецепта.
Cookies оставляют owner на backend kernel и дают аварийный запас без предварительного state на каждый SYN. SYNPROXY добавляет отдельный edge owner и имеет смысл, когда вы готовы владеть conntrack capacity, nftables lifecycle, параметрами TCP options, observability и failover. Managed L4 DDoS/LB может быть проще, если команде не нужен собственный stateful control plane.
Default для buyer decision: не менять платформу до доказанного handshake bottleneck. Dedicated edge ценен воспроизводимыми NIC queues, kernel/nftables version, отдельным failure domain и change window. Но новое железо не исправит медленный accept loop, retry storm, неверный MSS, proxy buffering или очередь GPU inference.
Этот принцип дополняет материалы KingServers про SO_REUSEPORT и accept-очереди, TLS handshake storm и RSS/RPS/IRQ affinity: каждый из них отвечает за свой участок path.
Canary без самообмана: A/B/A на свежих соединениях
Rollout начинайте с одного edge IP, одного listener или небольшой доли разрешённого synthetic traffic. Baseline A должен быть снят теми же probes, что и canary B: SYN/SYN-ACK/ACK, TcpExt deltas, conntrack, accept counters, TLS success, HTTP status, TTFT и доля завершённых streams. Сравнение средних за час размоет короткий отказ.
Healthy negative control нужен обязательно. Отправьте обычный запрос без flood-like burst через неизменённый path. Если после SYNPROXY растёт TCP connect time и одновременно падает negotiated window у здоровых клиентов, это regression, даже если backend SYN_RECV уменьшился. Другой negative control — прямой закрытый backend path из management сети: он помогает отделить edge от приложения.
После положительного B вернитесь к A. Если симптом не возвращается, причинность не доказана: возможно, закончился внешний burst или освободилась queue модели. Затем повторите B. Такой A/B/A кажется медленным, зато спасает от ложного успеха во время инцидента.
Перед изменением сохраните atomic ruleset, sysctl snapshot и команду rollback. Не удаляйте старый path раньше, чем established streaming sessions корректно drain. Для LLM API обрыв через двадцать минут после «успешного» handshake заметнее клиенту, чем лишние миллисекунды canary.
Наблюдаемость: связать packets, kernel и первый токен
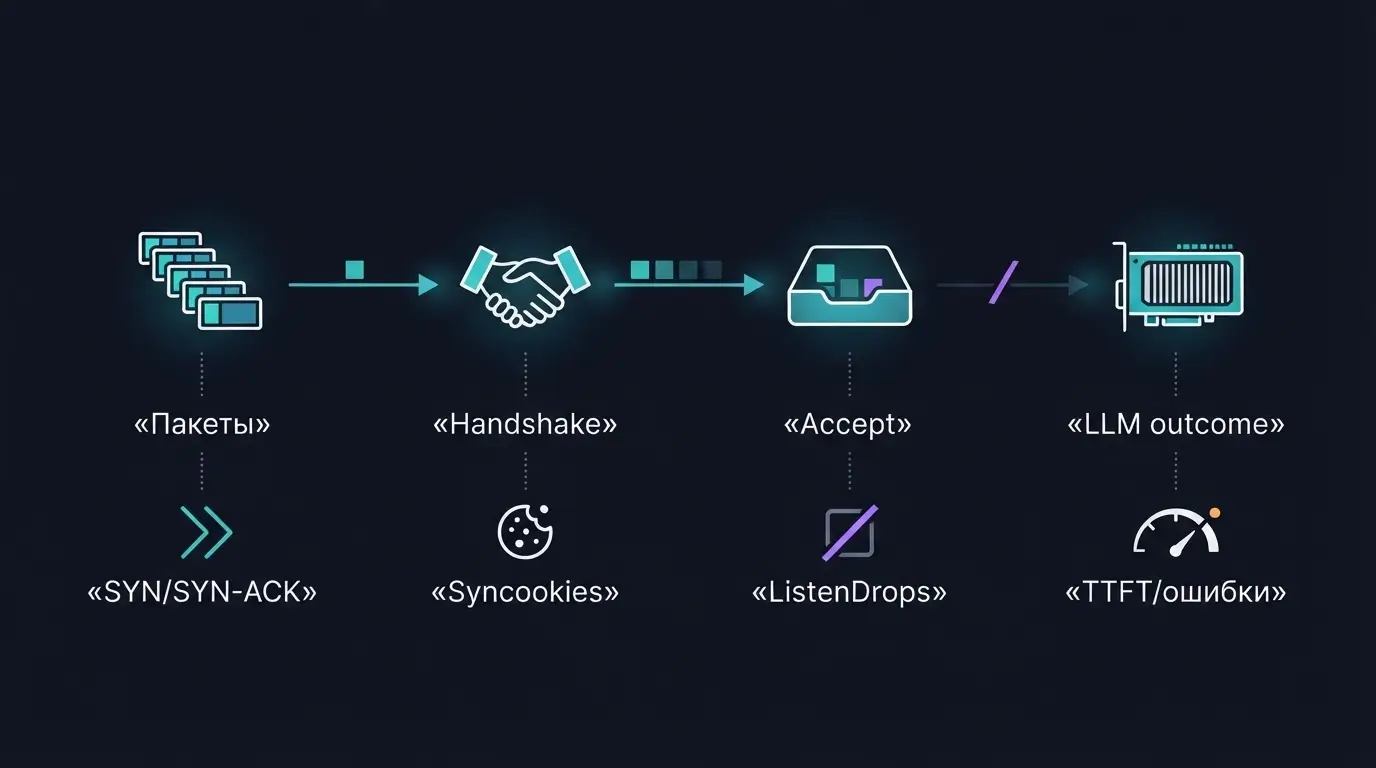
Один counter не отвечает на вопрос «пользователь получил ответ?». Постройте четыре независимых evidence gate. Packet gate показывает входящие SYN, ответы SYN-ACK и финальные ACK. Kernel gate — SYN_RECV, cookies, listen drops, conntrack и softirq. Application gate — accept rate, TLS/HTTP errors, active streams и queueing gateway. LLM gate — admitted requests, очередь scheduler, TTFT и успешное завершение.
Алерт на абсолютный SyncookiesSent будет шуметь после перезагрузки или не шуметь месяцами из-за накопленного значения. Используйте rate/delta и привязывайте его к fresh connection success. То же относится к ListenDrops. Для нескольких listeners собирайте socket-level backlog через ss и данные процесса, иначе системный total скроет один горячий порт.
Отдельно маркируйте место TLS termination. Если SYNPROXY стоит перед внешним L4 load balancer, backend видит соединения от LB, а не исходных клиентов; packet и application identity расходятся. Если TLS termination на том же edge, CPU handshake storm способен стать следующим bottleneck сразу после успешного SYN mitigation.
Не смешивайте этот runbook с L7 abuse. Rate limits и quotas защищают дорогие запросы после HTTP parsing; SYNPROXY не знает tenant, token budget или стоимость prompt. Слой должен отвечать только за доказанный риск.
Типичные ошибки, которые превращают защиту в новый инцидент
Первая ошибка — считать строку SYN flood в kernel log достаточным доказательством злонамеренного трафика. Легальный reconnect storm после DNS failover выглядит похоже. Вторая — поднять tcp_max_syn_backlog без memory budget и наблюдения за softirq: потери просто смещаются дальше по path.
Третья — копировать MSS 1460 и wscale 7 из примера. Tunnel, VLAN, IPv6 и provider edge меняют effective MTU; backend может объявлять другие options. Четвёртая — включить SYNPROXY на одном направлении асимметричного path. Stateful translation требует видеть нужные пакеты соединения; ECMP или policy routing могут разрушить предположение.
Пятая — забыть про persistence. Ручной nft add rule исчезает после reboot или конфликтует с конфиг-менеджментом. Ruleset должен иметь owner, version, review, atomic deploy и проверенный restore. Материал про nftables sets полезен для организации изменяемых списков, но sets сами по себе не заменяют handshake validation.
Шестая — объявить успех по снижению SYN_RECV. Если TTFT ухудшился, established sessions рвутся, а retry rate вырос, вы лишь перенесли bottleneck. В production итог всегда application outcome на свежем соединении и после повторного запроса.
Production checklist и граница инфраструктурного решения
Перед rollout назначьте владельцев: сеть отвечает за ingress и symmetric path, platform team — за nftables/conntrack lifecycle, команда gateway — за listener и TLS, inference team — за admission и очередь модели. Один человек не обязан владеть всем, но incident commander должен видеть карту owner’ов.
Зафиксируйте stop conditions заранее: рост connect errors здорового canary, потеря management access, conntrack pressure, нарушение MSS/PMTU, рост CPU edge или деградация TTFT. Автоматический rollback допустим только по устойчивому сигналу; одиночный packet loss не должен запускать oscillation.
Когда доказано, что bottleneck именно на shared network edge и команде нужен полный контроль kernel, NIC, conntrack и change window, отдельный VPS или выделенный gateway становится рациональным. Сравнивайте варианты по failure domain, доступу к packet capture, фиксированной версии kernel, capacity headroom и времени восстановления. Обещание «будет быстрее» без canary ничего не стоит.
Если bottleneck в accept loop, сначала исправьте workers, SO_REUSEPORT и drain. Если причина в TLS, используйте resumption/keepalive и управляйте reconnect. Если очередь на GPU, SYNPROXY только сделает путь до перегруженной модели аккуратнее. Инфраструктура должна закрывать доказанный control gap, а не заменять расследование.
Итог: защищайте handshake, но измеряйте сервис
SYN cookies и SYNPROXY решают разные задачи. Cookies — аварийный механизм endpoint kernel при переполнении SYN backlog. SYNPROXY — перенос проверки handshake на stateful edge с собственной ценой владения. Ни один вариант не лечит медленный accept, TLS storm, retry loop или очередь inference.
Начните с evidence bundle: packet trace, TcpExt deltas, состояние двух очередей и fresh-connection probe до первого токена. Затем меняйте одного owner через A/B/A canary и повторяйте те же проверки после rollback. Такой порядок немного строже привычного «поднять sysctl», зато оставляет команде доказательство, которое переживёт следующий инцидент.
Практический следующий шаг — сегодня снять baseline на одном production listener без изменений: sysctl, ss, nstat и контролируемый запрос. Если обнаружится реальный control gap на edge, его уже можно обсуждать как отдельный VPS, dedicated gateway или managed L4-защиту с понятным owner и rollback.