Оглавление
- Snapshot Qdrant — не вся стратегия восстановления
- Начните с RPO и RTO, а не с команды curl
- Зафиксируйте baseline до создания snapshot
- Создайте snapshot и сразу вынесите его из failure domain
- В распределённом Qdrant снимайте каждый узел
- Восстанавливайте сначала в изолированное окружение
- Докажите восстановление на уровне RAG-приложения
- Переключайте трафик через alias и сохраняйте rollback
- Автоматизируйте копии, но проверяйте restore вручную и на game day
Готовы перейти на современную серверную инфраструктуру?
В King Servers мы предлагаем серверы как на AMD EPYC, так и на Intel Xeon, с гибкими конфигурациями под любые задачи — от виртуализации и веб-хостинга до S3-хранилищ и кластеров хранения данных.
- S3-совместимое хранилище для резервных копий
- Панель управления, API, масштабируемость
- Поддержку 24/7 и помощь в выборе конфигурации
Результат регистрации
...
Создайте аккаунт
Быстрая регистрация для доступа к инфраструктуре
Snapshot Qdrant — не вся стратегия восстановления
У snapshot есть сильная сторона: он сохраняет данные коллекции вместе с конфигурацией и готовым индексом. После восстановления не приходится заново строить HNSW, а это особенно заметно на большой RAG-базе. Но архив относится к конкретной коллекции и конкретному узлу. Он не включает collection aliases, не описывает балансировщик, API-ключи, DNS, объектное хранилище и порядок возврата приложения.
Поэтому быстрый verdict такой: для single-node Qdrant snapshot — хороший переносимый recovery artifact; для распределённого кластера нужен комплект копий по узлам и отдельный runbook; в Qdrant Cloud для полного disaster recovery разумнее использовать backups. Официальная документация прямо разделяет snapshots и cloud backups. Это та же граница, что подробно разобрана в материале KingServers «Backup vs Snapshot».
Disqualifier важен сразу: snapshot не лечит ошибочную embedding-модель, неверный chunking или потерю исходных документов. Если после восстановления векторы формально доступны, но retrieval выбирает не те фрагменты, проблема находится выше storage layer. Не покупайте дополнительный сервер до того, как локализовали слой отказа.
Начните с RPO и RTO, а не с команды curl
RPO отвечает на вопрос, сколько последних изменений допустимо потерять. RTO — сколько времени сервис может оставаться без нормального поиска. Для каталога, который переиндексируется из PostgreSQL или object storage, RPO Qdrant может быть мягче: источником истины остаётся документная база. Для пользовательской памяти ассистента потеря последних часов может быть уже бизнес-инцидентом.
Соберите resource budget восстановления: объём snapshot, свободное место на target, пропускную способность между failure domains, RAM для открытия сегментов и окно, в котором GPU-инференс будет получать неполный контекст. По актуальной документации Qdrant target во время миграции или восстановления может требовать дополнительное дисковое пространство: одновременно существуют архив и восстановленная коллекция. Проверяйте это на своей версии и фактическом размере, а не переносите чужую оценку.
Практический пример: snapshot создаётся каждые шесть часов, но выгружается с узла только раз в сутки. Формальный RPO равен не шести часам, а возрасту последней копии, пережившей отказ узла. Owner должен уметь назвать эту дату без входа на уже умерший сервер. Более широкий процесс удобно сверить с планом Disaster Recovery.
Зафиксируйте baseline до создания snapshot
До первой команды сохраните идентичность среды: точную версию Qdrant, режим single-node или cluster, список коллекций и aliases, vector size и distance, shard_number, replication_factor, write_consistency_factor, quantization и on_disk параметры. Snapshot, созданный Qdrant 1.18.1, по текущему правилу совместимости восстанавливается в ту же minor-ветку не ниже patch-версии источника либо в следующую minor-ветку. Для 1.18.1 это 1.18.1+ или 1.19.x; не превращайте пример в вечное правило — перед restore сверяйтесь с документацией вашей версии.
Снимите data baseline отдельно от конфигурации: число points, несколько известных IDs с payload, результаты десяти-пятидесяти golden queries и негативный набор. Golden query должен иметь ожидаемый документ или допустимый набор документов; negative control — документ, который обязан отсекаться tenant/filter политикой. Так вы отделите «архив распаковался» от «RAG снова отвечает правильно».
Наконец, запишите owner каждого gate. Platform team отвечает за узлы и диски, database owner — за коллекции и aliases, ML/RAG owner — за embedding identity и retrieval outcome. Если один человек отвечает за всё только на бумаге, во время инцидента три слоя снова сольются в одну фразу «Qdrant поднялся».
curl -fsS http://127.0.0.1:6333/\ncurl -fsS http://127.0.0.1:6333/collections/knowledge\ncurl -fsS 'http://127.0.0.1:6333/collections/knowledge/points/count?exact=true'
Создайте snapshot и сразу вынесите его из failure domain
Collection snapshot создаётся API-запросом к конкретному узлу. Ответ возвращает имя файла; затем файл нужно скачать, посчитать checksum и отправить в независимое хранилище. Копия на том же NVMe защищает от неудачного UPDATE, но не от потери диска, узла или стойки. Объектное хранилище, отдельный backup-сервер или другой регион выбираются по вашему threat model.
Не считайте HTTP 200 доказательством backup. Минимальный evidence bundle включает JSON-ответ создания, размер файла, SHA-256, версию Qdrant, collection config, timestamp и результат чтения архива из целевого хранилища. Шифрование и retention задаются вне Qdrant, а ключ восстановления не должен находиться только в том же кластере.
Для хранения больших коллекций полезна отдельная I/O-квота: snapshot не должен вытеснить рабочие сегменты или забить диск временными файлами. Qdrant позволяет указать snapshots_path и отдельный путь для временных файлов. Если storage budget не выдерживает одновременно рабочие данные и создание архива, это уже qualifying condition для выделенного backup path или отдельного узла, а не повод запускать cron чаще.
QDRANT=http://127.0.0.1:6333\nCOLLECTION=knowledge\nSNAPSHOT=$(curl -fsS -X POST "$QDRANT/collections/$COLLECTION/snapshots" | jq -r '.result.name')\ncurl -fsS -o "$SNAPSHOT" "$QDRANT/collections/$COLLECTION/snapshots/$SNAPSHOT"\nsha256sum "$SNAPSHOT" > "$SNAPSHOT.sha256"\nsha256sum -c "$SNAPSHOT.sha256"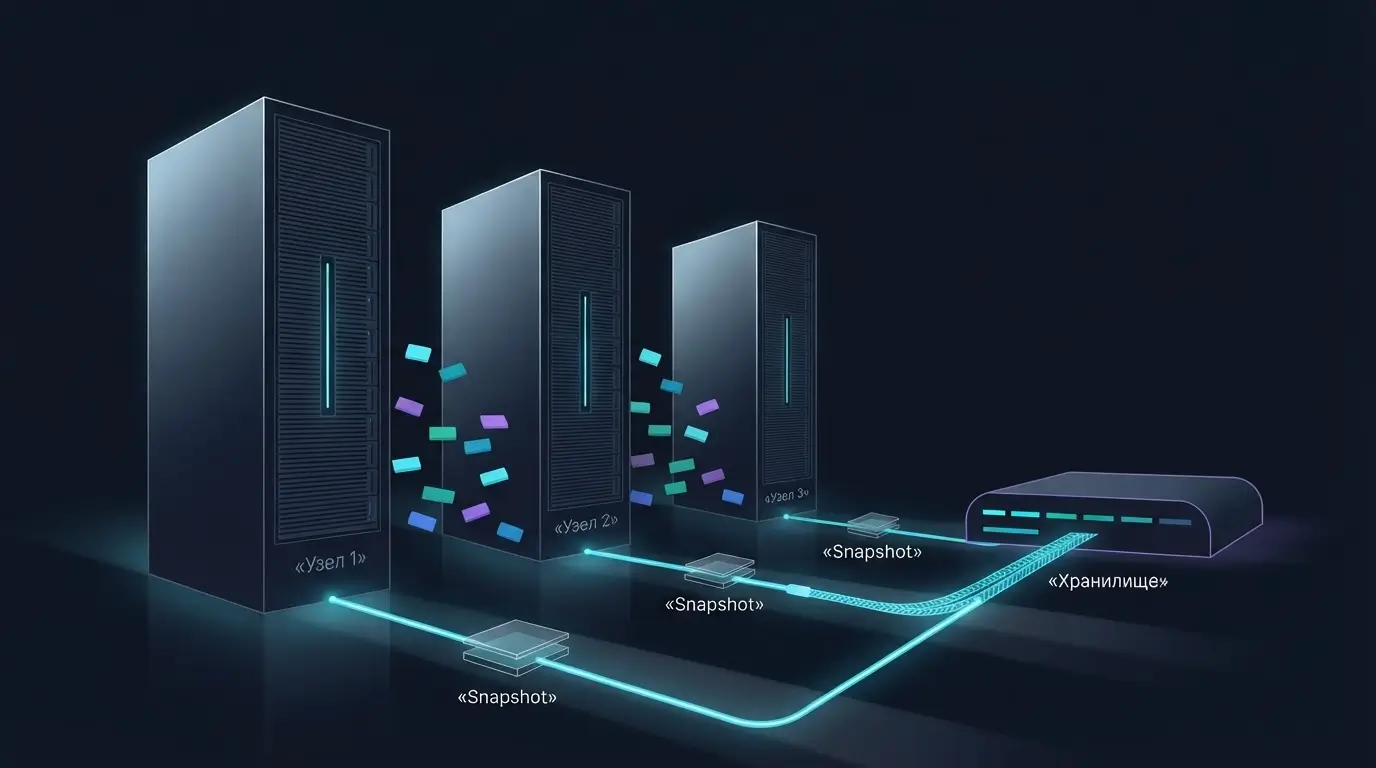
В распределённом Qdrant снимайте каждый узел
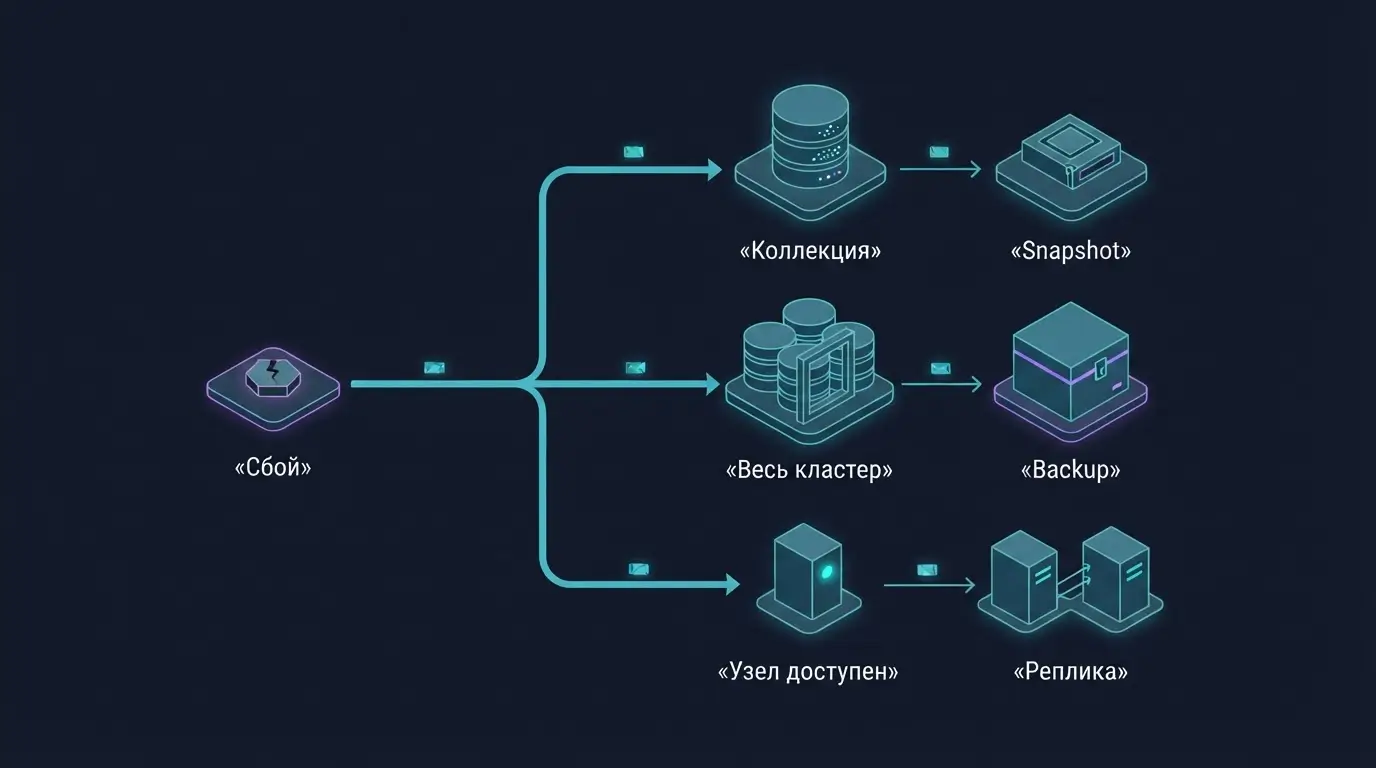
В cluster mode одна collection snapshot содержит только данные, размещённые на узле, который её создал. Значит, запрос к случайному endpoint не даёт полную копию распределённой коллекции. Runbook обязан перечислить peers, запросить snapshot на каждом узле и связать файлы общим manifest: cluster ID, peer ID, collection, shard inventory, версия, время и checksum.
Репликация остаётся первым механизмом высокой доступности. При кратком выпадении узла Qdrant может восстановить пропущенные операции через WAL delta; если разница недоступна, возможен fallback к полному переносу records. Snapshot transfer переносит готовый индекс и quantized data, но требует дополнительного места. Эти методы решают восстановление replica внутри живого кластера, тогда как внешний snapshot нужен против удаления коллекции, повреждения данных или потери failure domain.
Типичная ловушка: три узла размещены на одном физическом сервере или одном сетевом томе. Формально replication_factor равен трём, фактически failure domain один. Перед покупкой большего кластера нарисуйте physical placement: питание, гипервизор, NVMe, стойка, регион. Выделенная инфраструктура полезна здесь не «ускорением векторов», а контролем размещения, I/O budget и окна восстановления. Для выбора backend пригодится сравнение Ceph, MinIO и NAS.
Восстанавливайте сначала в изолированное окружение
Никогда не проверяйте новый runbook первым restore поверх production. Поднимите target той же или совместимой версии, ограничьте входящий трафик и убедитесь, что приложение не может случайно писать туда до завершения проверки. Для новой коллекции официальный API поддерживает recover по доступному URL, file URI или загрузку файла. В Qdrant Cloud outbound URL restore ограничен, поэтому используйте поддерживаемый upload или cloud backup flow.
Для пустой target-коллекции задавайте priority=snapshot. Оставленный по умолчанию priority=replica предпочитает существующее состояние, и в новом кластере это может означать пустой источник. Режим no_sync предназначен для специальных ручных сценариев; без точного shard map он способен оставить систему в сломанном состоянии. Это не «быстрый restore», а инструмент для оператора, который управляет синхронизацией сам.
После запроса дождитесь завершения, но не переключайте alias. Сначала инфраструктурный gate: collection status green, все shards active, replica count соответствует плану, vector configuration совпала. Затем data gate: count, контрольные IDs и payload. Только после них открывается application gate. Порядок важен: если point отсутствует, обсуждать качество ответа LLM рано.
curl -fsS -X PUT 'http://restore-qdrant:6333/collections/knowledge_restore/snapshots/recover' \\\n -H 'Content-Type: application/json' \\\n -d '{"location":"file:///qdrant/snapshots/knowledge.snapshot","priority":"snapshot"}'\n\ncurl -fsS http://restore-qdrant:6333/collections/knowledge_restore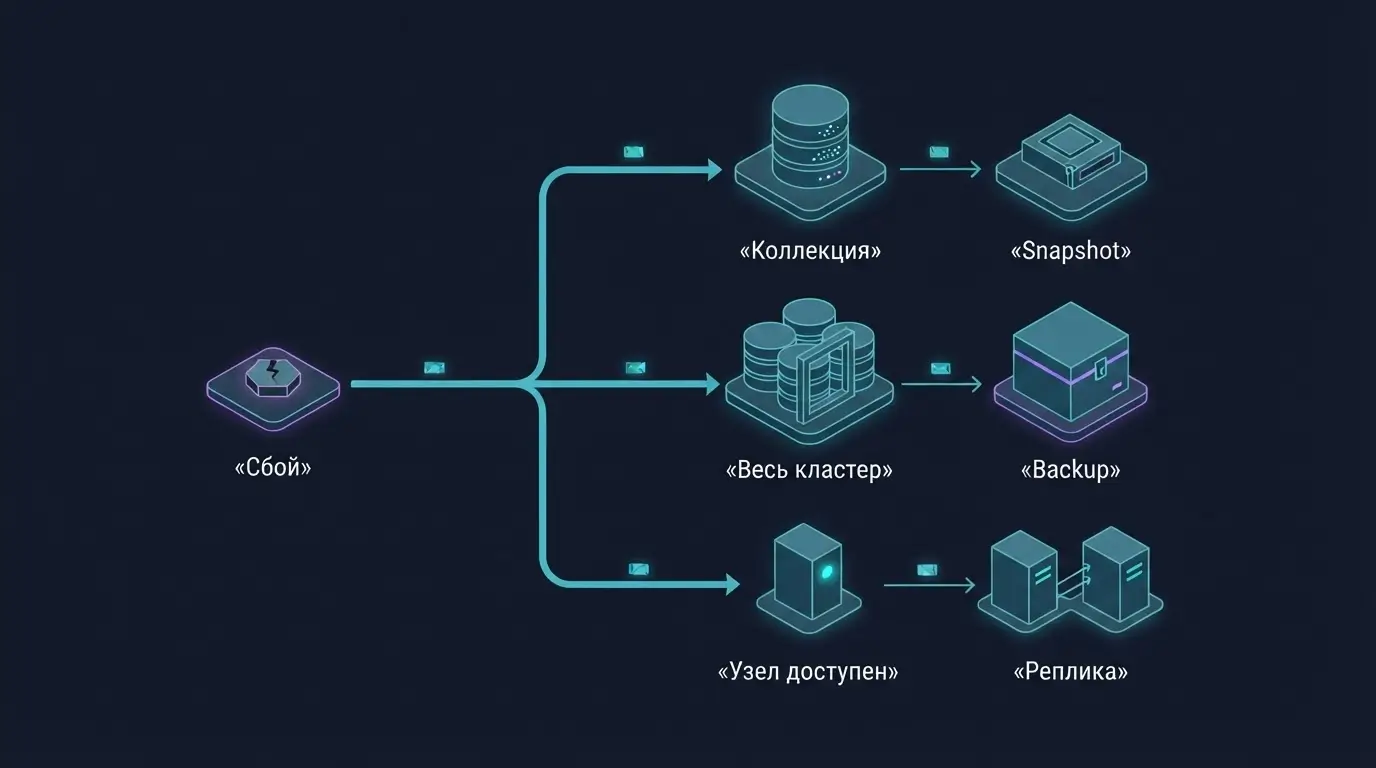
Докажите восстановление на уровне RAG-приложения
Зелёная коллекция подтверждает storage mechanism, но не пользовательский результат. Запустите golden queries тем же embedding pipeline и теми же search parameters, что использует production: vector name, limit, filters, score threshold, hybrid dense/sparse fusion. Сравнивайте не только top-1. Для RAG важны presence ожидаемого источника в top-k, соблюдение tenant boundaries и возможность собрать ответ с корректными citations.
Добавьте отрицательную проверку. Например, запрос от tenant A не должен вернуть документ tenant B, удалённый документ не должен снова появиться, а заведомо нерелевантный corpus не должен пройти threshold. Именно negative control ловит опасный restore: данные доступны, latency приемлема, но старая payload-схема отключила фильтр доступа.
Метрики держите раздельно: infrastructure — shard state, disk и process errors; retrieval — latency, empty result rate, expected-document hit rate; application — доля успешных ответов, корректность ссылок и cancellations. Не обещайте, что snapshot восстановит изменения после точки создания. Если ingestion продолжался, отставание должно проявляться как измеримый RPO gap, а не как сюрприз пользователей.
./rag_probe --collection knowledge_restore --suite golden.json --expect-source\n./rag_probe --collection knowledge_restore --suite tenant-boundary.json --expect-deny\n./rag_probe --collection knowledge_restore --suite deleted-docs.json --expect-absent
Переключайте трафик через alias и сохраняйте rollback
Безопасный cutover меняет один управляемый указатель, а не конфигурацию десятка сервисов. Если приложение использует alias, подготовьте восстановленную коллекцию под новым именем, завершите gates, затем атомарно переключите alias. Старую коллекцию не удаляйте до окончания observation window и подтверждения, что новые записи идут в правильный target.
Canary может направлять малую долю read-only запросов на восстановленную коллекцию. Сравнивайте одинаковые query IDs, embedding hash и фильтры; иначе различие результатов нельзя приписать restore. Stop condition задайте заранее: рост ошибок, нарушение tenant filter, неожиданный empty result или несовместимая схема payload означает возврат alias на baseline.
Rollback должен повторять те же доказательства в обратном порядке: application probe после возврата alias, data probe на baseline и проверка, что writer больше не пишет в rejected target. Если команда умеет переключить alias вперёд, но не репетировала обратное движение, это ещё не recovery plan.
Автоматизируйте копии, но проверяйте restore вручную и на game day
Автоматизация должна создавать snapshot по расписанию, выгружать его, проверять checksum, применять retention и сообщать возраст последней успешной внешней копии. Алерт «job failed» слабее, чем метрика backup_age_seconds: cron может завершаться успешно, пока upload годами пишет в неверный bucket. Добавьте capacity alert на snapshots_path и target storage.
Раз в квартал или с частотой, соответствующей риску, проводите restore drill на изолированном сервере. Засекайте реальные RTO-фазы: доставка архива, распаковка, старт коллекции, data validation, application probes и cutover preparation. Эти числа принадлежат вашей системе; в статье честно нельзя обещать универсальные минуты.
Game day должен начинаться не с удаления production-коллекции, а с заранее описанного сценария. Выберите свежий snapshot, запретите target исходящий доступ к боевому приложению, выдайте временные credentials и назначьте наблюдателя, который не выполнял backup. Если только автор скрипта способен восстановить данные, runbook ещё не передаваем. После проверки удалите временные ключи и сам тестовый target согласно retention policy.
Проверьте и «неудобные» границы: истёкший API key, недоступный object storage, недостаток свободного места, несовместимую minor-версию и прерванную загрузку архива. Ожидаемый результат здесь — ранний, понятный отказ без частичного cutover. Для каждого сбоя запишите owner, безопасный способ очистки и точку, с которой процедуру можно повторить. Так резервная копия превращается в операционную способность, а не в файл с хорошим именем.
Для production RAG полезен manifest, связывающий snapshot с embedding model, revision corpus и схемой payload. Если база восстановилась, но embedding service уже перешёл на другую размерность или нормализацию, поиск либо упадёт, либо даст несопоставимые оценки. Храните model identity рядом с recovery evidence, даже если сами веса живут в другом registry. Команды с rag_probe выше — намеренный каркас локального тестового harness, а не штатная CLI Qdrant; реализуйте его через официальный Query API и правила своего приложения.
Добавьте один человеческий вопрос в итоговый отчёт: сможет ли дежурный, не участвовавший в настройке, восстановить поиск в допустимый RTO и объяснить, какие данные потеряны по RPO? Если ответ требует устных подсказок, следующий шаг — улучшить manifest и probes, а не увеличивать частоту snapshot. Проверяемость важнее количества архивов.
В журнале учений сохраняйте дату snapshot, фактическое время каждой фазы, объём перенесённых данных и причину любого ручного шага. На следующем game day ручных исключений должно стать меньше, иначе автоматизация только скрывает зависимость от конкретного инженера.
Итог простой: хороший Qdrant snapshot — это не файл, а доказанный путь от конкретной точки данных до корректного ответа RAG. Начните с одной коллекции, выполните изолированный restore, добавьте negative control и измерьте собственные RPO/RTO. Если для этого нужен отдельный NVMe budget, независимое хранилище и контролируемое окно переключения, тогда VPS или dedicated-сервер становятся частью проверяемого плана, а не магической страховкой.