Оглавление
- Сначала симптом, потом offload
- Что именно делают GRO, GSO, TSO и checksum offload
- Постройте owner map реального packet path
- Снимите baseline: features, counters и workload
- Почему tcpdump показывает странные размеры и bad checksum
- Виртуализация и туннели: проверяйте inner и outer path
- Canary: меняйте один флаг и требуйте application outcome
- Как читать результат и не принять миграцию bottleneck за успех
- Когда VPS достаточно, а когда нужен dedicated gateway
- Production-runbook и вывод
Готовы перейти на современную серверную инфраструктуру?
В King Servers мы предлагаем серверы как на AMD EPYC, так и на Intel Xeon, с гибкими конфигурациями под любые задачи — от виртуализации и веб-хостинга до S3-хранилищ и кластеров хранения данных.
- S3-совместимое хранилище для резервных копий
- Панель управления, API, масштабируемость
- Поддержку 24/7 и помощь в выборе конфигурации
Результат регистрации
...
Создайте аккаунт
Быстрая регистрация для доступа к инфраструктуре
Сначала симптом, потом offload
Шлюз LLM API принимает привычный объём запросов, но одно ядро внезапно уходит в softirq, растёт число пакетов в секунду, а время до первого токена становится рваным. На графике CPU всё выглядит как «сеть не справляется», и рука тянется выключить GRO или TSO. Это опасная догадка: похожую картину дают плохое распределение RX-очередей, короткие соединения, туннель без нужного offload, TLS termination и медленный backend.
GRO, GSO, TSO и checksum offload уменьшают количество операций, которые CPU выполняет на каждый пакет. Они не добавляют пропускную способность сами по себе и не исправляют очередь в inference-сервисе. Поэтому рабочий вопрос звучит не «какой флаг быстрее», а «на каком участке packet path изменилась работа и улучшился ли пользовательский outcome».
Для LLM gateway особенно важно разделять две фазы. До первого байта нас интересуют accept, TLS, маршрутизация и TTFT. После начала SSE-потока важны progress, стабильность соединения и отсутствие длинных пауз. Если p99 TTFT не меняется, а CPU proxy падает, это полезный результат, но его нельзя выдавать за ускорение модели.
Дальше используем четыре evidence gate: фактический путь интерфейсов, состояние offload на каждом hop, kernel/NIC counters и application outcome на новых соединениях. Такой порядок продолжает подход из материалов про RSS, RPS и IRQ affinity и SO_REUSEPORT: сначала локализуем owner, затем меняем ровно один механизм.
Что именно делают GRO, GSO, TSO и checksum offload
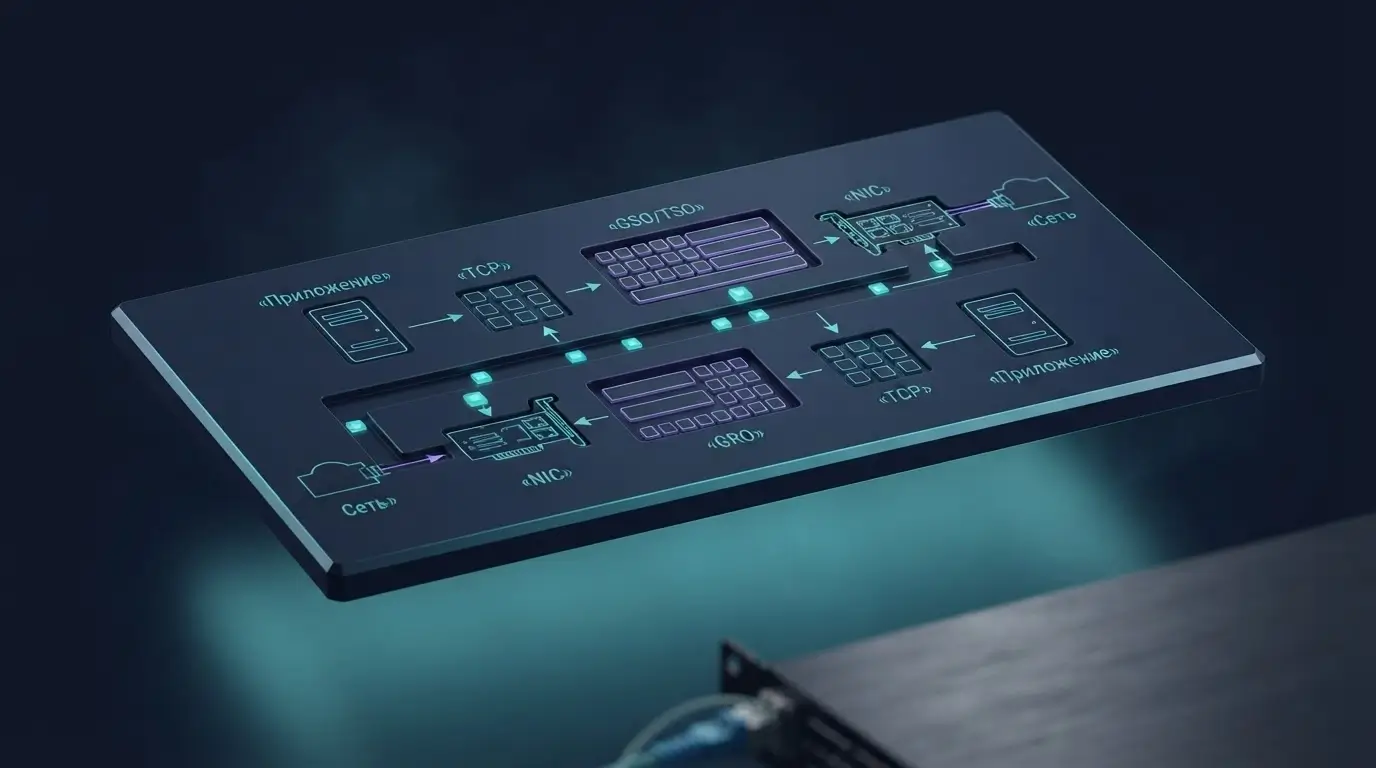
GSO позволяет стеку Linux передавать вниз крупный socket buffer, который позже будет разрезан на сегменты. TSO выполняет TCP-сегментацию в сетевой карте, а программный GSO остаётся страховкой для пути, где железо не умеет нужный вариант. На приёме GRO объединяет совместимые пакеты в более крупные skb, чтобы верхние слои обрабатывали меньше объектов.
Связка симметрична по смыслу, но не по месту исполнения. TSO относится к передаче и зависит от возможностей NIC и TX checksum offload. GRO работает на receive path и может выполняться программно. Официальная документация Linux по segmentation offloads подчёркивает: собранная GRO последовательность в идеале должна снова корректно сегментироваться через GSO.
Checksum offload тоже не означает «контрольная сумма отсутствует». При TX стек оставляет устройству описание того, где лежат данные для вычисления; на RX драйвер сообщает, проверена ли сумма. В туннелях появляются внутренний и внешний заголовки, поэтому поддержка обычного TCP checksum ещё не доказывает корректную обработку VXLAN или Geneve. Состояния CHECKSUM_PARTIAL и CHECKSUM_UNNECESSARY описаны в документации ядра.
Практический пример: proxy пишет крупную TLS-запись, стек держит её как большой skb, а NIC формирует wire-sized TCP segments. Если снять tcpdump на хосте до NIC, можно увидеть «пакет» больше MTU. Это не доказательство, что такой Ethernet frame ушёл в сеть. Проверяли ли вы тот же поток с внешнего TAP или на соседнем узле?
Постройте owner map реального packet path
На выделенном сервере путь может быть коротким: физический NIC → Linux TCP → NGINX или Envoy → upstream. На VPS он часто длиннее: NIC хоста → vhost/virtio → интерфейс гостя → bridge или overlay → контейнерный veth → proxy. У каждого hop свой набор feature flags, свои counters и собственный owner. Проверка только eth0 внутри VM даёт кусок картины, а не картину.
Начните с адреса назначения и фактического peer. Для входящего запроса зафиксируйте интерфейс, RX queue, CPU, namespace, место TLS termination и interface до upstream. Для исходящего потока добавьте route lookup и туннель. Один gateway может принимать клиента по физическому NIC, а ходить к GPU через VXLAN; успешный TSO на первом пути ничего не говорит о втором.
Разделите owner по слоям: провайдер или hypervisor управляет physical NIC и vhost; ваша команда — guest kernel, CNI, proxy и systemd units; приложение — connection pool и streaming semantics. Эта граница важна для решения о VPS или dedicated gateway. Новое железо полезно, когда нужен контроль драйвера, очередей, firmware и change window. Оно не исправляет ошибочный route, single-flow hotspot или очередь vLLM.
Мини-кейс: после миграции в VM растёт CPU при той же нагрузке. В госте TSO включён, но host-side tap не принимает нужный tunnel GSO и выполняет software segmentation. Лечить guest sysctl бессмысленно. Evidence должен дойти до границы, которой вы реально управляете.
ip -br link
ip route get 203.0.113.20
ethtool -i eth0
ethtool -k eth0
ethtool -S eth0 | head -n 80
ip -s -s link show dev eth0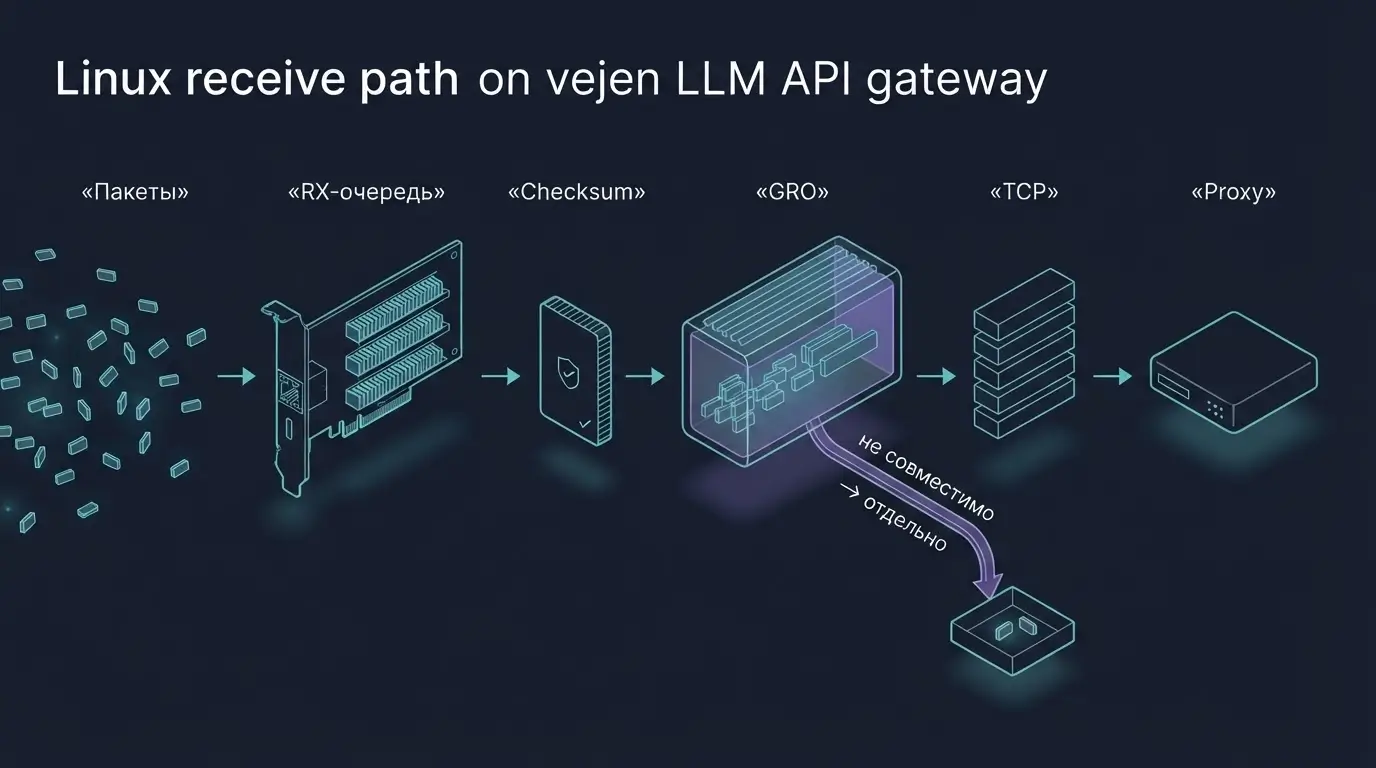
Снимите baseline: features, counters и workload
ethtool -k показывает requested и effective features. Пометка [fixed] означает, что драйвер не разрешает переключить опцию обычной командой. Не превращайте список флагов в чеклист «всё должно быть on»: набор зависит от драйвера, типа устройства, инкапсуляции и kernel version. Актуальный ethtool остаётся стандартным интерфейсом управления драйвером и hardware features; его возможности перечислены на странице проекта.
Baseline нужен одновременно на трёх уровнях. На NIC смотрите drops, missed errors, queue counters и driver-specific fallback. В ядре — softirq по CPU, backlog/drop, retransmits и packet rate. В приложении — request rate, TTFT, долю 5xx, resets, длину активных SSE-соединений и utilisation inference backend. Запись только среднего CPU скрывает миграцию bottleneck между ядрами.
Снимайте состояние под репрезентативным трафиком и сохраняйте распределение размеров ответов. Короткий health check почти не создаёт полезной нагрузки для TSO/GRO, а один долгий SSE stream плохо показывает параллелизм. Нужны и короткие fresh connections, и потоковые ответы, причём на одной версии proxy и модели.
Документация ядра по RSS/RPS/RFS/XPS объясняет, как потоки распределяются по очередям и CPU. Это соседний механизм: GRO может снизить число skb, но не вылечит очередь, прибитую к одному перегруженному CPU. Если после изменения offload нагрузка просто переехала, application gate не пройден.
Почему tcpdump показывает странные размеры и bad checksum
Захват внутри хоста происходит в точке, где пакет ещё может быть большим skb или иметь незаполненную аппаратную checksum. Поэтому Wireshark способен подсветить checksum как неверную, хотя на wire она корректна. Это нормальный эффект точки наблюдения, а не автоматическое доказательство повреждения трафика.
Сравните минимум две точки: capture на gateway и capture после физического NIC — например, на TAP, SPAN или соседнем узле. Для виртуального пути добавьте capture в guest namespace и на host-side tap. Если «гигантские пакеты» есть только до segmentation, а внешний capture укладывается в MTU, TSO/GSO выполняют ожидаемую работу.
Не отключайте checksum offload глобально ради красивого capture. Сначала используйте анализатор, который умеет учитывать offload, или проверяйте wire-side. Временное выключение допустимо на canary-интерфейсе с коротким change window и явным rollback. На production gateway такая команда меняет CPU-cost всего трафика и может сама создать перегрузку.
Типичная ловушка: инженер видит bad checksum на loopback или veth, выключает TX checksum, CPU растёт, а жалоба клиента остаётся. Правильный negative control — тот же запрос через другой capture point или внешний probe. Если пользовательский outcome не меняется, причина была в наблюдении, а не в пакетах.
sudo tcpdump -ni eth0 -s 0 -w /tmp/gateway-eth0.pcap 'tcp port 443'
sudo nsenter -t "$(pgrep -n nginx)" -n tcpdump -ni any -s 0 -w /tmp/proxy-ns.pcap 'tcp port 443'
ethtool -k eth0 | grep -E 'checksum|segmentation|generic-receive'
Виртуализация и туннели: проверяйте inner и outer path
В overlay-сети один логический пакет несёт внутренние TCP/IP headers и внешний UDP/VXLAN или Geneve header. NIC может уметь обычный TSO, но не конкретный tunnel offload. Тогда часть работы возвращается в software GSO, а CPU host или guest растёт. По одному флагу tcp-segmentation-offload: on это не видно.
Проверьте features на physical NIC, bridge/tap, virtio и veth. Сопоставьте их с реальным encapsulation. Ядро поддерживает отдельные GSO-типы для GRE и UDP tunnels, а также ограничивает глубину вложенных headers. Не переносите поведение bare metal на VPS без измерения: effective path и драйвер здесь другие.
Для Kubernetes добавьте CNI owner: кто создаёт tunnel device, где работает eBPF или iptables, кто меняет MTU. Если после включения overlay появились retransmits, сначала исключите PMTU и MTU mismatch. Offload не компенсирует фрагментацию, потерю ICMP Packet Too Big или слишком большой inner packet.
Нужен понятный procurement default: оставайтесь на текущей платформе, пока не доказан control gap. Dedicated edge оправдан, если canary связывает проблему с недоступным вам host NIC, драйвером, queue layout или tunnel feature. Для общей архитектуры private inference полезен материал про Private AI API, но здесь решение принимается по packet-path evidence.
Canary: меняйте один флаг и требуйте application outcome
Безопасный canary начинается с неизменного baseline-узла и одного узла-кандидата. На них должны идти сопоставимые fresh connections, размеры prompts и режим streaming. Измените только один effective feature: например, GRO на receive path или TSO на transmit path. Одновременное переключение GRO, GSO, TSO и checksum превращает тест в лотерею.
Собирайте механизм и результат в одном окне. Mechanism gate: effective flag действительно изменился, packet rate или skb processing изменились ожидаемо, counters не показывают ошибки. Resource gate: softirq, system CPU и queue pressure не ухудшились. Application gate: TTFT, error rate, resets и скорость выдачи токенов не деградировали. Backend gate: GPU queue и model latency остались сопоставимыми.
После положительного результата выполните контрфакт: верните флаг в baseline и проверьте, вернулась ли метрика. Затем повторите изменение. Такой A/B/A цикл защищает от совпадения с изменением нагрузки. Отдельно смотрите существующие соединения: offload и routing changes могут влиять на новые flows иначе, чем на уже открытые SSE streams.
Canary должен иметь лимит времени и автоматический stop по ошибкам. Не оставляйте ручную команду единственным знанием команды. После принятия решения закрепите setting в NetworkManager, systemd-networkd, udev или конфигурации orchestration, но только способом, соответствующим вашей ОС и драйверу.
#!/usr/bin/env bash
set -euo pipefail
dev=eth0
before="$(ethtool -k "$dev")"
trap 'ethtool -K eth0 gro on; logger -t offload-canary "rollback gro=on"' EXIT
ethtool -K "$dev" gro off
ethtool -k "$dev" | grep 'generic-receive-offload'
# Запустите штатный load probe и сбор NIC/softirq/application metrics.
sleep 60
ethtool -K "$dev" gro on
trap - EXIT
printf '%s\n' "$before" > /var/tmp/offload-baseline.txt
Как читать результат и не принять миграцию bottleneck за успех
Если отключение GRO снижает tail latency, но резко поднимает softirq и не меняет TTFT, вы нашли trade-off, а не готовую настройку. Возможно, coalescing увеличивал burst в proxy, но проблема лежит в scheduler или user-space queue. Проверьте размер batching и wakeups, затем повторите тест. Локальное улучшение одной метрики не должно покупать более хрупкий gateway.
Если TSO off снижает retransmits, найдите точный hop. Возможны driver/firmware defect, несовместимость туннеля или ошибка внешнего устройства. Зафиксируйте kernel, driver и firmware, проверьте release notes и воспроизведите на одном хосте. Постоянно держать TSO off допустимо как осознанный workaround, но его CPU-стоимость должна быть измерена.
Если offload меняет gateway CPU, а application outcome не двигается, bottleneck находится дальше: TLS, proxy, network egress или GPU queue. Это полезный disqualifier для закупки. Материал про TLS handshake storm поможет отделить криптографическую нагрузку, а сравнение Nginx, Caddy и Traefik — проверить границу reverse proxy.
Наконец, не сравнивайте только throughput. Для LLM API важны стабильный first byte, progress после него, отсутствие обрывов и предсказуемая цена CPU на соединение. Иногда лучший результат — тот же latency при меньшем system CPU: он оставляет capacity для пика и делает failure domain менее нервным.
Когда VPS достаточно, а когда нужен dedicated gateway
VPS подходит, если provider даёт стабильный virtio path, вы видите нужные counters, а canary подтверждает application SLO при разумном CPU reserve. Для небольшого private LLM API это часто лучший старт: меньше операционного долга, быстрее rollout, проще резервирование. Требовать physical NIC только потому, что существует TSO, нет смысла.
Dedicated gateway становится рациональным, когда доказана зависимость от конкретного NIC, driver или firmware, нужна предсказуемая queue topology, NUMA locality, аппаратные tunnel features или отдельное change window. Коммерческая ценность здесь не в обещании «меньше latency», а в воспроизводимом baseline и контроле failure domain. Это особенно важно, когда один edge обслуживает много GPU workers.
Managed load balancer снимает часть ownership, но может скрывать offload и queue details. Выбирайте его, если его SLO и telemetry достаточны, а не если хочется избежать диагностики. Если нужен точный контроль packet path, VPS или dedicated edge могут быть прозрачнее — ценой поддержки kernel, drivers и rollback вашей командой.
Перед закупкой сформулируйте disqualifiers. Новая платформа не исправит плохую hash entropy, один горячий flow, неверный MTU, retry storm, proxy buffering или очередь модели. Сначала докажите, что bottleneck проходит через слой, который вы собираетесь купить. Иначе вы просто перенесёте ту же проблему на более дорогой сервер.
Production-runbook и вывод
Сведите решение к короткому operational contract. Для каждого gateway храните kernel, driver, firmware, effective offload features, queue layout и владельца конфигурации. В мониторинге рядом должны жить NIC errors, drops, per-CPU softirq, packet rate, proxy CPU, TTFT, resets и backend latency. Тогда после обновления kernel или миграции VM вы увидите не просто «CPU вырос», а участок, где изменился механизм.
Rollout выполняйте ступенчато: один canary, затем малая доля fresh connections, затем один failure domain. Длинные SSE streams дренируйте отдельно; не используйте mid-stream retry как универсальную HA-функцию. После каждого шага сравнивайте с неизменным baseline и сохраняйте возможность вернуть прежние features без перезагрузки.
Отдельно проверяйте обновления. Feature, показанный как on, может работать иначе после смены driver или виртуальной платформы. Повторите внешний capture, negative control и application probe. Для UDP-based tunnels помните, что устаревший UFO не является современной стратегией: актуальный путь строится на GSO и tunnel-specific offloads.
Главный вывод простой: GRO, GSO, TSO и checksum offload — это способы уменьшить packet-processing work, а не магические ускорители LLM. Оставляйте настройку, только если связали effective mechanism с resource budget и пользовательским outcome, а затем подтвердили причинность rollback. Начните с owner map и baseline на одном gateway; если evidence упрётся в чужой hypervisor или закрытый NIC, тогда уже выбирайте инфраструктуру с нужной границей контроля.