Оглавление
- Когда проблема действительно находится в accept-пути
- Что меняет SO_REUSEPORT в Linux
- Baseline: доказать listener bottleneck до изменения
- Включение reuseport в NGINX без магии
- Проверка распределения по workers и application gate
- Когда нужен eBPF steering, а когда он лишний
- Canary, graceful lifecycle и симметричный rollback
- VPS, dedicated edge или managed gateway: решение после доказательства
- Типичные ошибки и короткий production checklist
- Вывод: сначала доказательство, потом socket tuning
Готовы перейти на современную серверную инфраструктуру?
В King Servers мы предлагаем серверы как на AMD EPYC, так и на Intel Xeon, с гибкими конфигурациями под любые задачи — от виртуализации и веб-хостинга до S3-хранилищ и кластеров хранения данных.
- S3-совместимое хранилище для резервных копий
- Панель управления, API, масштабируемость
- Поддержку 24/7 и помощь в выборе конфигурации
Результат регистрации
...
Создайте аккаунт
Быстрая регистрация для доступа к инфраструктуре
Когда проблема действительно находится в accept-пути
Картина знакомая: после burst-трафика время до первого токена растёт, часть новых соединений получает reset или долго ждёт, а GPU при этом не упираются ни в вычисления, ни в память. На edge-узле один worker занят заметно сильнее соседей, число новых TCP-сессий растёт, но уже установленные долгие стримы продолжают работать. Это хороший повод проверить accept-путь, но ещё не доказательство, что нужен SO_REUSEPORT.
Сначала сформулируйте симптом на уровне пользователя: растёт доля неуспешных новых подключений, увеличивается connect/TLS time либо задержка до первого байта, тогда как метрика времени генерации первого токена на inference backend остаётся стабильной. Для LLM API это принципиально: клиент видит один «медленный ответ», хотя очередь могла возникнуть в DNS, TLS, listener, upstream pool или уже на GPU. Если не разделить эти этапы, socket tuning легко станет дорогим плацебо.
Disqualifier простой. Не включайте reuseport, если доминирует очередь запросов внутри vLLM/TGI, закончился KV cache, proxy буферизует SSE, клиенты устроили retry storm либо CPU съедает TLS handshake. Для TLS есть отдельный runbook по handshake storm, а для общего устройства edge полезно сначала свериться с материалом про private AI API.
Рабочая гипотеза звучит узко: «при одинаковом application SLO listener с общей accept-очередью теряет или задерживает новые подключения, а распределение по workers асимметрично». Проверять её нужно на canary и тем же профилем нагрузки, который создаёт инцидент: короткие соединения нельзя подменять несколькими вечными keepalive-сессиями.
Что меняет SO_REUSEPORT в Linux
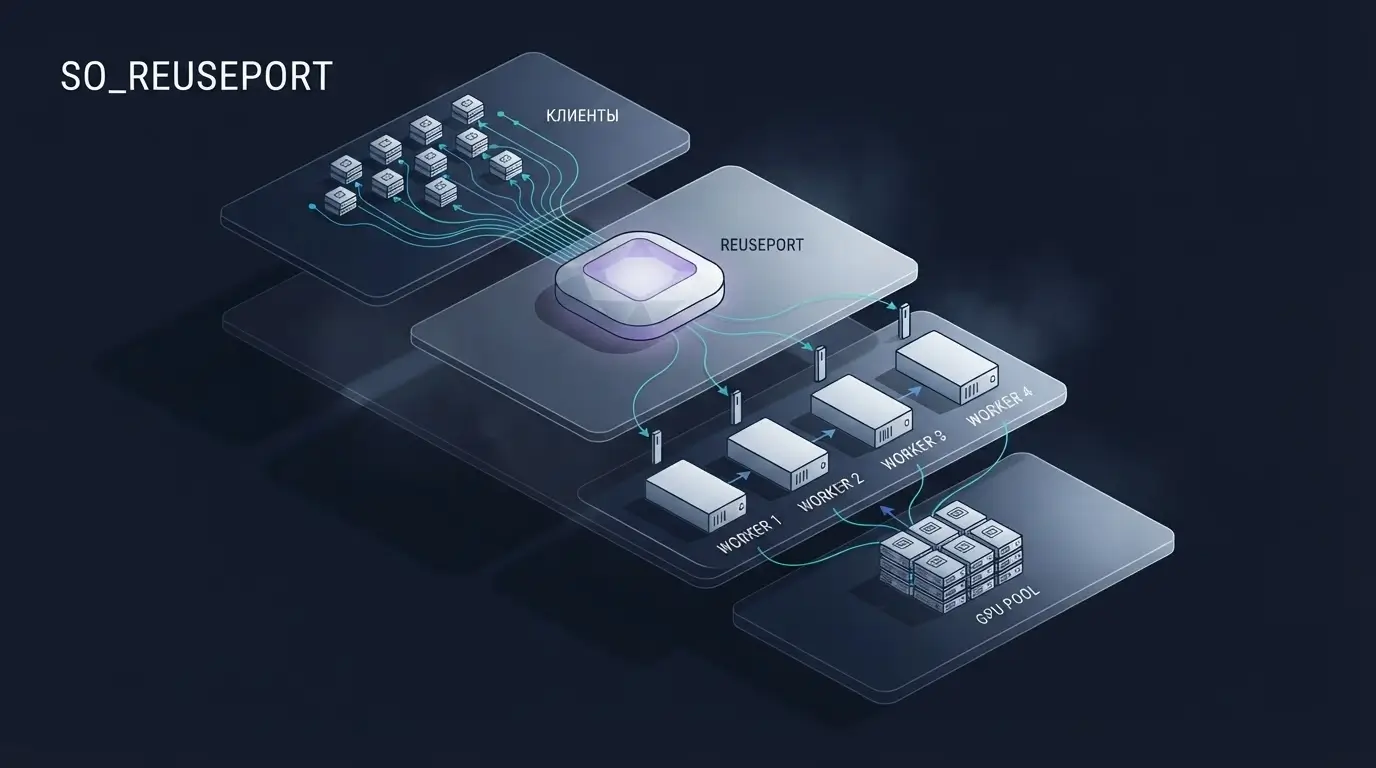
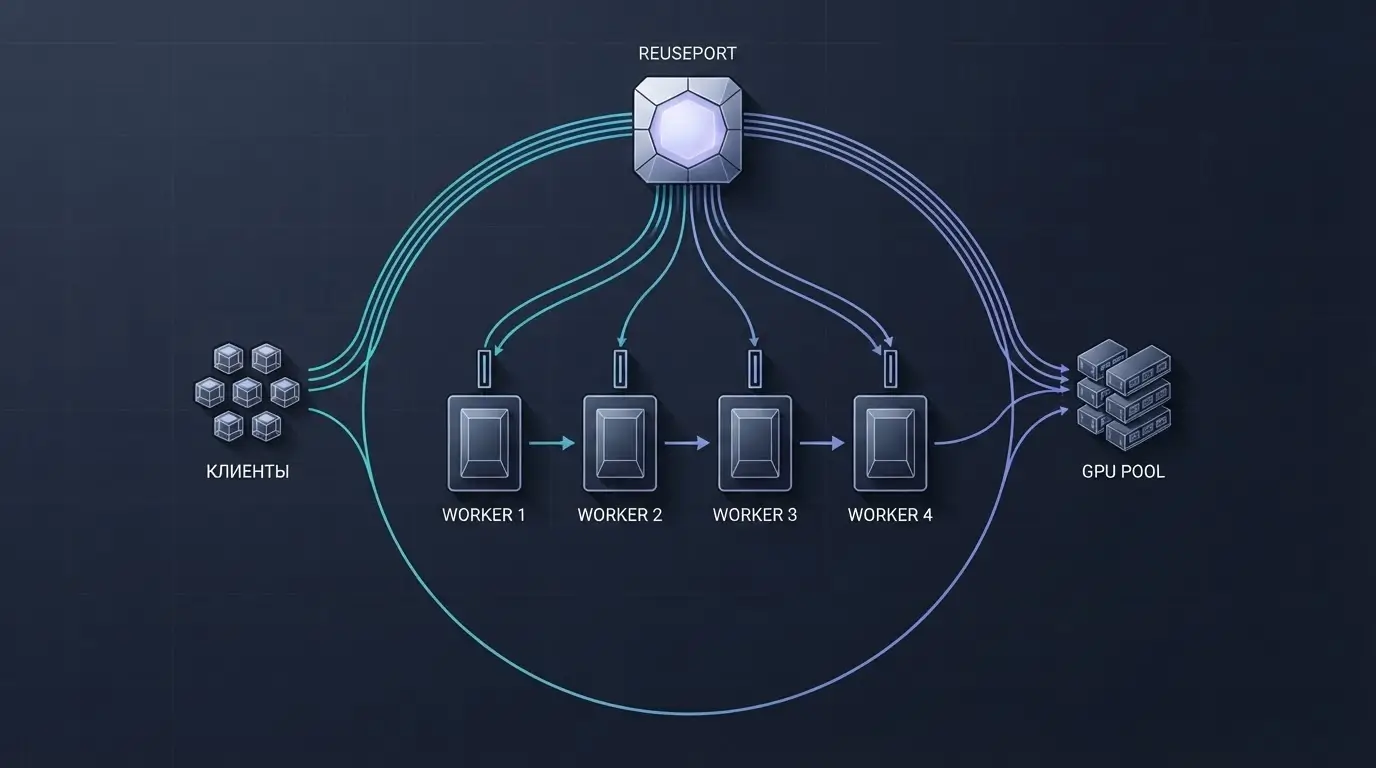
SO_REUSEPORT позволяет нескольким сокетам AF_INET/AF_INET6 привязаться к одному адресу и порту, если опция установлена на каждом сокете до bind(). Для защиты от перехвата порта процессы должны иметь одинаковый effective UID. В TCP-сервисе это даёт каждому worker отдельный listening socket, а ядро распределяет новые соединения внутри reuseport group вместо конкуренции workers за один listener.
Опция существует в Linux с 3.9. Это не synonym для SO_REUSEADDR и не балансировщик GPU-запросов: решение принимается до HTTP-маршрутизации и не знает длину prompt, размер KV cache или состояние upstream. Подробная семантика, включая требования к UID и присоединение BPF-программы, описана в актуальной странице socket(7).
В NGINX параметр reuseport у директивы listen появился в 1.9.1. Он создаёт отдельный listening socket для каждого worker; это документировано в ngx_http_core_module. Выигрыш возможен при высокой цене accept contention или плохом распределении, но не гарантирован: современные ядра и event-механизмы уже уменьшают конкуренцию, а долгоживущие соединения закрепляются за worker и способны оставить дисбаланс выше listener-слоя.
Практический mental model такой: без reuseport есть одна входная дверь и несколько сотрудников за ней; с reuseport у каждого worker своя дверь, а Linux выбирает её для нового flow. Если узкое место находится в коридоре после дверей, новых дверей будет больше, но очередь не исчезнет.
Baseline: доказать listener bottleneck до изменения
Начните с identity: версия ядра, сборка NGINX, число workers, адреса listener и реальный PID каждого процесса. Затем снимите counters до, во время и после воспроизводимого burst. Важны не абсолютные числа из чужого блога, а синхронность: пользовательские ошибки должны совпасть по времени с ростом ListenOverflows/ListenDrops, заполнением очереди и перегрузкой конкретного worker.
ss -lntp показывает listening sockets и backlog, nstat -az помогает увидеть TCP extended counters, а pidstat или cgroup CPU раскрывает асимметрию между workers. Дополните это edge-метриками: accepted connections, active connections, handshake time, connect errors и latency до первого upstream byte. На backend одновременно держите TTFT, queue time и GPU utilization, чтобы не перепутать перенос bottleneck с исправлением.
set -euo pipefail
date -Is
uname -r
nginx -V 2>&1
systemctl show nginx -p MainPID -p ActiveState
ss -lntp '( sport = :443 )'
nstat -az | grep -E 'ListenOverflows|ListenDrops|TCPReqQFull'
pidstat -p ALL -u -w 1 10Не делайте вывод по одному скриншоту. Снимите минимум два окна: спокойный baseline и контролируемый burst тем же типом соединений. Если клиенты обычно держат HTTP/2 или SSE долго, отдельно измерьте cold connection и steady-state stream. Reuseport влияет на выбор listener для новой сессии; он не перераспределяет уже принятую связь между workers.
Добавьте отрицательный контроль. Повторите тот же application probe через уже установленное keepalive-соединение либо напрямую к upstream в закрытой тестовой сети. Если прямой путь тоже деградирует, listener не главный подозреваемый. Если новые соединения ломаются только на edge, а установленные сессии и backend стабильны, гипотеза становится сильнее.
Не увеличивайте somaxconn или backlog «до огромного» одновременно с reuseport. Два изменения лишат вас причинности: станет непонятно, помогло распределение listener или просто более длинная очередь. Меняйте одну переменную и храните исходный конфиг рядом с evidence bundle.
Включение reuseport в NGINX без магии
Для NGINX изменение маленькое, но operational blast radius у него большой: перезагрузка создаёт новый набор listener sockets, а graceful lifecycle должен сохранить активные соединения. Сначала убедитесь, что конфигурация одной address:port пары задаёт socket options согласованно. Документация NGINX предупреждает: дополнительные параметры listen задаются для конкретной пары адреса и порта, а не произвольно в каждом server block.
worker_processes auto;

events {
    worker_connections 8192;
}

http {
    upstream llm_backend {
        keepalive 64;
        server 10.20.0.11:8000;
        server 10.20.0.12:8000;
    }

    server {
        listen 443 ssl reuseport;
        http2 on;
        server_name api.example.internal;

        location /v1/ {
            proxy_http_version 1.1;
            proxy_set_header Connection "";
            proxy_pass http://llm_backend;
        }
    }
}Числа в примере — только синтаксический baseline, не рекомендация для вашего лимита. worker_connections и upstream keepalive должны следовать реальному file descriptor budget, памяти и профилю соединений. Перед reload выполните nginx -t, сохраните PID workers и снимите список listener sockets. После reload проверьте, что для порта действительно появился набор сокетов, а не одна общая запись из-за отличий сборки или платформы.
Canary лучше делать на отдельном edge-узле или изолированном pool с тем же kernel, NIC, IRQ affinity и NGINX build. Так вы сохраняете рабочий baseline и можете вернуть traffic weight без повторного изменения socket group. Если canary живёт на другом типе VM, результат не отвечает на вопрос: различие может быть в steal time, виртуальном NIC или NUMA.
Проверка распределения по workers и application gate
После включения reuseport недостаточно увидеть несколько сокетов. Нужно доказать, что новые соединения распределяются лучше и это влияет на пользовательскую метрику. Соберите accepts или connection counts на PID, CPU time на worker и listen counters в одном временном окне. Если один worker по-прежнему горячий, причиной могут быть долгоживущие соединения, неравномерный hash входных flows, CPU affinity или работа после accept.
Application gate должен повторять production semantics. Для OpenAI-compatible LLM API это POST с реальным режимом streaming, допустимым тестовым prompt и контролируемым числом клиентов. Отдельно измеряйте connection setup и первый chunk; полный response time смешивает listener, очередь модели и длину генерации. Не публикуйте чужие пороги: stop condition задаётся вашим SLO и error budget.
set -euo pipefail
curl --silent --show-error --no-buffer --connect-timeout 3 --max-time 60 --write-out '\nstatus=%{http_code} connect=%{time_connect} tls=%{time_appconnect} first_byte=%{time_starttransfer}\n' --header 'Content-Type: application/json' --data @probe.json https://canary-api.example.internal/v1/chat/completionsПоложительный результат состоит из двух независимых частей. Infrastructure gate: ниже listener drops/overflows и ровнее accepts/CPU между workers. Application gate: при том же workload улучшается или хотя бы не ухудшается connect/first-byte SLO, а backend TTFT и качество ответа остаются сопоставимыми. Если улучшился только kernel counter, пишите «механизм работает», а не «LLM ускорилась».
Обязателен контрфакт: остановите burst новых соединений либо верните canary на конфигурацию без reuseport и проверьте возврат метрик к исходному профилю. Затем ищите migration bottleneck. Например, listener перестал терять SYN, но TLS CPU стал новой границей; или gateway начал принимать больше запросов и переполнил inference queue. Это не провал эксперимента, а честный результат capacity chain.
Когда нужен eBPF steering, а когда он лишний
Базовый reuseport уже выбирает сокет внутри группы. В большинстве gateway этого достаточно для первого эксперимента. Подключать eBPF имеет смысл только после доказанного остаточного перекоса, который коррелирует с CPU/NAPI locality или известным классом flows. Иначе вы меняете простой kernel mechanism на собственный control plane, который надо версионировать, наблюдать и поддерживать в on-call.
Linux поддерживает SO_ATTACH_REUSEPORT_EBPF для TCP с 4.6, а program type BPF_PROG_TYPE_SK_REUSEPORT — с 4.19. Программа может выбрать socket через bpf_sk_select_reuseport; при некорректном индексе для классического варианта ядро откатывается к стандартному selection. Новые sockets группы наследуют программу, а индексы могут меняться при удалении socket, поэтому нельзя кодировать «вечный PID = index» без lifecycle discipline.
Документация Linux по NAPI прямо описывает возможность распределять соединения так, чтобы thread получал пакеты с тем же NAPI ID, но предупреждает о системах с несколькими NIC. Это optimisation для locality, не обязательная часть reuseport. Сначала полезно прочитать общий материал про eBPF в production, а затем решить, готова ли команда владеть verifier errors, pinned maps, privileges и rollback.
set -euo pipefail
bpftool version
bpftool prog show
bpftool map show
bpftool net show
ss -lntp '( sport = :443 )'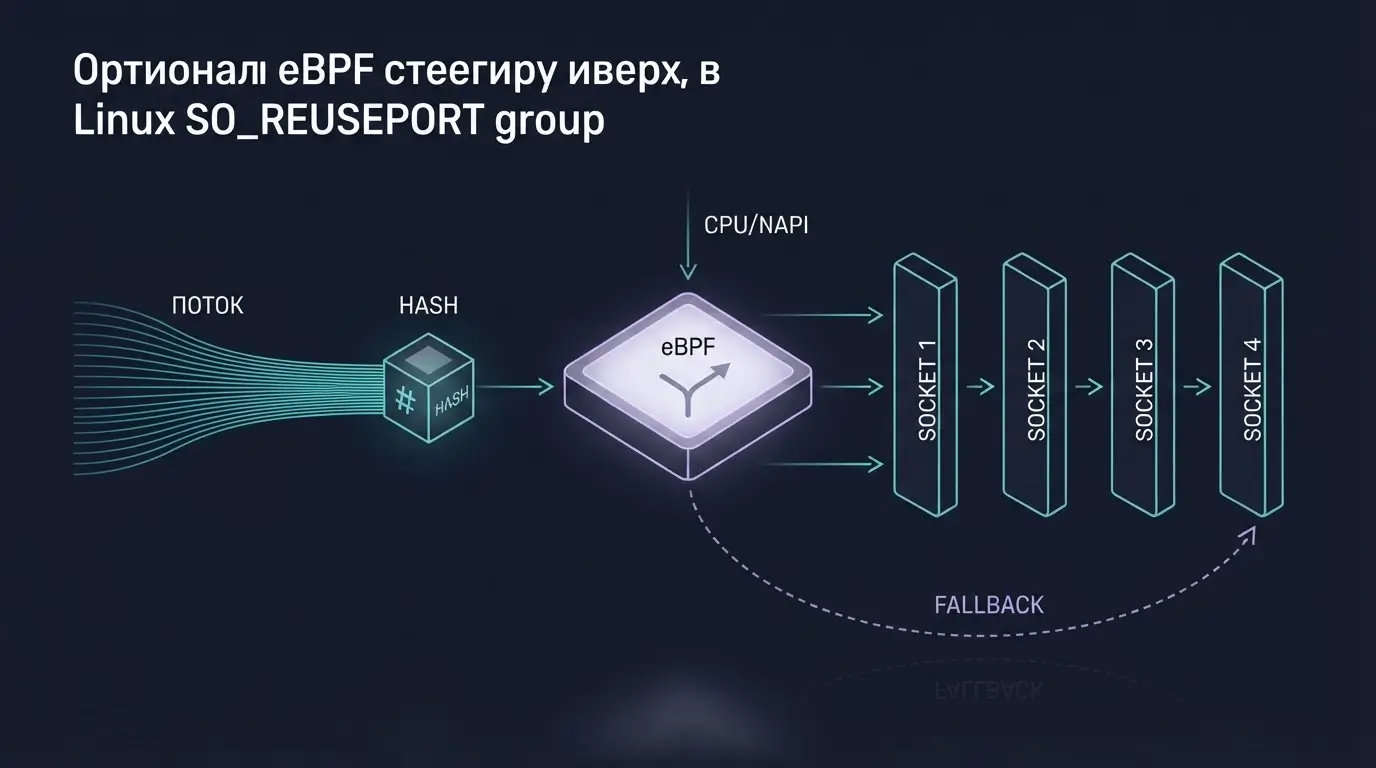
Canary, graceful lifecycle и симметричный rollback
Главный operational risk reuseport — lifecycle группы, а не строка конфигурации. Новый worker должен присоединиться к правильной address:port group, старый — завершить активные соединения, а load balancer — не посылать новый трафик процессу в drain. Для streaming LLM это особенно заметно: короткий HTTP health check может быть зелёным, пока много минут живущая выдача обрывается на reload.
Планируйте rollout ступенями: один canary edge, небольшая доля новых соединений, полное окно наблюдения, затем расширение. Stop conditions включают рост resets, ухудшение connect/first-byte, перекос workers, неожиданный рост TLS CPU, ошибки BPF attach и любое ухудшение завершения stream. У каждого сигнала должен быть owner: network/SRE отвечает за listener и NIC, platform — за NGINX lifecycle, inference — за backend queue и TTFT.
Rollback должен повторять те же gates в обратном порядке. Сначала прекратите новые соединения на canary, дождитесь или ограниченно завершите активные streams, верните конфигурацию без reuseport/BPF, затем тем же probe подтвердите baseline. Простое «nginx reload прошёл» не является восстановлением.
set -euo pipefail
nginx -t
# Сначала снимите canary weight на внешнем LB.
install -m 0644 /etc/nginx/rollback/llm-gateway.conf /etc/nginx/conf.d/llm-gateway.conf
nginx -t
nginx -s reload
ss -lntp '( sport = :443 )'
nstat -az | grep -E 'ListenOverflows|ListenDrops'Если использовался eBPF, отдельно подтвердите detach или замену программы на группе и отсутствие stale pinned objects. Не удаляйте maps до перевода трафика: порядок операций должен быть частью runbook и тестироваться на стенде с той же версией kernel. Наконец, сохраните evidence после rollback. Симметрия до/после защищает от ложной причинности, когда нагрузка просто успела закончиться.
VPS, dedicated edge или managed gateway: решение после доказательства
Инфраструктуру стоит менять только после evidence gate. Если bottleneck исчезает на reuseport canary и текущая VM имеет стабильный CPU budget, достаточные file descriptors и предсказуемый virtual NIC, оставаться на VPS рационально. Масштабирование «потому что LLM» без измерения accept path создаёт расходы, но не причинность.
Dedicated edge оправдан, когда вам нужен контроль над CPU affinity, IRQ/NAPI placement, kernel profile, high-rate connection churn и согласованным change window. Ценность здесь не обещание меньшей latency сама по себе, а воспроизводимый hardware/network baseline и право на rollback. Это естественно дополняет выделенные GPU backends: edge не обязан иметь GPU, зато должен стабильно принимать, шифровать и маршрутизировать трафик.
Managed gateway подходит команде, которая не хочет владеть socket/BPF lifecycle и получает нужные метрики, drain semantics и лимиты от провайдера. Проверьте, раскрывает ли сервис listener drops, распределение connections, policy retries и graceful shutdown; иначе часть пути остаётся чёрным ящиком. Для выбора reverse proxy полезно сравнение Nginx, Caddy и Traefik, но конкретная поддержка reuseport и lifecycle зависит от версии и реализации.
Наконец, оставьте вариант «ничего не менять». Если errors не коррелируют с accept counters, SLO выдержан, а canary не даёт воспроизводимого application effect, лучший результат эксперимента — закрыть гипотезу и инвестировать в реальный bottleneck.
Типичные ошибки и короткий production checklist
Первая ошибка — путать распределение accept с load balancing запросов. Один HTTP/2 connection может нести много streams и остаться у одного worker; reuseport не переместит их по мере роста нагрузки. Вторая — включать одновременно backlog, worker count, reuseport, affinity и TLS changes. Такой rollout может улучшить график, но не оставляет знания о причине.
Третья ошибка — оценивать только среднее. Connection churn часто проявляется в хвостах: p95/p99 connect time, bursts resets и локальном перегреве worker. Смотрите распределения и временную корреляцию. Четвёртая — переходить к eBPF из любопытства, не имея owner для verifier, privileges, maps и kernel upgrade tests. BPF здесь — инструмент тонкой политики, а не знак «современной архитектуры».
Пятая — игнорировать безопасность bind. Процессы группы должны иметь ожидаемый effective UID; capability и systemd socket activation нужно документировать. Если listener создаёт systemd, параметр ReusePort= управляет той же socket option, но ownership сокета и процесса меняет порядок запуска. Проверяйте effective state, а не только конфиг приложения.
- Зафиксировать kernel, gateway build, worker count и listener identity.
- Связать ListenDrops/Overflows с connect/first-byte SLO.
- Провести negative control через established connection или direct upstream.
- Включить только reuseport на изолированном canary.
- Проверить accepts/CPU по workers и backend TTFT.
- Выполнить rollback тем же probe.
- Добавлять eBPF лишь при доказанном остаточном перекосе.
Проверяли ли вы, что после «успешного» socket tuning не выросла очередь inference? Это последний обязательный вопрос перед расширением rollout. Capacity chain всегда ищет следующий самый узкий слой.
Вывод: сначала доказательство, потом socket tuning
SO_REUSEPORT полезен не потому, что у сервиса много соединений, а когда доказан конкретный listener bottleneck: новые TCP-сессии теряются или задерживаются, workers принимают их неравномерно, а inference backend сохраняет свой SLO. В таком случае отдельный socket на worker даёт проверяемый механизм распределения и относительно небольшой шаг rollout.
Правильный порядок сохраняет причинность: собрать baseline, включить reuseport на canary, разделить infrastructure и application gates, выполнить отрицательный контроль и симметричный rollback. eBPF steering оставьте вторым этапом для подтверждённой задачи locality; это новая operational dependency, а не обязательное продолжение.
Следующий практический шаг — взять один production-shaped burst, сохранить evidence bundle и прогнать checklist на отдельном edge. Если выяснится, что нужен стабильный CPU/NIC profile и контроль kernel lifecycle, тестируйте его на выделенном узле с тем же gateway build и заранее готовым возвратом. Так решение об инфраструктуре опирается на измеренный путь запроса, а не на красивую настройку.