Оглавление
- Когда «зависший» LLM-стрим остаётся живым TCP-соединением
- Четыре таймера, которые нельзя смешивать
- Что именно делает TCP_USER_TIMEOUT в Linux
- Evidence gate: доказать unacked path, а не гадать по latency
- Baseline до изменения: owner, SLO и безопасные границы
- Canary: positive gate, negative control и контрфакт
- Почему proxy timeout и retries могут скрыть результат
- Rollout по профилям пути, а не одним числом на весь флот
- Decision helper: когда менять таймер, приложение или инфраструктуру
- Частые ошибки и stop conditions
- Вывод: таймаут должен завершать доказанно бесполезную работу
Готовы перейти на современную серверную инфраструктуру?
В King Servers мы предлагаем серверы как на AMD EPYC, так и на Intel Xeon, с гибкими конфигурациями под любые задачи — от виртуализации и веб-хостинга до S3-хранилищ и кластеров хранения данных.
- S3-совместимое хранилище для резервных копий
- Панель управления, API, масштабируемость
- Поддержку 24/7 и помощь в выборе конфигурации
Результат регистрации
...
Создайте аккаунт
Быстрая регистрация для доступа к инфраструктуре
Когда «зависший» LLM-стрим остаётся живым TCP-соединением
Клиент перестал получать токены, но API gateway всё ещё держит соединение, GPU продолжает считать, а в логах нет ни FIN, ни RST. Через несколько минут пользователь уже повторил запрос, очередь стала длиннее, а старый inference всё ещё расходует память и вычислительное время. Это типичный разрыв между состоянием приложения и состоянием TCP: для ядра сокет может оставаться ESTABLISHED, хотя end-to-end путь фактически исчез.
Угол этой статьи узкий: мы разбираем TCP_USER_TIMEOUT в Linux и только тот случай, когда отправленные данные не подтверждаются ACK либо не могут быть переданы из-за нулевого окна. Это не новая версия материала про HTTP/2 GOAWAY и gRPC keepalive, не настройка очередей из статьи про BBR и fq и не общий proxy tuning. Наша задача — доказать half-open path, выбрать границу fail-fast и проверить её canary без обещаний «ускорить LLM».
Сразу обозначим disqualifier. Если сокет ничего не отправляет, unacked не растёт, а backend просто долго формирует первый токен, TCP_USER_TIMEOUT не поможет. То же верно, когда проблему создают buffering, application deadline, исчерпанная GPU-очередь или ошибочные retries. Сначала нужна атрибуция, потом настройка.
Характерный пример: пользователь едет между сетями, NAT-состояние исчезает, но gateway уже отправил очередную порцию SSE-данных. Backend не знает, что клиент потерян; TCP повторяет сегменты, а бизнес-таймер в клиенте запускает новый запрос. Без связи между socket tuple, request_id и generation_id команда видит только рост нагрузки и ошибочно масштабирует GPU. Поэтому первичная цель — вернуть причинную цепочку, а не подобрать «магическое» число миллисекунд.
Четыре таймера, которые нельзя смешивать
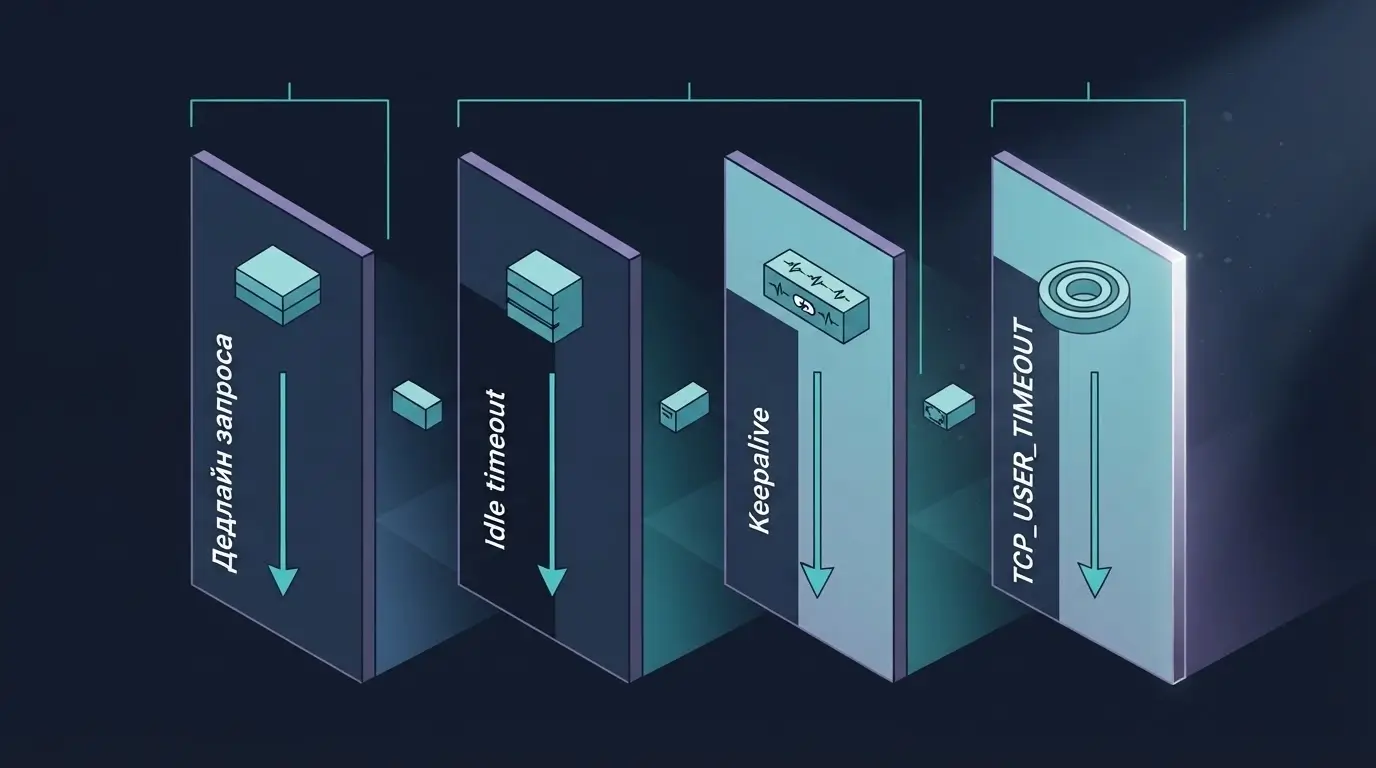
У production-запроса как минимум четыре разных часовщика. Application deadline отвечает за бизнес-границу: сколько пользователь готов ждать полный ответ или следующий токен. Proxy read timeout контролирует паузу между операциями чтения. TCP keepalive проверяет давно бездействующий путь специальными пробами. TCP_USER_TIMEOUT ограничивает время, в течение которого уже переданные данные остаются неподтверждёнными или застревают при zero window.
Согласно Linux tcp(7), значение задаётся в миллисекундах, действует в синхронизированных состояниях TCP и при истечении возвращает приложению ETIMEDOUT. Параметр не меняет момент retransmission и не определяет отправку keepalive-проб. Если одновременно включён SO_KEEPALIVE, именно TCP_USER_TIMEOUT определяет, когда закрыть соединение после keepalive failure.
У NGINX proxy_read_timeout измеряется между двумя последовательными чтениями от upstream, а не для всего ответа. Поэтому поток с редкими токенами может упасть по read timeout при полностью здоровом TCP, а поток с unacked данными может долго оставаться живым несмотря на щедрый proxy timeout. В runbook эти сигналы должны храниться отдельно.
Практически полезно назначить owner каждому таймеру. Product/application owner отвечает за deadline и семантику отмены; platform owner — за proxy timeouts, retries и connection pool; network owner — за путь и packet evidence; runtime owner — за создание сокета и effective options. Если один и тот же параметр меняют две команды, rollback становится недостоверным. Карта ownership должна быть частью change request и incident timeline.
Что именно делает TCP_USER_TIMEOUT в Linux
Локальный socket option принимает беззнаковое число миллисекунд. Ноль означает использование системного поведения. Опция появилась в Linux 2.6.37 и может устанавливаться в любой момент жизни соединения, хотя влияет только на синхронизированные состояния. Если задать её на listening socket, принятые через accept() сокеты наследуют значение — это удобно для gateway, но увеличивает blast radius ошибки.
Важно не путать локальный socket option с TCP User Timeout Option из RFC 5482. RFC описывает возможность сообщить peer рекомендуемый timeout, но это не обязательное двустороннее соглашение. В Linux практическая ценность setsockopt(TCP_USER_TIMEOUT) прежде всего локальная: процесс сам ограничивает, сколько готов держать неподтверждённые данные.
Слишком короткое окно опасно на высокозадержанных, мобильных и временно перегруженных путях: ACK может прийти позже выбранной границы, и здоровое соединение будет оборвано. Слишком длинное окно сохраняет состояние и занятый inference дольше, чем полезно пользователю. Поэтому значение выводят из пользовательского deadline, измеренного RTT/RTO, допустимого recovery window и retry budget, а не копируют из чужого конфигурационного файла.
Нулевая receive window — отдельный важный сценарий. Peer может оставаться доступным и подтверждать пакеты, но сообщить, что временно не принимает новые данные; приложение на отправителе будет накапливать buffered data. Linux учитывает и эту ситуацию. Поэтому packet trace нужно читать вместе с window advertisements: отсутствие прогресса не всегда означает потерю маршрута. Слишком агрессивный timeout способен оборвать медленного, но исправного потребителя.
Системный default тоже важно понимать, но не подменять им измерение. tcp_retries2 задаёт число retransmission-моментов для живого соединения, причём effective wall-clock зависит от RTO и backoff; документация ядра прямо предупреждает о связи с tcp_rto_max_ms. Поэтому пересчёт «15 ретраев равно столько-то минут» нельзя переносить на каждый production path. Per-socket timeout выражает бизнес-граничное время точнее, но только для outstanding data и только в реализации, которая действительно ставит option.
Версионный статус здесь стабилен: TCP_USER_TIMEOUT существует в Linux много лет, однако поддержка в языковом runtime, reverse proxy или service mesh различается. Проверяйте документацию и effective state конкретной сборки. Наличие похожего поля в конфигурации не гарантирует, что оно применяется к нужному плечу соединения; source code, getsockopt, eBPF trace или controlled failure дают более сильное доказательство.
import socket

def connect_with_user_timeout(host: str, port: int, timeout_ms: int):
    sock = socket.create_connection((host, port), timeout=5)
    sock.setsockopt(socket.IPPROTO_TCP, socket.TCP_USER_TIMEOUT, timeout_ms)
    actual = sock.getsockopt(socket.IPPROTO_TCP, socket.TCP_USER_TIMEOUT)
    if actual != timeout_ms:
        sock.close()
        raise RuntimeError(f"TCP_USER_TIMEOUT mismatch: {actual}")
return sockEvidence gate: доказать unacked path, а не гадать по latency
Начните с конкретного соединения и stable identity процесса. Нужны namespace, PID, локальный и удалённый адрес, transport protocol и роль: client-facing socket или upstream к inference backend. Снимок «на узле много retransmissions» слишком широкий: он не говорит, затронут ли поток пользователя и какой процесс владеет сокетом.
ss -tinp показывает расширенную TCP-информацию, включая retransmission timer, congestion state и счётчики конкретного сокета. Снимайте её серией, потому что один кадр не отличает краткий loss от устойчивого black hole. Рядом сохраняйте nstat, packet capture на разрешённом canary-пути и application trace: время первого токена, межтокенные паузы, статус завершения и отменил ли клиент запрос.
Infrastructure gate считается пройденным, когда на одном и том же tuple видны отправленные данные, отсутствие ACK и рост retransmission/возраста unacked состояния. Application gate требует, чтобы именно этот request_id перестал доставлять токены, но backend ещё не получил отмену. Отрицательный контроль — соседнее соединение через здоровый path с тем же профилем запроса.
Проверяйте направление. Для client-facing SSE gateway обычно отправляет большую часть данных, поэтому ACK loss виден на gateway. Для upstream RPC роли могут отличаться: gateway отправил небольшой request, а backend возвращает длинный stream. Снимайте evidence на стороне, у которой есть outstanding data. Симметричная проверка двух концов помогает отличить локальную очередь, middlebox и исчезнувший peer, но отсутствие доступа к клиенту не отменяет локальный per-socket proof.
# Выполняйте в effective network namespace процесса gateway
ss -tinp '( dport = :443 or sport = :443 )'
nstat -az | grep -E 'TcpRetransSegs|TcpTimeouts|TcpExtTCPAbortOnTimeout'

# Повторите снимок и сопоставьте tuple с request_id в access/trace log
date -Ins
ss -tinp dst 203.0.113.10:443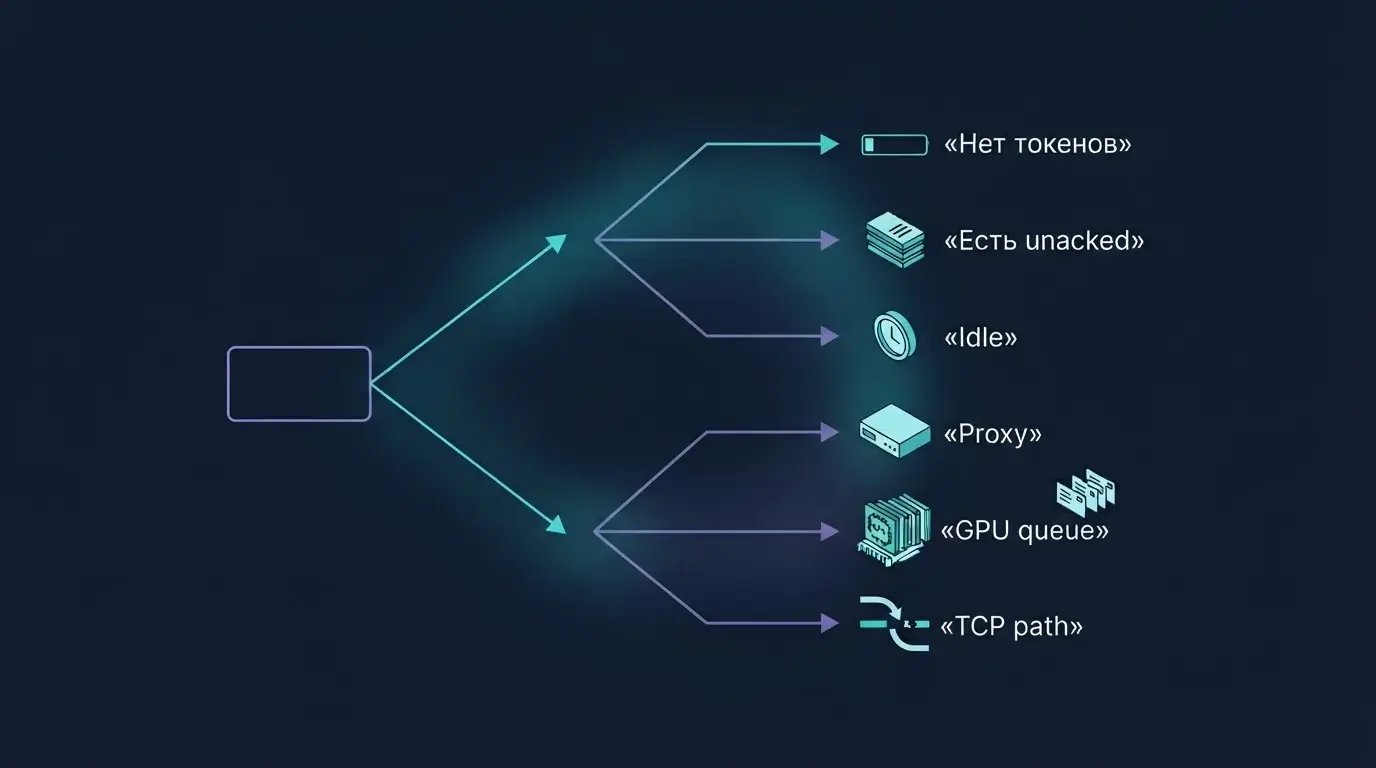
Baseline до изменения: owner, SLO и безопасные границы
До первой настройки зафиксируйте versioned evidence bundle. В него входят версия ядра, iproute2, runtime gateway, способ создания сокета, effective network namespace, значения keepalive, application deadline, proxy timeout и retry policy. Это защищает от ложной причинности: после деплоя вместе с socket option часто меняются библиотека, образ, маршрутизация или пул соединений.
Отдельно запишите три временные границы. Первая — пользовательский deadline: после неё ответ уже не имеет бизнес-ценности. Вторая — server cancellation window: когда backend гарантированно прекращает генерацию после disconnect. Третья — допустимое network recovery window для реальных клиентов. TCP_USER_TIMEOUT должен согласовываться с ними, но универсальной формулы нет: профиль корпоративной LAN, межрегионального WAN и мобильного клиента различается.
Не начинайте с глобального изменения net.ipv4.tcp_retries2. Документация Linux IP sysctl показывает, что этот параметр влияет на живые соединения во всей системе и связан с RTO. Для проверки гипотезы безопаснее per-socket option на canary-процессе: blast radius меньше, owner очевиден, rollback не затрагивает соседние сервисы.
Baseline должен охватывать хотя бы одно обычное окно и один пик. Таймер, выбранный по спокойной лаборатории, может обрывать соединения при допустимой очереди в час нагрузки. Вместо среднего используйте распределения: RTT/RTO, длительность unacked эпизодов, inter-token gaps и cancellation latency. Значение socket option документируйте как гипотезу для конкретного path class, а не как постоянный стандарт всей компании.
Canary: positive gate, negative control и контрфакт
Canary должен воспроизводить именно потерю подтверждений после установления соединения. Обычное «выключить backend» часто отправляет FIN/RST и проверяет совсем другой failure mode. Нужен изолированный client/gateway pair, где firewall или traffic control отбрасывает return ACK path для уже существующего потока. Никогда не применяйте такой эксперимент к production-интерфейсу или общему namespace.
Positive gate: после появления unacked данных сокет закрывается в ожидаемом окне, приложение получает наблюдаемую ошибку, request cancellation доходит до backend, а повтор не запускается без idempotency/budget проверки. Negative control: тот же canary выдерживает обычную паузу генерации без unacked данных и не рвёт поток только потому, что токенов некоторое время нет.
Контрфакт обязателен. Уберите fault injection и верните socket profile к baseline, затем повторите тот же запрос. Если завершение по таймауту осталось, причина не в TCP_USER_TIMEOUT или эксперимент изменил больше одной переменной. Если kernel counter улучшился, но пользовательский completion rate не изменился, доказан механизм, а не коммерческий эффект.
Fault injection должен быть узким и проверяемым. Зафиксируйте правило, namespace, interface, tuple и время начала; вторым оператором подтвердите, что production route не затронут. Перед тестом убедитесь, что запрос синтетический и не содержит пользовательских данных. После теста проверьте отсутствие qdisc/firewall rule, пустой список canary-сокетов и возврат метрик к baseline. Эти шаги делают эксперимент эксплуатационно безопасным.
# Только в заранее подготовленном изолированном canary namespace.
# veth-canary не должен обслуживать production-трафик.
ip netns exec ks-canary tc qdisc replace dev veth-canary root netem loss 100%

# Наблюдайте существующий поток и ожидайте ETIMEDOUT в приложении.
ip netns exec ks-canary ss -tinp

# Rollback fault injection.
ip netns exec ks-canary tc qdisc del dev veth-canary root
Почему proxy timeout и retries могут скрыть результат
Даже правильный socket timeout бесполезен, если верхний слой превращает его в retry storm. Для streaming-ответа повтор после частичной выдачи токенов часто не является безопасным: клиент уже увидел часть текста, а новый backend снова расходует GPU. Gateway должен знать, был ли response body начат, поддерживает ли операция idempotency key и остался ли retry budget.
Проверьте оба плеча отдельно: client → gateway и gateway → inference backend. TCP_USER_TIMEOUT на upstream socket не управляет клиентским соединением, а опция на client-facing socket не отменяет зависший backend request автоматически. Между ними нужен явный cancellation path. В противном случае gateway быстро освободит один сокет, но GPU продолжит генерацию, и capacity не вернётся.
Соседний материал про Envoy под перегрузкой LLM API полезен для circuit breakers и backpressure; здесь же stop condition другая: не расширяйте rollout, пока ошибка transport layer не связана с отменой конкретного inference и пользовательским outcome. Новый таймаут без cancellation и observability лишь делает потерю работы быстрее.
Особенно опасны промежуточные connection pools. Новый пользовательский запрос может получить давно открытый upstream socket с другим effective profile, а после reload часть соединений останется на старом значении. В canary помечайте соединения по времени создания и принудительно разделяйте пулы, иначе сравнение смешает baseline и treatment. После rollout проверяйте не только конфигурацию процесса, но и option на реально созданных сокетах.
Rollout по профилям пути, а не одним числом на весь флот
Разделите трафик по реальным классам: внутренний east-west, корпоративный VPN, межрегиональный WAN, публичный интернет и мобильные клиенты. Начните с класса, где RTT и ownership наиболее стабильны. Один процент canary соединений на выделенном gateway лучше, чем системный sysctl на всём пуле: вы видите effective option и можете вернуть старый профиль без рестарта всей платформы.
Наблюдайте не только число ETIMEDOUT. Минимальный набор включает completion rate, user cancellations, TTFT, inter-token gap, retransmissions, unacked duration, backend cancellation latency, повторные запросы и GPU active time после client disconnect. Stop condition: растёт доля ложных abort на здоровом path, ухудшается completion rate либо retries добавляют больше GPU-работы, чем освобождает fail-fast.
На выделенном сервере или отдельном network edge проще закрепить kernel/runtime profile, проводить controlled fault injection и хранить packet evidence. Но dedicated-инфраструктура — не лечение сама по себе. Она полезна только после path proof, когда ценность состоит в ownership над ядром, маршрутом, rollout window и rollback. Ошибочный application deadline, stale connection pool или backend queue новый сервер не исправит.
Расширяйте rollout ступенями и сохраняйте одинаковое окно наблюдения. Сначала synthetic traffic, затем внутренние клиенты, после этого небольшой процент внешнего path class. На каждой ступени одинаковы запрос, модель, лимит токенов и retry policy. Изменение модели или batching одновременно с network profile разрушает эксперимент. Решение о расширении принимает owner по заранее записанным stop conditions, а не по визуальному впечатлению от графика.
Для on-call добавьте timeout source в structured log: application deadline, proxy read timeout, TCP user timeout, peer reset или client cancel. Лог должен содержать request_id, generation_id, socket tuple и число уже выданных токенов, но не prompt и не чувствительные данные. Тогда один график ответит на два вопроса: освободили ли мы бесполезную capacity и не увеличили ли долю обрывов полезных ответов. Без такого различения рост ETIMEDOUT после rollout ожидаем, но сам по себе ничего не говорит о качестве решения.
# Псевдокод rollout-политики: значения приходят из versioned profile.
profile = path_profile(request.client_class)
sock.setsockopt(socket.IPPROTO_TCP, socket.TCP_USER_TIMEOUT, profile.user_timeout_ms)

metrics.label(
    path_class=profile.name,
    socket_owner="llm-gateway",
    timeout_source="tcp_user_timeout",
).observe(1)
Decision helper: когда менять таймер, приложение или инфраструктуру
Если токены не идут, но unacked=0 и retransmissions не растут, TCP_USER_TIMEOUT не является рабочей гипотезой. Смотрите GPU scheduler, batching, KV cache pressure, proxy buffering и application heartbeat. Если unacked растёт только на одном маршруте, сравните next hop, MTU, firewall и connection tracking, прежде чем менять сервер.
Если одинаковый ACK failure воспроизводится на разных клиентах за одним gateway, per-socket timeout может быть разумной защитой capacity. Сначала задайте его в приложении, подтвердите effective state через getsockopt, затем свяжите ETIMEDOUT с cancellation. Если runtime не позволяет управлять socket option, рассмотрите sidecar или gateway, который действительно владеет сокетом; не имитируйте эффект чрезмерно коротким proxy timeout.
Procurement default прост: не меняйте платформу до доказанного TCP-path failure. VPS подходит для отдельного контролируемого edge с небольшим blast radius; dedicated gateway полезен, когда нужны предсказуемый kernel profile, capture, routing ownership и изолированное окно изменений. Решение принимается по воспроизводимости и SLO, а не по обещанию меньшей latency.
При выборе площадки сравнивайте контрольные границы. В managed gateway часть socket options или packet capture может быть недоступна; на VPS вы управляете гостевым ядром, но не физическим маршрутом; на dedicated edge доступны стабильный NIC/kernel profile и изолированный drain. Ни один вариант не гарантирует лучший outcome автоматически. Покупательский критерий — способен ли выбранный контур воспроизвести canary, показать evidence и выполнить rollback в пределах вашего SLO.
Частые ошибки и stop conditions
Ошибка 1: считать любой молчащий поток half-open. Пока приложение не отправило данные, ACK нечего подтверждать. Нужны unacked/retrans evidence и конкретный tuple.
Ошибка 2: ставить timeout короче нормального recovery window. Мобильный handover, временный queueing и высокий RTT превращаются в ложные abort. Canary должен включать худшие допустимые, но здоровые пути.
Ошибка 3: менять глобальный sysctl ради одного сервиса. Это расширяет blast radius и усложняет attribution. Сначала per-socket profile, stable owner и обратимый rollout.
Ошибка 4: забыть про повторную GPU-работу. Быстрый ETIMEDOUT плюс безусловный retry может удвоить нагрузку. Нужны idempotency, retry budget и запрет повтора после частичной выдачи.
Ошибка 5: принимать kernel improvement за пользовательский результат. Меньше долгоживущих сокетов — полезный механизм, но успех статьи измеряется completion rate, отменой backend и сохранённым SLO. Если application outcome не меняется, не продавайте настройку как ускорение.
Остановите rollout, если нет отрицательного контроля, fault injection затрагивает общий path, runtime не подтверждает effective option, отсутствует backend cancellation либо observability не различает application, proxy и kernel timeout. Эти условия важнее красивого графика retransmissions.
Ошибка 6: забыть о long-poll и больших паузах между токенами. TCP_USER_TIMEOUT не должен имитировать heartbeat. Если приложению нужно обнаруживать логически «молчащий» stream без outstanding data, используйте протокольный heartbeat или application deadline. Смешивание этих задач делает инцидент неразличимым: одинаковый ETIMEDOUT начинают трактовать и как network failure, и как медленную генерацию.
Вывод: таймаут должен завершать доказанно бесполезную работу
TCP_USER_TIMEOUT полезен для LLM streaming не потому, что «TCP слишком медленный», а потому, что живой с точки зрения ядра сокет может удерживать уже бесполезную inference-работу. Правильный runbook связывает один и тот же запрос через четыре слоя: unacked TCP state, наблюдаемую ошибку процесса, отмену backend и пользовательский outcome.
Начните со снимка ss -tinp и application trace, отделите idle от unacked, затем воспроизведите ACK black hole на изолированном canary. Установите per-socket option, проверьте его через getsockopt, выполните positive и negative control, а после rollback повторите те же probes. Только так можно говорить о причинности.
Практический следующий шаг — собрать baseline для одного path class и одного gateway-процесса. Если выяснится, что вам нужен отдельный управляемый edge с фиксированным kernel profile, трассировкой и безопасным окном изменений, инфраструктуру можно подобрать под доказанные требования. Если evidence указывает на приложение или GPU queue, исправьте этот слой и сохраните сеть без лишнего тюнинга.