Оглавление
- Быстрый вывод: большой buffer не равен быстрому streaming
- Как данные проходят через rmem, приложение и wmem
- Снимите baseline: sysctl, socket memory и TCP_INFO
- Как читать ss -tinm без ложных выводов
- Autotuning и bandwidth-delay product: когда потолок действительно мал
- Memory pressure: почему большие maxima могут ухудшить инцидент
- Отделите TCP от proxy buffering и application backpressure
- Kubernetes: Pod sysctl, hostNetwork и граница ответственности
- Canary и rollback: меняйте один owner за раз
- Когда оставить autotuning, настроить socket или масштабировать gateway
- Production-runbook: от симптома до проверенного исправления
- Итог: буфер должен подтверждать поток, а не скрывать очередь
Готовы перейти на современную серверную инфраструктуру?
В King Servers мы предлагаем серверы как на AMD EPYC, так и на Intel Xeon, с гибкими конфигурациями под любые задачи — от виртуализации и веб-хостинга до S3-хранилищ и кластеров хранения данных.
- S3-совместимое хранилище для резервных копий
- Панель управления, API, масштабируемость
- Поддержку 24/7 и помощь в выборе конфигурации
Результат регистрации
...
Создайте аккаунт
Быстрая регистрация для доступа к инфраструктуре
Быстрый вывод: большой buffer не равен быстрому streaming
У TCP-буферов простая задача: сгладить разницу между скоростью сети и темпом, с которым приложение читает или пишет данные. У LLM API эта разница особенно заметна. Запрос может быть коротким, а ответ живёт десятки секунд; токены идут маленькими порциями, клиент читает их неравномерно, gateway параллельно обслуживает тысячи таких потоков. Поэтому один и тот же симптом — пауза в выдаче — появляется и при тесном receive window, и при медленном клиенте, и при остановившемся event loop.
Главное правило: не начинайте с увеличения tcp_rmem и tcp_wmem. Сначала докажите, что ограничение находится в socket memory и влияет на пользовательский outcome: time to first token, межтокенные паузы, долю оборванных streams или успешное завершение ответа. Если сокет свободен, а очередь inference растёт, новый sysctl только увеличит доступный запас памяти.
Практический default — сохранить autotuning, собрать данные на конкретных соединениях и изменить один слой на canary. Ручной размер полезен лишь после локализации владельца. Для gateway на VPS или выделенном сервере коммерческая ценность железа начинается не с «больше RAM», а с воспроизводимого kernel/NIC baseline, контролируемого лимита соединений и понятного rollback.
Как данные проходят через rmem, приложение и wmem
Входящий пакет сначала проходит NIC и сетевой стек, затем полезные данные оказываются в receive buffer сокета. Пока приложение не вызвало чтение, память остаётся занятой, а TCP регулирует advertised window. На исходящем направлении приложение записывает данные в socket; часть ещё ждёт передачи или подтверждения peer. Это не единая «сетевая очередь», а несколько состояний с разными владельцами.
tcp_rmem и tcp_wmem задают тройки min/default/max для автоматического подбора. По актуальной документации Linux kernel, receive autotuning ограничивается максимумом tcp_rmem[2]; явный SO_RCVBUF для конкретного сокета отключает autotuning его receive buffer. Это важная ловушка: «точечная оптимизация» в библиотеке может незаметно отменить более разумное поведение ядра.
Представьте медленного SSE-клиента. Gateway получает токены от backend быстро, но браузер или корпоративный proxy читает ответ рывками. Растёт очередь отправки downstream-сокета. Увеличив wmem, вы не ускорите клиента — лишь разрешите gateway дольше хранить его отставание. Поэтому направление потока и конкретный socket owner важнее среднего числа байтов на хосте.
Снимите baseline: sysctl, socket memory и TCP_INFO
Начните с неизменяемого снимка. Нужны значения sysctl, число соединений, распределение RTT, retransmissions и память конкретных сокетов. Команда ss -tinm удобна тем, что объединяет TCP internal info и skmem. В выводе rb и tb означают доступные receive/send limits, r — занятую receive memory, w — queued send memory, bl — socket backlog, d — drops. Эти поля описаны в ss(8).
Не снимайте один «красивый» сокет. Возьмите выборку здоровых и проблемных streams на одном route, с сопоставимым размером prompt и моделью. Если у зависших соединений стабильно заполнен wmem_queued, а у контрольных нет, появляется рабочая гипотеза. Если различий нет, TCP buffer пока остаётся отрицательным контролем.
sysctl net.ipv4.tcp_moderate_rcvbuf \
       net.ipv4.tcp_rmem net.ipv4.tcp_wmem \
       net.core.rmem_max net.core.wmem_max
ss -tinm state established '( sport = :443 )'
nstat -az | egrep 'TcpRetransSegs|TcpExtTCPRcvQDrop|TcpExtTCPMemoryPressures'
cat /proc/net/sockstatСопоставляйте socket evidence со временем на уровне приложения. Для LLM streaming полезно логировать accept time, отправку upstream, первый байт от inference backend, первый байт клиенту и завершение response. Так видно, образовалась пауза до модели, внутри proxy или уже на downstream. Без этой временной линии заполненный buffer легко принять за причину, хотя он лишь следствие остановившегося consumer.
Как читать ss -tinm без ложных выводов
Одно высокое значение rb не доказывает проблему: это capacity, а не фактическая очередь. Смотрите пары. Если r приближается к rb и одновременно приложение редко читает, причина, вероятно, в scheduler, блокирующем фильтре или CPU throttling. Если w растёт рядом с ухудшением delivery rate, исследуйте peer и путь ACK. Если d меняется, локализуйте drops до изменения лимитов.
Поля cwnd, rtt, rto, delivery rate и retransmissions отвечают на другой вопрос: способен ли путь унести данные. Маленький congestion window после loss не лечится большим wmem. Точно так же большое bandwidth-delay product может требовать достаточного window, но для токенов по несколько десятков байтов throughput редко является единственной границей. Проверьте это фактом, а не предположением.
Типичная ловушка — агрегировать все соединения к одному среднему. Один медленный клиент может держать мегабайты очереди, пока тысячи streams здоровы. Группируйте по route, ASN или классу клиента, версии gateway и backend pool. В инциденте спросите: «Это один socket с необычным peer или весь canary-процесс?» Ответ определяет, нужен ли сетевой fix, ограничение per-connection или изоляция медленных потребителей.
Autotuning и bandwidth-delay product: когда потолок действительно мал
Receive autotuning пытается подобрать окно под путь, не превышая tcp_rmem[2]. Для bulk transfer ориентиром служит bandwidth-delay product: сколько данных должно находиться «в полёте», чтобы канал не простаивал. Но LLM streaming не похож на непрерывную передачу большого файла. После первого токена приложение часто выдаёт небольшие chunks, поэтому ограничителем становятся scheduling, flush semantics, proxy buffering или медленный consumer.
Проверка должна разделять режимы. Возьмите один и тот же gateway и сравните небольшой streaming response, длинный ответ и контролируемую bulk-передачу по тому же пути. Если только bulk упирается в окно, а межтокенные паузы одинаковы, увеличение TCP max не исправит LLM latency. Если и stream на большом RTT показывает закрывающееся receive window, причина выглядит убедительнее.
Не копируйте sysctl из чужого benchmark. Значения зависят от RAM, concurrency, kernel, приложения и того, выставляет ли библиотека собственные socket options. tcp(7) также напоминает, что kernel учитывает служебный overhead и может показывать размер, отличающийся от запрошенного через setsockopt(). План capacity должен опираться на фактический skmem, а не на умножение max на число соединений как на гарантированное выделение.
Memory pressure: почему большие maxima могут ухудшить инцидент
Maxima — не бесплатный резерв. Ядро выделяет socket memory по потребности, однако при тысячах долгоживущих соединений совокупный рост становится заметным. tcp_mem задаёт системные пороги в страницах памяти; при pressure TCP начинает умерять потребление. Одновременно процесс gateway держит userspace buffers, TLS state, HTTP/2 streams и очереди фильтров. В контейнере всё это конкурирует внутри memory limit.
Плохой сценарий выглядит так: команда увеличивает tcp_rmem[2] и tcp_wmem[2], streams переживают более долгие паузы клиентов, RSS процесса растёт, Pod попадает под memory pressure, event loop получает меньше CPU или контейнер завершается по OOM. На графике сеть сначала кажется стабильнее, но application outcome становится хуже. Поэтому canary обязан включать socket memory, RSS/cgroup memory, CPU throttling и завершение streams.
Поставьте budget, а не «большое значение». Например, определите допустимую память gateway при целевой concurrency и abort criterion по working set. Число берите из собственного canary, а не из статьи. Если медленные клиенты способны удерживать буферы бесконечно, добавьте backpressure, per-connection limits и timeout policy на уровне приложения. Выделенный сервер даёт более предсказуемый запас и kernel baseline, но не отменяет необходимость ограничивать очередь.
Отделите TCP от proxy buffering и application backpressure
Между inference backend и клиентом обычно есть несколько буферов: библиотека HTTP, TLS record layer, reverse proxy, L7-фильтры и TCP. NGINX при включённом proxy_buffering читает ответ upstream как можно быстрее и сохраняет его в настроенных buffers; для streaming route это может менять видимую клиенту подачу. Envoy отдельно управляет L4/L7 limits и HTTP/2 flow control. Увеличение kernel buffers не отменяет паузу фильтра, которому нужен полный body.
Проверяйте слои по очереди. Если backend выдаёт токены ровно, а gateway отправляет их клиенту пачками при пустом wmem, ищите flush и buffering. Если userspace пишет регулярно, но wmem_queued растёт, тогда peer или transport сдерживает поток. Если backend сам молчит, возвращайтесь к GPU queue и scheduler. В материале про Envoy overload manager мы разбирали защиту proxy от перегрузки; здесь socket evidence помогает не перепутать overload с транспортным запасом.
Для negative control отправьте тот же stream в локальный быстрый consumer, минуя внешний медленный путь, но сохранив gateway и backend. Затем сравните удалённого клиента через production route. Исчезновение очереди на локальном consumer связывает проблему с downstream; сохранение пауз указывает на gateway или backend. Это гораздо сильнее, чем переключить sysctl и увидеть случайное улучшение.
curl -Nsv --http1.1 https://gateway.example/v1/stream \
  -H 'Authorization: Bearer REDACTED' \
  -o /dev/null 2>client-timing.log

while true; do
  date --iso-8601=seconds
  ss -tinm state established '( sport = :443 )'
  sleep 2
doneKubernetes: Pod sysctl, hostNetwork и граница ответственности
В Kubernetes важно понять, где живёт gateway socket. Для обычного Pod network namespace часть net.* sysctl может быть namespaced. В актуальной документации Kubernetes net.ipv4.tcp_rmem и net.ipv4.tcp_wmem входят в safe set начиная с Kubernetes 1.32 при Linux kernel 4.15 или новее. Для Pod с hostNetwork: true сетевые sysctl через security context не разрешены: изменение уже затрагивает node boundary.
Это не приглашение задать одинаковые maxima каждому Pod. Сначала подтвердите версию control plane, kubelet и kernel, затем примените настройку к отдельному Deployment или node pool. Сохраните обычный Pod без sysctl как negative control. Метрики должны включать cgroup memory, restarts, throttling, connection completion и socket fields на fresh connections: уже открытый socket не всегда отражает новый baseline.
Разделите ownership. Platform team отвечает за node-wide limits и admission policy; команда gateway — за socket options, buffering и concurrency; команда модели — за выдачу токенов. Если все три слоя меняются одним rollout, доказать причину невозможно. Похожий принцип effective path мы использовали в разборе NodeLocal DNSCache для LLM inference: проверяется не декларация, а реальный namespace и результат приложения.
apiVersion: v1
kind: Pod
metadata:
  name: llm-gateway-buffer-canary
spec:
  securityContext:
    sysctls:
      - name: net.ipv4.tcp_rmem
        value: "4096 131072 4194304"
      - name: net.ipv4.tcp_wmem
        value: "4096 16384 4194304"
  containers:
    - name: gateway
      image: example/llm-gateway:tested
      resources:
        requests:
          memory: "512Mi"
        limits:
memory: "1Gi"Числа в примере — демонстрационная форма manifest, не рекомендация для production. Подставьте значения из baseline и проверьте их в вашей версии. Если приложение выставляет SO_RCVBUF, изменение tcp_rmem может не дать ожидаемого эффекта; зафиксируйте socket options через документацию runtime или eBPF/tracepoint-инструменты, доступные вашей команде.
Canary и rollback: меняйте один owner за раз
Хороший canary воспроизводит проблему, а не просто принимает часть трафика. Выберите клиентов с тем же RTT и темпом чтения, одинаковый route, модель и payload class. На baseline зафиксируйте распределения, а не только среднее: TTFT, максимальную межтокенную паузу, долю завершённых streams, retransmissions, r/rb, w/tb и память процесса. После этого измените один параметр.
Success criterion должен связывать низкий уровень с приложением. Например: проблемные sockets перестали упираться в receive limit, а completion rate и межтокенные паузы улучшились без роста memory pressure. Увеличившийся advertised window без изменения user experience — не успех. Аналогично уменьшение очереди при одновременном росте resets означает перенос проблемы.
Rollback делайте симметричным. Верните исходный sysctl или socket option, создайте fresh connections и повторите те же probes. Если эффект исчез, причинность усиливается. Если остался, ищите одновременное изменение маршрута, нагрузки backend или клиента. Для долгоживущих streams важен отдельный drain plan; опубликованный runbook про HTTP/2 GOAWAY и graceful drain помогает не обрывать активные запросы во время смены gateway.
# baseline
sysctl net.ipv4.tcp_rmem net.ipv4.tcp_wmem > /var/tmp/tcp-buffer.baseline

# apply only after recording approved values
sysctl -w net.ipv4.tcp_rmem='MIN DEFAULT MAX'
sysctl -w net.ipv4.tcp_wmem='MIN DEFAULT MAX'

# rollback from the captured baseline values
while read -r key _ value1 value2 value3; do
  sysctl -w "$key=$value1 $value2 $value3"
done < /var/tmp/tcp-buffer.baseline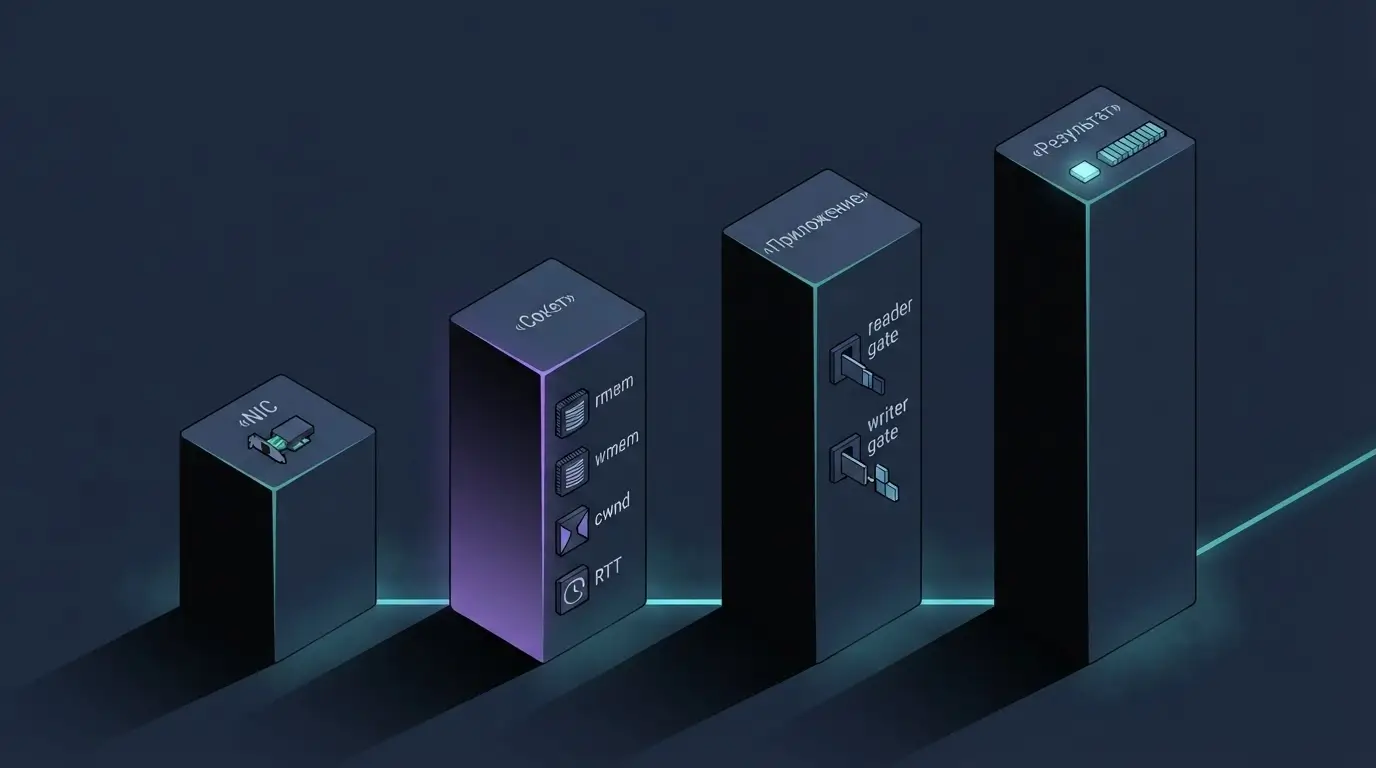
Когда оставить autotuning, настроить socket или масштабировать gateway
Оставьте autotuning, если socket limits не насыщаются, RTT и delivery rate нормальны, а задержка возникает в proxy или inference queue. Это самый частый и самый дешёвый verdict: параметр не является owner проблемы. Не меняйте инфраструктуру без доказанного socket-memory bottleneck.
Настройте конкретный socket, если один класс соединений имеет особый путь и приложение может безопасно управлять buffer. Например, отдельный upstream к удалённому GPU pool на большом RTT отличается от локальных downstream streams. Учитывайте, что ручной SO_RCVBUF меняет семантику autotuning. Документируйте библиотеку, момент вызова относительно connect()/listen() и память на соединение.
Измените node-wide ceiling, если множество сокетов на одном gateway упираются в доказанный системный потолок и canary показывает улучшение application outcome. Делайте это на отдельном node pool с memory budget. Масштабируйте gateway, когда bottleneck связан с совокупной памятью, CPU или failure domain: горизонтальное распределение connections часто безопаснее огромных per-socket maxima.
VPS подходит для небольшого controlled edge и воспроизводимого canary; выделенный сервер полезен, когда важны NIC queues, стабильный kernel/driver baseline и предсказуемый запас RAM. Disqualifier обязателен: новое железо не исправит медленного клиента, включённый proxy buffering, блокирующий L7 filter или GPU queue. Сначала path proof, затем procurement.
Production-runbook: от симптома до проверенного исправления
Сведите расследование к короткой цепочке доказательств. Первое: path — какой client, gateway instance и backend фактически обслуживали stream. Второе: socket — что происходило с rmem, wmem, RTT, cwnd, retransmissions и drops. Третье: application — когда читали и писали userspace, работал ли buffering. Четвёртое: outcome — изменились ли TTFT, паузы и завершение ответа.
- Зафиксируйте affected и healthy stream с одинаковым payload class.
- Снимите
ss -tinm, nstat, sockstat и cgroup memory. - Проверьте proxy buffering, L7 filters и backend token cadence.
- Сформулируйте один owner и один параметр.
- Запустите canary на fresh connections с negative control.
- Проверьте memory budget и failure signals.
- Выполните rollback и повторите те же probes.
Если проблема воспроизводится только на одном сетевом пути, дополните проверку route и loss. Если она появляется на одном process instance, смотрите event loop, CPU affinity и scheduling; статья про RSS, RPS и IRQ affinity разграничивает сетевой CPU и приложение. Если паузы коррелируют с исчерпанием backend capacity, вернитесь к overload control, а не расширяйте TCP queues.
Рабочий результат — не «мы увеличили буфер», а проверенная причинная связь и ограниченный blast radius. Сохраните baseline, change window, owner и условия возврата. Так следующий инцидент начинается с фактов, а не с ещё одного sysctl из истории команд.
Итог: буфер должен подтверждать поток, а не скрывать очередь
TCP autotuning в Linux уже умеет подстраивать receive и send buffers, поэтому ручное увеличение maxima не должно быть первым шагом. Для LLM streaming важнее связать четыре слоя: реальный путь, состояние socket, поведение gateway и пользовательский результат. Заполненный wmem при медленном клиенте, пустые buffers при proxy batching и memory pressure у тысяч streams требуют разных решений.
Начните с ss -tinm и временной линии одного проблемного ответа. Сохраните healthy negative control, измените один owner на canary и обязательно верните настройку к baseline. Только улучшение application outcome при контролируемой памяти даёт право закрепить change.
Если доказан node-wide bottleneck, перенесите gateway на предсказуемый VPS или выделенный edge с понятным kernel/NIC baseline и отдельным failure domain. Но сначала примените checklist из runbook к своему трафику: он быстро покажет, нужен ли новый ceiling, точечный socket option или исправление совсем другого слоя.