Оглавление
- Симптомы: когда gateway упирается в сетевое CPU
- Evidence gate: докажите bottleneck до тюнинга
- Как пакет проходит RSS, IRQ и softirq
- RSS, RPS, RFS и XPS: что выбирать
- NUMA и CPU locality на выделенном сервере
- Метрики очередей: что считать, а чему не верить
- Безопасная настройка IRQ affinity и RSS
- Когда включать RPS и как не создать IPI storm
- Canary: проверяем peer, fresh connections и application outcome
- Типичные ошибки и миграция bottleneck
- Rollback и эксплуатационный runbook
- Вывод: оптимизируйте доказанный путь, а не загрузку CPU
Готовы перейти на современную серверную инфраструктуру?
В King Servers мы предлагаем серверы как на AMD EPYC, так и на Intel Xeon, с гибкими конфигурациями под любые задачи — от виртуализации и веб-хостинга до S3-хранилищ и кластеров хранения данных.
- S3-совместимое хранилище для резервных копий
- Панель управления, API, масштабируемость
- Поддержку 24/7 и помощь в выборе конфигурации
Результат регистрации
...
Создайте аккаунт
Быстрая регистрация для доступа к инфраструктуре
Симптомы: когда gateway упирается в сетевое CPU
Типичная авария выглядит нелогично: суммарный CPU сервера далёк от 100%, GPU backend отвечает стабильно, а p99 и time-to-first-token на входном gateway внезапно растут. В top одно или два ядра заняты ksoftirqd, в /proc/interrupts почти весь поток NIC приходит на один CPU, а соседние ядра простаивают. Добавление worker-процессов не помогает: пакет всё равно должен пройти RX queue, IRQ и network softirq до того, как его увидит NGINX, Envoy или собственный API-процесс.
Это важно отличать от accept bottleneck. SO_REUSEPORT распределяет новые соединения между listeners, но не исправляет перекошенную аппаратную RX-очередь. И наоборот: идеальный RSS не спасёт, если TLS handshakes съедают userspace CPU или запросы стоят в inference queue. Наша задача — найти владельца задержки по пути пакета, а не подобрать красивый sysctl.
Быстрый признак сетевого перекоса — корреляция трёх рядов: interrupts одной RX queue, NET_RX softirq на том же CPU и ухудшение application SLO. Одного высокого счётчика недостаточно. Проверяли ли вы, что всплеск softirq действительно совпадает с задержкой свежих соединений, а не просто отражает нормальную работу busy gateway?
Evidence gate: докажите bottleneck до тюнинга
Снимайте baseline во время воспроизводимой нагрузки: одинаковый профиль запросов, те же TLS-настройки, тот же backend и неизменное число gateway workers. Минимальный набор — per-CPU utilisation, /proc/interrupts, /proc/softirqs, статистика NIC по очередям, drops, retransmits и application SLO. Для LLM streaming добавьте TTFT, долю оборванных SSE/gRPC streams и latency уже после первых байтов: улучшение приёма пакетов не должно маскировать partial responses.
В Linux аппаратный RSS выбирает RX queue, IRQ этой очереди будит CPU, а softirq продолжает обработку сетевого стека. RPS может перенаправить protocol processing на другой CPU позднее, уже программно. Официальная документация Linux по scaling подчёркивает: при корректном RSS с очередью на CPU RPS часто избыточен. Поэтому сначала установите фактический путь, затем меняйте только один слой.
Негативный контроль обязателен. Направьте короткий тест на тот же gateway по loopback или напрямую к userspace listener, если архитектура и безопасность это позволяют. Если задержка остаётся, NIC steering не главный владелец. Второй контроль — снизить packet rate, сохранив request concurrency: если SLO восстанавливается вместе с падением softirq, гипотеза становится сильнее. Это не benchmark, а проверка причинности.
#!/usr/bin/env bash
set -euo pipefail
iface=${1:-eth0}
date -Is
ethtool -l "$iface"
ethtool -x "$iface" 2>/dev/null || true
ethtool -S "$iface" | grep -Ei 'rx.*(queue|drop|miss|error)|tx.*(queue|drop|error)' || true
grep -E "$iface|CPU" /proc/interrupts
sed -n '1p;/NET_RX/p;/NET_TX/p' /proc/softirqs
nstat -az | grep -E 'TcpRetransSegs|IpInDiscards|TcpExtListenDrops' || trueКак пакет проходит RSS, IRQ и softirq
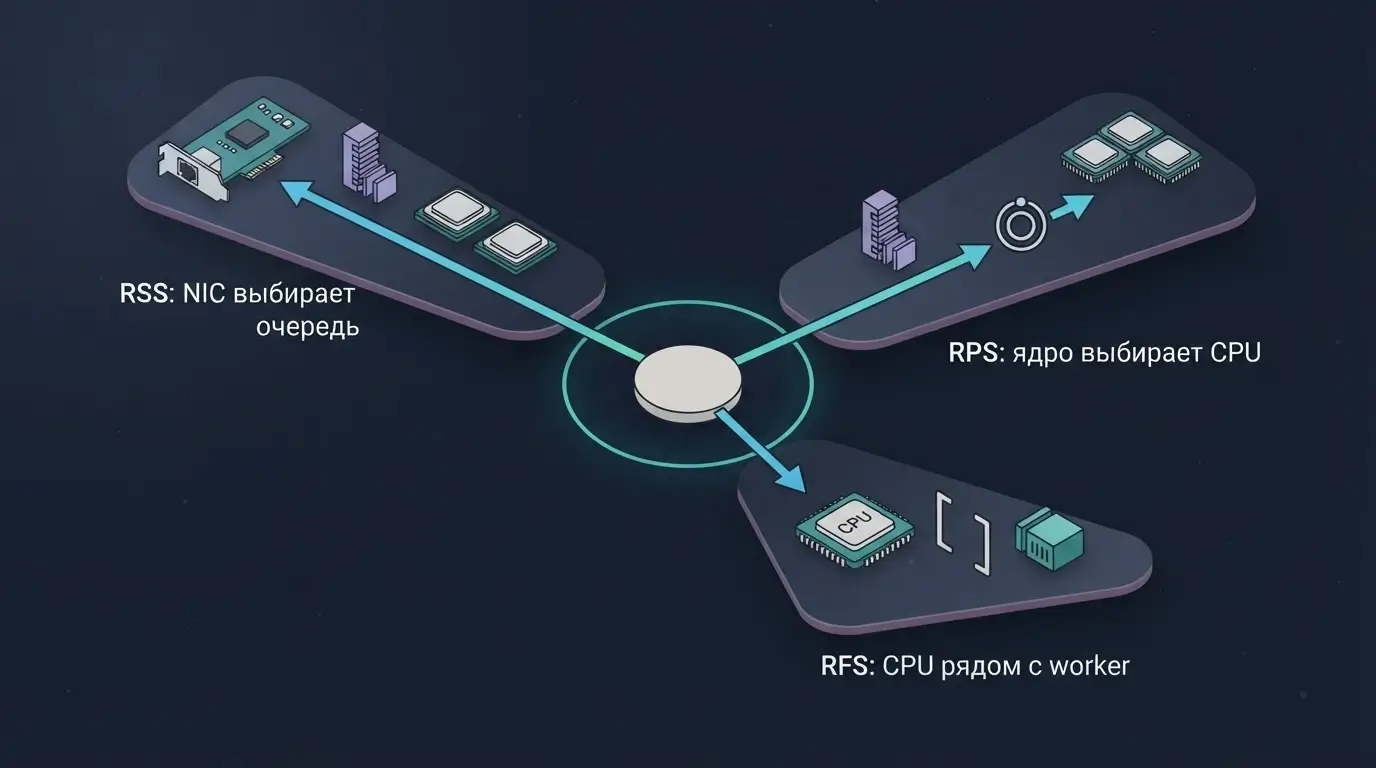
RSS работает в сетевой карте: NIC вычисляет hash по полям потока и через indirection table выбирает RX queue. У multi-queue NIC каждая очередь обычно связана с MSI-X interrupt. Карта queue → IRQ → CPU видна не в одном файле, поэтому её приходится собирать: список каналов из ethtool -l, имена IRQ из /proc/interrupts, разрешённая и эффективная affinity из /proc/irq/*. Именно effective_affinity_list показывает фактический CPU, когда interrupt managed.
После NAPI polling пакет попадает в protocol processing. Если rps_cpus равен нулю, обработка остаётся на interrupting CPU. При включённом RPS ядро выбирает target CPU по flow hash и ставит пакет в backlog другого CPU, посылая IPI. Это может разгрузить горячее ядро на виртуальном NIC с одной очередью, но цена — межпроцессорные прерывания и возможная потеря cache locality.
У LLM API потоки неодинаковы: короткий health check и длинный streaming response могут иметь одинаковый вес для hash, но совершенно разную жизнь в приложении. Поэтому равномерные IRQ ещё не гарантируют равномерный userspace. Смотрите одновременно queue packets, CPU softirq и фактические worker sockets. Если один огромный поток доминирует, RSS не обязан разрезать его между ядрами: ordering внутри flow важнее красивой диаграммы.
RSS, RPS, RFS и XPS: что выбирать
Начальный выбор прост. Есть достаточно hardware RX queues и они действительно распределены по подходящим CPU — настраивайте RSS и IRQ affinity, не включайте RPS автоматически. Очередей мало или виртуальная NIC отдаёт один receive path — протестируйте RPS на CPU того же NUMA node. Хотите приблизить packet processing к потоку приложения — рассматривайте RFS, но только после стабильного worker placement. Для transmit path существует XPS; он полезен отдельно и не доказывает, что receive bottleneck устранён.
RFS использует flow table и сведения о CPU, на котором userspace читает socket. Если scheduler постоянно мигрирует gateway worker, локальность становится движущейся целью. Сначала закрепите или хотя бы наблюдайте worker placement, затем оценивайте RFS. Accelerated RFS требует поддержки драйвера и NIC, а также ntuple filtering; это capability gate, не универсальная настройка.
Ошибка серии «включим всё» особенно неприятна: RSS, RPS, irqbalance и ручная affinity начинают тянуть пакеты в разные стороны. Изменение может снизить softirq на одном CPU, но поднять IPI, LLC misses и latency. Поэтому каждое решение формулируйте как гипотезу: «две RX queue сконцентрированы на CPU 2; перенос IRQ на CPU 4 и 6 того же NUMA node снизит queue pressure без роста retransmits». Так результат можно опровергнуть.
NUMA и CPU locality на выделенном сервере
На двухсокетном сервере «размазать IRQ по всем ядрам» часто хуже, чем оставить меньше CPU рядом с NIC. PCIe-карта физически принадлежит NUMA node; пакетные buffers и DMA оказываются ближе к памяти этого узла. Если interrupt приходит на другой socket, вы платите за interconnect traffic и cache misses. Команда cat /sys/class/net/eth0/device/numa_node даёт стартовую точку, а lscpu -e=CPU,NODE,SOCKET,CORE показывает топологию.
Отделите housekeeping, network path и application workers настолько, насколько это подтверждает нагрузка. Не резервируйте половину сервера «на всякий случай»: у gateway может оказаться больше пользы от общих cache и достаточного числа workers. Практичный canary — закрепить IRQ двух горячих RX queues на свободных CPU локального NUMA node и оставить остальные очереди baseline. После этого сравнить не только softirq, но и TTFT, context switches, LLC misses и network drops.
Для shared VM физическая NUMA topology и IRQ routing частично принадлежат гипервизору. В этом случае ручная маска внутри гостя может быть нестабильна после миграции или reboot. VPS или выделенный edge даёт больше контроля над версиями kernel, NIC queues и change window, но сам по себе не исправляет неверный hash, single-flow hotspot или очередь GPU. Сначала докажите control gap; затем решайте вопрос платформы.
#!/usr/bin/env bash
set -euo pipefail
iface=${1:-eth0}
echo "NIC NUMA node: $(cat /sys/class/net/$iface/device/numa_node)"
lscpu -e=CPU,NODE,SOCKET,CORE,ONLINE
while read -r irq rest; do
  n=${irq%:}
  printf 'IRQ %s allowed=%s effective=%s\n' "$n" \
    "$(cat /proc/irq/$n/smp_affinity_list 2>/dev/null || echo n/a)" \
    "$(cat /proc/irq/$n/effective_affinity_list 2>/dev/null || echo n/a)"
done < <(grep "$iface" proc interrupts)< code>
Метрики очередей: что считать, а чему не верить
Названия counters зависят от драйвера, поэтому не стройте runbook вокруг одного rx_queue_0_drops. Сначала сохраните полный ethtool -S, затем найдите per-queue packets, bytes, drops, misses и allocation failures. Официальная kernel documentation по interface statistics напоминает, что часть стандартных counters доступна через несколько интерфейсов; vendor-specific строки требуют проверки драйвера.
/proc/net/softnet_stat полезен, но его hex-поля и семантика менялись между версиями kernel. Не копируйте парсер из случайной статьи без сверки с исходниками или документацией вашей версии. Безопаснее дополнить его sar -n DEV, per-CPU softirq, NIC drops и application metrics. Если «dropped» растёт, докажите, на каком CPU и при каком workload это происходит.
Следите за распределением, а не только суммой. Условные 200 тысяч interrupts на сервер ничего не говорят, если 190 тысяч пришли на CPU 0. Но и идеально ровная гистограмма не является SLO: иногда worker pool закреплён на меньшем CPU set, и перенос packets на удалённые cores увеличит cache traffic. Хороший dashboard связывает queue ID → IRQ → effective CPU → softirq CPU → gateway worker → request outcome. Если цепочка обрывается, вывод остаётся гипотезой.
Безопасная настройка IRQ affinity и RSS
Перед записью affinity проверьте irqbalance. Он может вернуть IRQ на другие CPU после вашего изменения; это выглядит как «настройка не работает», хотя конфликтуют два owner. Не отключайте daemon глобально вслепую. Либо задайте его policy/ban mask, либо остановите на одном canary и зафиксируйте этот факт в runbook. Для managed interrupts запись в smp_affinity_list может быть недоступна; это ограничение драйвера и IRQ core.
Используйте smp_affinity_list, когда возможно: список CPU читается легче, чем hex bitmap. Официальная документация SMP IRQ affinity описывает оба интерфейса. Меняйте одну очередь за раз. После изменения перечитайте effective_affinity_list, потому что успешный echo ещё не доказывает фактическое размещение.
RSS indirection table редактируют через ethtool -X; количество combined channels — через ethtool -L. Эти команды зависят от capability NIC и драйвера и могут переименовать IRQ. Сначала сохраните ethtool -l, -x и interrupt mapping. Никогда не вставляйте в automation фиксированные номера IRQ, полученные до reboot или изменения channel count.
#!/usr/bin/env bash
set -euo pipefail
irq=${1:?usage: $0 IRQ CPU_LIST}
cpus=${2:?usage: $0 IRQ CPU_LIST}
old=$(cat /proc/irq/$irq/smp_affinity_list)
printf '%s\n' "$old" > "/run/irq-${irq}.affinity.before"
printf '%s\n' "$cpus" > "/proc/irq/$irq/smp_affinity_list"
printf 'allowed=%s effective=%s\n' \
  "$(cat /proc/irq/$irq/smp_affinity_list)" \
  "$(cat /proc/irq/$irq/effective_affinity_list 2>/dev/null || echo n/a)"
Когда включать RPS и как не создать IPI storm
RPS нужен не потому, что сервер многопроцессорный, а потому, что текущий receive path не использует доступный CPU budget. На NIC с одной RX queue маска rps_cpus может распределить protocol processing по нескольким cores. На полноценном RSS с очередью на CPU тот же RPS часто добавляет лишний hop. Kernel docs прямо называют эти механизмы взаимодополняющими, но не требуют включать оба.
Начните с CPU того же memory domain и исключите interrupting CPU, если он уже перегружен. Затем измерьте IPI, softirq distribution и backlog drops. Большая маска не гарантирует лучший результат: пакет может пересечь NUMA boundary, а gateway worker — читать данные на третьем CPU. Для RFS отдельно задаются global rps_sock_flow_entries и per-queue rps_flow_cnt; размеры выбирают под реальное число активных flows, а не копируют из чужого 64-core сервера.
Практический failure mode: после RPS график CPU становится ровнее, но TTFT растёт. Причина — дополнительный IPI и потеря locality. Контрфактическая проверка проста: вернуть маску одной canary queue в ноль и повторить тот же workload. Если SLO возвращается к baseline, «ровный CPU» был локальным улучшением счётчика, а не end-to-end выигрышем.
#!/usr/bin/env bash
set -euo pipefail
path=${1:-/sys/class/net/eth0/queues/rx-0/rps_cpus}
mask=${2:?pass CPU bitmap, for example 0c}
old=$(cat "$path")
printf '%s\n' "$old" > /run/rps-rx0.before
printf '%s\n' "$mask" > "$path"
printf 'before=%s after=%s\n' "$old" "$(cat "$path")"Canary: проверяем peer, fresh connections и application outcome
Canary должен менять один control: IRQ affinity одной или двух очередей, RPS одной queue либо RSS indirection weights. Не меняйте одновременно worker count, TLS configuration и kernel. Baseline и canary получают одинаковую форму нагрузки, включая короткие запросы и длительный streaming. Иначе можно улучшить handshake path и ухудшить уже установленные соединения, не заметив этого в среднем latency.
Разделите три evidence gate. Первый — kernel path: нужные IRQ действительно приходят на выбранные CPU, drops не растут. Второй — фактический peer и connection lifecycle: fresh connections попадают на ожидаемый gateway, а reused connections анализируются отдельно. Третий — outcome: TTFT, p95/p99, stream completion и error rate улучшаются или хотя бы не ухудшаются. Эта схема продолжает подход из runbook про HTTP/2 GOAWAY и graceful drain: событие transport не равно результату запроса.
Для отрицательного контроля оставьте один gateway без изменений. Для контрфактического теста временно верните canary affinity к baseline и убедитесь, что метрики движутся обратно. Если эффект сохраняется, вы, вероятно, измерили изменение трафика или backend, а не steering. Такой тест особенно полезен, когда autoscaling GPU или client retries меняются параллельно.
Типичные ошибки и миграция bottleneck
Первая ошибка — лечить softirq числом NGINX workers. Userspace появляется позже в пути; worker count может изменить socket ownership, но не исправит single RX queue. Вторая — принять высокий ksoftirqd за причину без drops и SLO correlation. Третья — отключить irqbalance и забыть про reboot persistence. Четвёртая — распределить IRQ на CPU, где уже работают TLS или compression threads.
Даже успешный steering способен передвинуть bottleneck. После разгрузки RX path может проявиться TLS CPU, lock contention proxy, conntrack, egress queue или inference backend. Поэтому после canary повторите полный owner map, а не завершайте работу на графике softirq. Если теперь растёт handshake CPU, пригодится отдельный runbook по TLS handshake storm. Если gateway быстро отдаёт 503 или рвёт stream после headers, сверяйтесь с Envoy overload и backpressure.
Не обещайте latency от покупки нового сервера. Выделенный edge оправдан, когда доказан control gap: нужны стабильные NIC queues, известная NUMA topology, управляемые kernel/driver versions и собственное change window. Он не исправит poor hash entropy, один доминирующий flow, retry storm или очередь GPU. Это и есть честный procurement default: не менять платформу до доказанного участка path.
Rollback и эксплуатационный runbook
Rollback должен быть симметричен rollout. Сохраняйте исходные smp_affinity_list, rps_cpus, RSS indirection table и channel count до каждой записи. Возврат значений — только половина процедуры: перечитайте effective state, создайте fresh connections и повторите те же SLO probes. Старые sockets могут продолжать жить на прежнем worker или TX queue, поэтому мгновенного возврата всех графиков ждать нельзя.
Опишите owner и срок действия. Кто управляет irqbalance? Где хранится persistence — systemd unit, tuned profile, NetworkManager dispatcher или provisioning? Что произойдёт после обновления kernel/driver и изменения имён интерфейсов? Ручной echo в production без ответов на эти вопросы превращается в скрытую конфигурацию.
Порог rollback задавайте через ваш baseline, не универсальными числами. Примеры условий: рост RX drops, retransmits, stream aborts, TTFT или межсокетного memory traffic; исчезновение ожидаемого improvement после контрфактического теста; конфликт с managed IRQ. После отката зафиксируйте, какой evidence gate не прошёл. Это полезнее фразы «RPS не помог».
#!/usr/bin/env bash
set -euo pipefail
irq=${1:?pass IRQ}
if [[ -r /run/irq-${irq}.affinity.before ]]; then
  cat "/run/irq-${irq}.affinity.before" > "/proc/irq/${irq}/smp_affinity_list"
fi
if [[ -r /run/rps-rx0.before ]]; then
  cat /run/rps-rx0.before > /sys/class/net/eth0/queues/rx-0/rps_cpus
fi
cat "/proc/irq/${irq}/smp_affinity_list"
cat "/proc/irq/${irq}/effective_affinity_list" 2>/dev/null || true
cat /sys/class/net/eth0/queues/rx-0/rps_cpus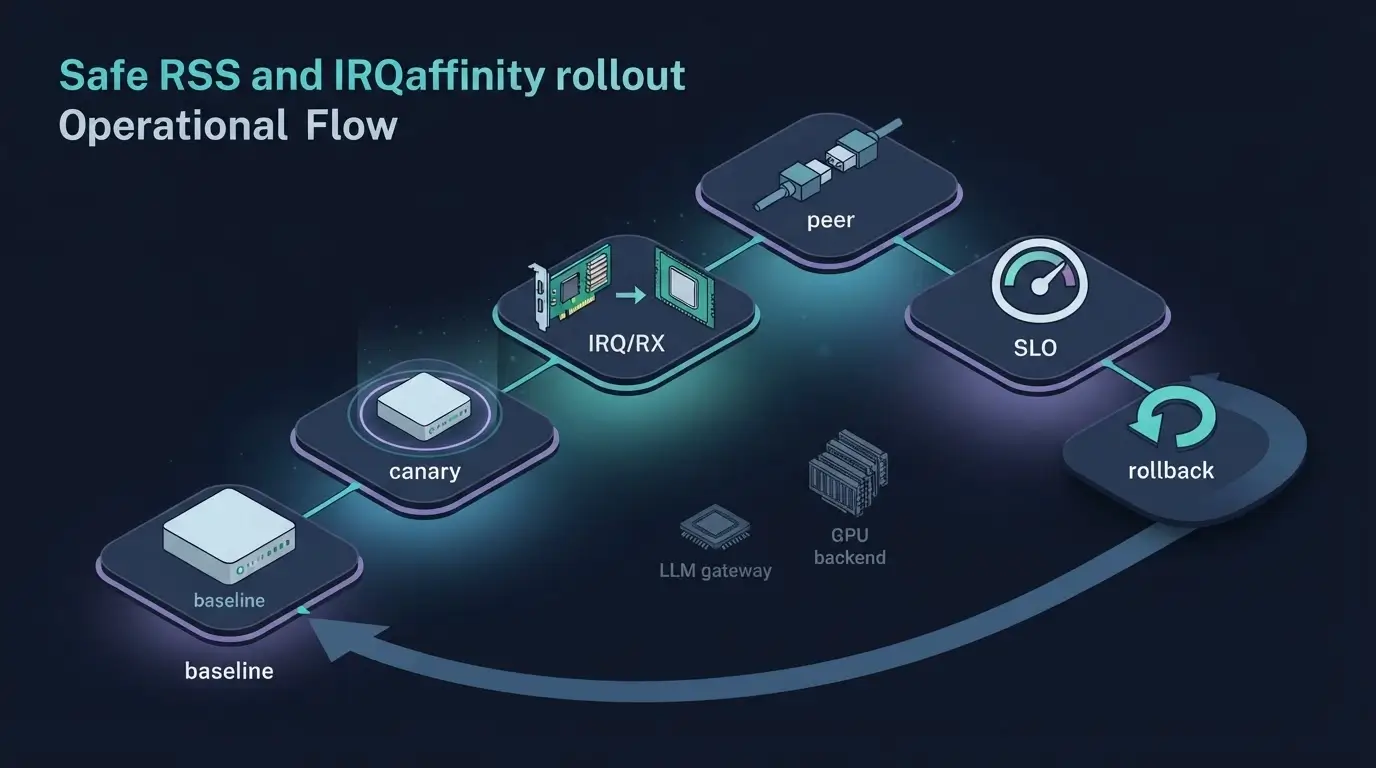
Вывод: оптимизируйте доказанный путь, а не загрузку CPU
RSS, RPS и IRQ affinity полезны, когда вы доказали конкретный receive-path bottleneck: очередь NIC, interrupt CPU, softirq и application outcome связаны одной цепочкой. Начинайте с аппаратного RSS и фактической IRQ mapping, учитывайте NUMA, а RPS/RFS добавляйте только при понятном дефиците hardware queues или locality. Ровный CPU-график сам по себе не является успехом.
Практический следующий шаг — снять неизменяемый baseline, выбрать одну RX queue для canary и пройти три gate: kernel path, fresh-connection peer, SLO. Затем выполнить контрфактический возврат и проверить, что эффект исчезает вместе с настройкой. Если контроль над NIC, kernel и NUMA действительно ограничивает эксплуатацию, сравнивайте VPS и выделенный edge по ownership, telemetry и rollback window, а не по обещанию «меньше latency».
Возьмите чек-лист из статьи, проведите тест в своём maintenance window и сохраните исходные значения до первой записи. Так сетевой тюнинг останется управляемым изменением, а не новой причиной ночного инцидента.