Оглавление
- Почему FQDN egress ломается не там, где кажется
- Как toFQDNs превращает имя в разрешённый сетевой путь
- Снимите baseline до изменения policy
- Соберите минимальную CiliumNetworkPolicy без широкого allow
- Разберите TTL, FQDN cache и IP churn
- Докажите решение через Hubble и effective policy
- Rollout и rollback: меняйте одну границу за раз
- Когда выделенная инфраструктура помогает, а когда нет
- Итог: доменное имя — начало доказательства, а не готовое разрешение
Готовы перейти на современную серверную инфраструктуру?
В King Servers мы предлагаем серверы как на AMD EPYC, так и на Intel Xeon, с гибкими конфигурациями под любые задачи — от виртуализации и веб-хостинга до S3-хранилищ и кластеров хранения данных.
- S3-совместимое хранилище для резервных копий
- Панель управления, API, масштабируемость
- Поддержку 24/7 и помощь в выборе конфигурации
Результат регистрации
...
Создайте аккаунт
Быстрая регистрация для доступа к инфраструктуре
Почему FQDN egress ломается не там, где кажется
Типичный инцидент выглядит обманчиво просто: pod с inference-gateway вчера обращался к внешнему API по доменному имени, а сегодня часть запросов висит до таймаута. DNS из shell отвечает, сертификат валиден, соседний namespace работает. Команда расширяет CIDR, перезапускает CoreDNS или временно снимает policy, и связь возвращается. Причина при этом остаётся неизвестной, а следующий IP-rotation повторяет сбой.
В Cilium правило toFQDNs не является статическим allowlist домена. Агенту нужно увидеть DNS-ответ от конкретного endpoint, связать имя с адресами, обновить FQDN cache и materialize разрешение в effective policy. После этого новый TCP/TLS flow должен попасть под эту policy. Здесь минимум четыре разных состояния: ответ resolver, содержимое cache, политика endpoint и результат приложения. Зелёный индикатор на одном слое не делает зелёной всю цепочку.
Представьте сервис, который обращается к API провайдера через имя api.vendor.example. Провайдер меняет A-запись, JVM продолжает использовать старый адрес, а Cilium уже удалил его после TTL. Новый connection к старому IP будет отброшен, хотя имя в YAML написано верно. Обратный сценарий тоже возможен: приложение получило свежий IP, но DNS-запрос прошёл не через наблюдаемый proxy, поэтому адрес не появился в policy.
Поэтому default для расследования такой: не увеличивать TTL и не расширять egress «на всякий случай». Сначала докажите, где расходятся desired state, effective network state и application outcome. Этот подход отделяет ошибку selector от DNS lifecycle и не превращает временное восстановление в постоянную дыру.
Как toFQDNs превращает имя в разрешённый сетевой путь
Стандартный Kubernetes NetworkPolicy работает с pod selectors, namespaces, ports и CIDR. Он не задаёт переносимое правило «разрешить любой адрес, на который сейчас указывает это DNS-имя». CiliumNetworkPolicy добавляет FQDN-aware egress: matchName подходит для точного имени, matchPattern — для контролируемого шаблона. Но обе формы зависят от DNS visibility.
Рабочая цепочка начинается с DNS allow rule к вашему resolver. Запрос обычно идёт к CoreDNS на UDP/53, но production-клиент может использовать TCP при усечённом ответе, NodeLocal DNSCache или отдельный корпоративный resolver. Если policy разрешает только привычный kube-dns label, а workload фактически обращается к local listener, toFQDNs не получает исходное событие. Проверьте реальный destination, а не архитектурную схему в wiki.
После ответа Cilium хранит данные на нескольких уровнях. В документации описаны per-endpoint DNS cache, global cache и zombie mapping для адресов, чей TTL истёк, но существующие соединения ещё учитываются connection tracking. Это важно: «адрес исчез из свежего ответа» и «адрес немедленно запрещён для любого пакета» — не одно и то же. Новые соединения и уже установленные flows живут по разным правилам.
Наконец, FQDN selector должен превратиться в identities и попасть в effective policy нужного endpoint. Если labels не выбирают workload, pod работает с hostNetwork или запущен до корректной установки Cilium, вы исследуете не тот enforcement point. Официальная инструкция Cilium по troubleshooting прямо советует сначала убедиться, что pod управляется Cilium, а уже затем разбирать policy.
Снимите baseline до изменения policy
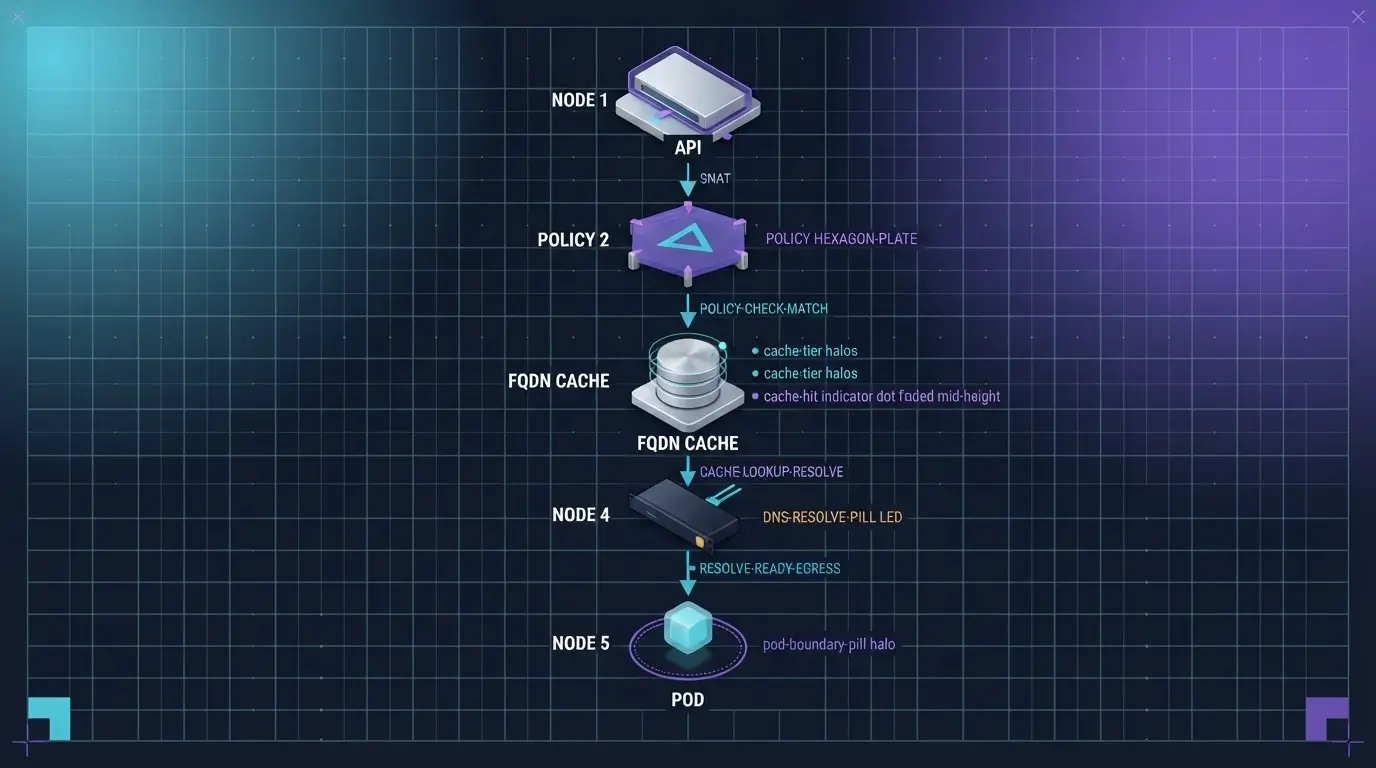
Хороший runbook начинается не с YAML, а с карточки инцидента. Запишите namespace, pod UID, node, service account, labels и Cilium endpoint ID. Затем из того же container network namespace получите A и AAAA, TTL, адрес resolver и время запроса. Не заменяйте этот шаг запросом с ноутбука: корпоративный DNS, split horizon и search domains легко дадут другой ответ.
Следом сохраните два Hubble-среза: DNS traffic на 53 и попытку соединения к API на 443. Для каждого нужны source identity, destination IP, verdict и drop reason. Третий снимок — effective policy endpoint. Desired CiliumNetworkPolicy из Kubernetes API показывает намерение, но не гарантирует, что selector выбрал именно этот pod и правило уже применено на его node.
Определите application outcome до эксперимента. Для streaming LLM API это может быть успешный TLS handshake, получение HTTP headers, первый SSE event и штатное завершение stream. Не смешивайте эти точки: быстрый connect без ответа модели доказывает только transport. В соседнем материале о HTTP/2 GOAWAY и graceful drain показано, почему connection event и судьба отдельного request не равны.
Нужен и отрицательный контроль. Оставьте один pod или namespace на прежней policy либо запросите заведомо неразрешённое имя. Если после изменения начинают проходить и целевой, и запрещённый destination, это не успех, а потеря границы. Отрицательный контроль особенно полезен при объединении нескольких additive policies: порядок правил не важен, разрешения складываются, и неожиданно широкий allow может прийти из другого объекта.
kubectl -n ai get pod inference-gateway-0 -o wide --show-labels
kubectl -n kube-system exec ds/cilium -- cilium-dbg endpoint list
kubectl -n ai exec inference-gateway-0 -- getent ahosts api.vendor.example
hubble observe -P --since 5m --namespace ai --pod inference-gateway-0
kubectl -n kube-system exec ds/cilium -- cilium-dbg fqdn cache list
Соберите минимальную CiliumNetworkPolicy без широкого allow
Минимальная policy должна отвечать на два разных вопроса: куда workload разрешено отправлять DNS-запросы и к какому FQDN разрешено подключаться. Это две egress rules, а не одна магическая запись. В DNS rule выбирайте фактический resolver и разрешайте DNS L7 rule только для нужных имён либо осознанно для более широкого набора. В FQDN rule задайте TCP/443, если провайдер действительно использует HTTPS.
Ниже — скелет, а не готовый универсальный манифест. Labels CoreDNS отличаются между дистрибутивами; NodeLocal DNSCache может потребовать entity или CIDR-модель, совместимую с вашей установкой. Точное имя предпочтительнее шаблона. Шаблон *.example.com не означает «example.com и все уровни поддоменов» во всех ожидаемых трактовках, поэтому проверяйте спецификацию и фактический match.
Не добавляйте IPBlock параллельно «для надёжности»: он маскирует ошибку DNS path и превращает динамический allowlist в ручной список. Если API публикует CDN-адреса, диапазон может быть большим и общим с чужими сервисами. Разрешение по CIDR снимает пользу domain-based boundary, а обслуживание такого списка становится вашим on-call debt.
После apply проверьте статус policy и endpoint, затем повторите ровно тот же запрос. В статье о PROXY protocol v2 для LLM API мы разделяли физического peer, заявленную metadata и effective identity; здесь логика похожа: имя в объекте, IP в cache и identity в datapath — самостоятельные факты.
apiVersion: cilium.io/v2
kind: CiliumNetworkPolicy
metadata:
  name: inference-api-egress
  namespace: ai
spec:
  endpointSelector:
    matchLabels:
      app: inference-gateway
  egress:
    - toEndpoints:
        - matchLabels:
            k8s:io.kubernetes.pod.namespace: kube-system
            k8s:k8s-app: kube-dns
      toPorts:
        - ports:
            - port: "53"
              protocol: ANY
          rules:
            dns:
              - matchName: api.vendor.example
    - toFQDNs:
        - matchName: api.vendor.example
      toPorts:
        - ports:
            - port: "443"
              protocol: TCP
Разберите TTL, FQDN cache и IP churn
Самый неприятный класс сбоев появляется не сразу после rollout, а через TTL. Cilium по умолчанию учитывает TTL DNS-ответа. Приложение при этом может кешировать адрес дольше, использовать собственный resolver или держать connection pool часами. Если после истечения TTL оно открывает новый connection к старому IP без нового DNS lookup, policy закономерно блокирует flow. Это не случайный drop: network state больше не подтверждает связь имени с адресом.
Сравните четыре времени: TTL в ответе, момент записи в per-endpoint cache, срок DNS-кеша runtime и возраст connection. Например, Java, Go, Envoy и sidecar могут иметь разные resolver semantics. Не переносите вывод из dig в поведение процесса без проверки. Внешний curl создаёт новый lookup и connection, поэтому часто «лечит» тест, который приложение продолжает проваливать.
Параметр минимального TTL Cilium может смягчить короткие TTL, но это компромисс, а не первая помощь. Слишком большой минимум задерживает отзыв адреса и расширяет окно, когда новый connection идёт к устаревшему backend. Прежде чем менять его, воспроизведите drop после TTL, подтвердите отсутствие повторного lookup и проверьте, что провайдер действительно допускает более долгую жизнь адреса.
AAAA — отдельная ветка. Workload может получить IPv4 и IPv6, а policy или инфраструктура поддерживает только один path. Happy Eyeballs скроет часть проблем, пока порядок адресов или latency не поменяются. Записывайте оба набора и Hubble flows по каждой семье. Похожая дисциплина описана в статье о DNS failover для LLM API, но здесь owner состояния — FQDN policy cache конкретного endpoint, а не только resolver и клиентское соединение.
Команда ниже полезна для корреляции, но формат вывода зависит от версии Cilium. На дату подготовки stable-документация показывает ветку 1.20.2; перед автоматизацией сверяйте CLI вашей установленной версии. Наличие IP в cache означает, что toFQDNs может построить identity, но не доказывает выбор endpoint или успешный application request.
Официальный разбор FQDN cache также описывает zombie mappings: истёкшие записи могут удерживаться, пока connection tracking считает адрес используемым. Поэтому простой подсчёт строк cache без временной шкалы даёт ложную уверенность.
Докажите решение через Hubble и effective policy
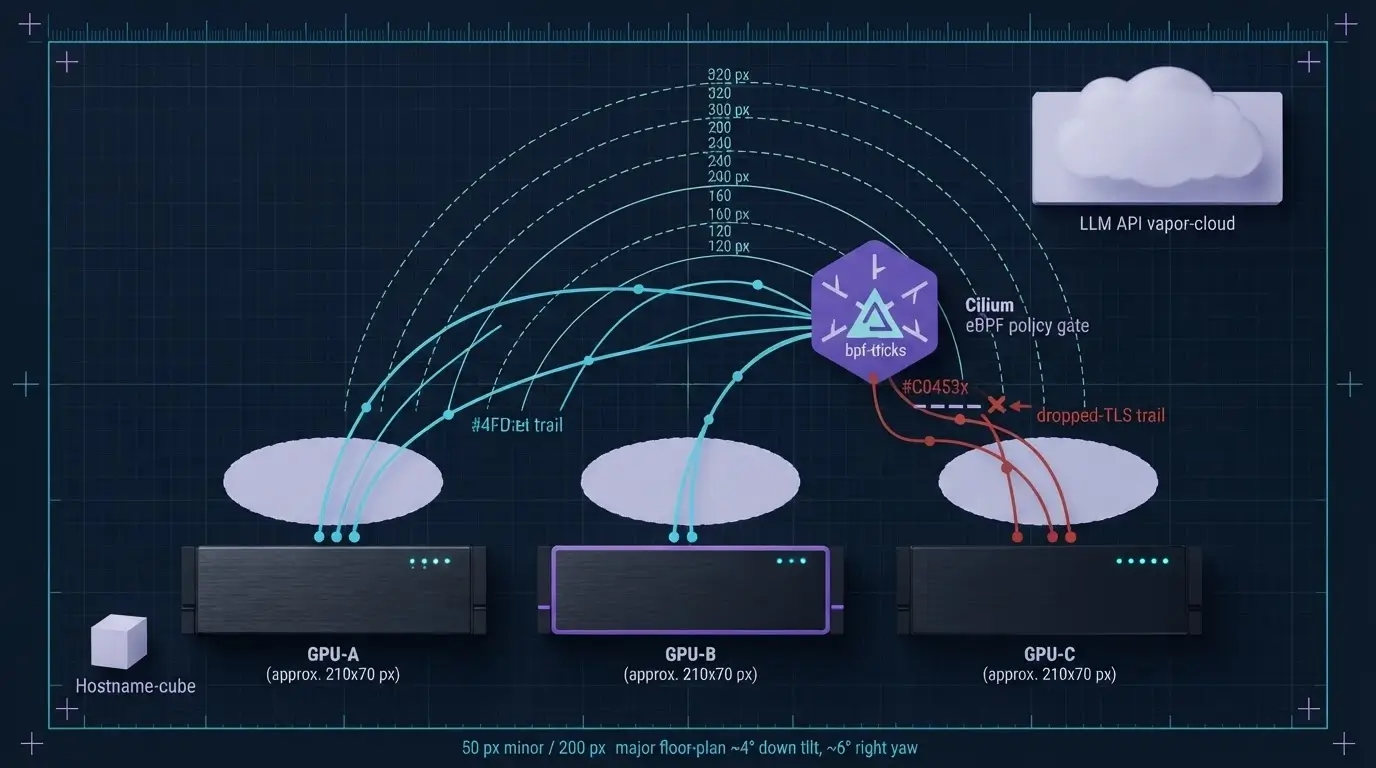
Hubble отвечает на вопрос «что произошло с flow на управляемом Cilium endpoint». Начните с DNS. Вы должны увидеть запрос и ответ между workload и resolver; при включённой DNS visibility доступны имя и response details. Затем отфильтруйте destination IP из ответа и TCP/443. Если DNS FORWARDED, а TLS DROPPED, проблема находится после resolution: cache, identity propagation, selector или port rule.
Если flow отсутствует, не делайте вывод «Cilium ничего не блокирует». Hubble Relay может не быть подключён к node, временное окно слишком узко, pod не управляется Cilium или traffic идёт через host network. Официальная инструкция Hubble предлагает сначала проверить status и connected nodes. Только после этого отсутствие события становится полезным фактом.
Effective policy следует читать для endpoint ID проблемного pod. Сопоставьте labels, policy revision и разрешённые identities. Kubernetes policies additive: другой allow может сделать эксперимент зелёным, а deny-модель Cilium — изменить итог в зависимости от выбранного формата и версии. Не ограничивайтесь сообщением «policy imported». Оно означает, что объект принят, но не описывает результат конкретного endpoint.
Application gate завершает доказательство. Для LLM streaming сохраните HTTP status, time to headers, time to first event, число завершённых streams и причины разрыва. Не приписывайте Cilium улучшение TTFT, если исчез только сетевой timeout. Сетевая policy управляет доступом; очередь inference, overload и backpressure остаются другими слоями. Для них уместен отдельный runbook про Envoy под перегрузкой LLM API.
hubble status -P
hubble observe -P --since 10m --namespace ai --pod inference-gateway-0 --protocol DNS
hubble observe -P --since 10m --namespace ai --pod inference-gateway-0 --port 443
kubectl -n kube-system exec ds/cilium -- cilium-dbg fqdn cache list
kubectl -n ai exec inference-gateway-0 -- curl -sS -o /dev/null -w '%{http_code}\n' https://api.vendor.example/health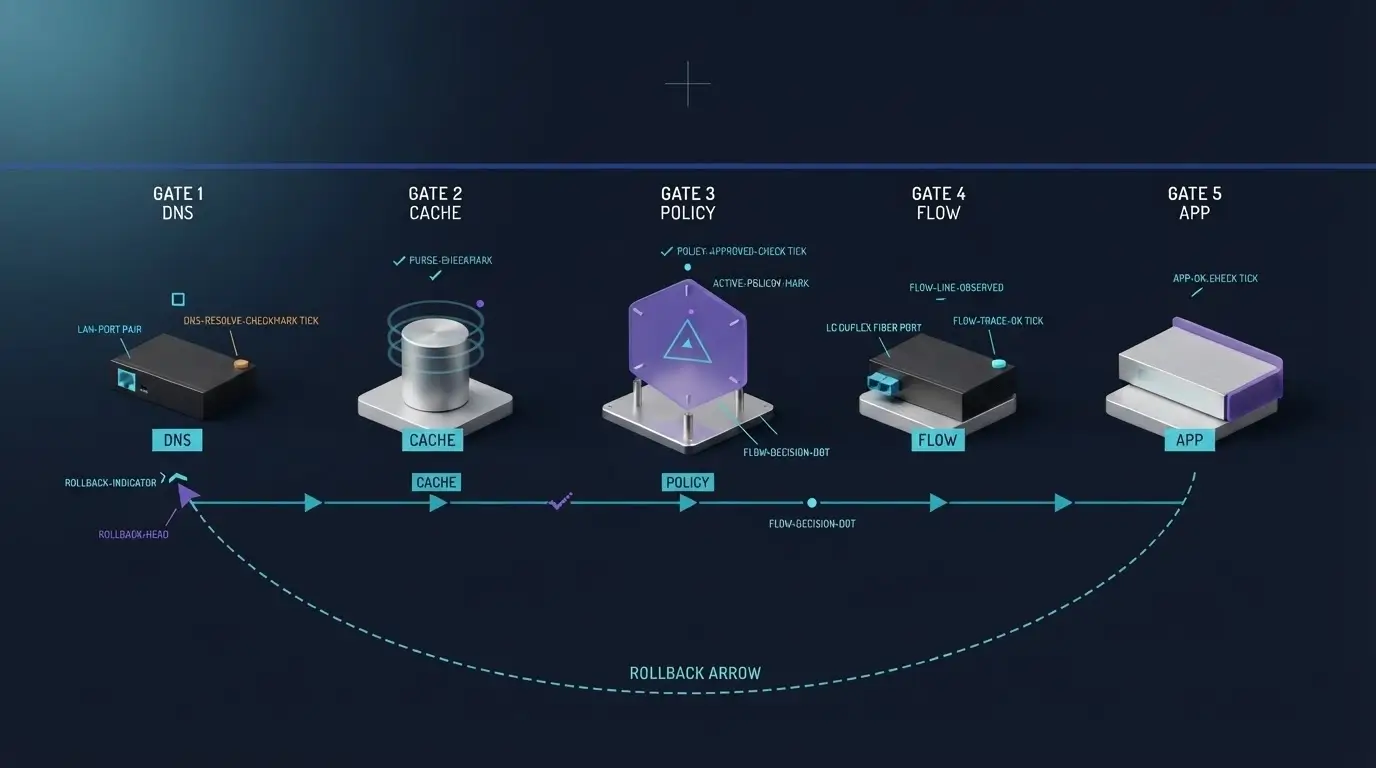
Rollout и rollback: меняйте одну границу за раз
Не накатывайте новую egress policy сразу на все inference pods. Создайте canary label или отдельный deployment с тем же образом, service account, resolver и переменными окружения. Единственное различие — новая policy. Baseline должен остаться активным: он показывает, изменилась ли внешняя сторона одновременно с вашим экспериментом.
Сначала выполните positive control к разрешённому FQDN, затем negative control к соседнему запрещённому имени и прямому IP. Прямой IP особенно важен: toFQDNs relies on наблюдаемый DNS lookup. Если обход без lookup проходит, проверьте другие additive policies. После этого дождитесь как минимум одного естественного TTL transition или воспроизведите контролируемую смену адреса в тестовом домене, которым владеете.
Stop condition запишите до rollout. Например: любой рост сетевых timeouts canary относительно baseline, появление drops для разрешённого destination после свежего DNS response или прохождение запрещённого destination. При срабатывании не расширяйте правило на лету. Верните canary к предыдущему selector/policy и повторите те же DNS, cache, flow и application проверки.
Rollback считается успешным, когда восстановилось не только число запросов, но и прежняя граница доступа. Удаление policy может сделать все egress разрешённым и визуально «починить» приложение. Это не возврат к безопасному baseline. Сохраните YAML, policy revision и Hubble evidence до и после отката; иначе расследование останется рассказом без контрфакта.
Когда выделенная инфраструктура помогает, а когда нет
Выделенный VPS, dedicated edge или отдельный Kubernetes node pool полезны, когда вам нужен контроль над resolver, Cilium version, network path, firewall policy, Hubble retention и change window. На shared-платформе часть этих границ принадлежит провайдеру: вы видите application timeout, но не можете сопоставить его с datapath verdict. Собственный edge делает evidence chain воспроизводимой и уменьшает число неизвестных владельцев.
Это не означает, что новое железо исправит FQDN policy. Оно не починит stale DNS cache внутри приложения, ошибочный endpointSelector, connection reuse старого IP или отсутствие DNS visibility. Disqualifier простой: если canary на тех же node и network path проходит после исправления selector или resolver, capacity upgrade не является лечением.
Для небольшого сервиса разумный default — не усложнять. Оставьте обычный egress через контролируемый gateway, если команда не готова сопровождать Cilium CRD, Hubble и DNS lifecycle. FQDN-aware policy оправдана, когда внешний API меняет адреса, CIDR allowlist непрактичен, а domain boundary действительно нужна для compliance или ограничения blast radius.
Когда нагрузка и требования растут, сравнивайте варианты по ownership. Managed egress снимает часть on-call debt, dedicated gateway даёт версии и change windows, а отдельный Kubernetes pool добавляет полный datapath control. Коммерческий смысл KingServers здесь не в обещании меньшей latency, а в возможности закрепить предсказуемый network baseline для canary и расследований. Архитектурный контекст для такого выбора есть в руководстве про Private AI API на своих серверах.
Итог: доменное имя — начало доказательства, а не готовое разрешение
Cilium FQDN egress полезен именно там, где IP внешнего LLM API меняются, а широкие CIDR неприемлемы. Но надёжность появляется не от строки matchName. Её даёт цепочка доказательств: DNS-запрос прошёл через наблюдаемый resolver, свежий IP оказался в cache, identity попала в effective policy нужного endpoint, Hubble показал ожидаемый verdict, а приложение завершило реальный запрос.
Начните с baseline и отрицательного контроля. Затем примените минимальную policy к canary, дождитесь TTL transition и проверьте rollback теми же командами. Если ошибка остаётся, не расширяйте allowlist наугад: локализуйте owner между runtime DNS cache, Cilium endpoint и внешним API.
Практический следующий шаг прост: возьмите один некритичный deployment, сохраните DNS/cache/policy/flow evidence и проведите controlled rollout по чек-листу из статьи. Когда для этого не хватает контроля над resolver, datapath или change window, выделенный egress-контур становится обоснованным инфраструктурным решением — с ясной причиной и проверяемым результатом.