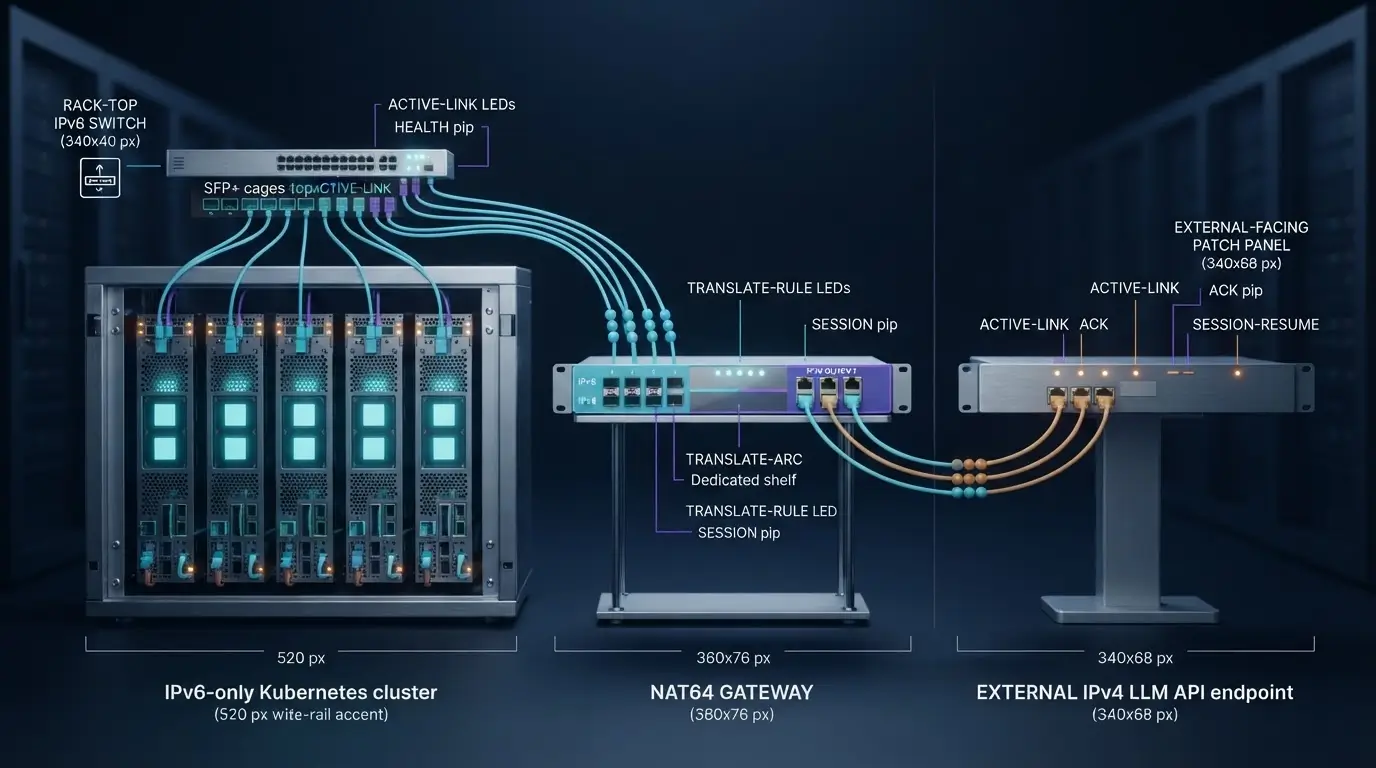
Оглавление
- Короткий вывод: когда NAT64 действительно нужен
- Сначала докажите симптом из effective namespace
- Архитектура пути: DNS64 не является NAT64
- Настройка DNS64: синтез только там, где он нужен
- Stateful NAT64: Pref64, pool4 и цена состояния
- Встраивание в Kubernetes: маршрут, CNI и egress policy
- Runbook проверки: DNS → route → session → TLS → outcome
- Пять отказов, которые легко принять за «сломанный NAT64»
- Canary, capacity и rollback без смены всей сети
- Что мониторить и кому отдавать on-call
- Итог: переводите адреса, но не смешивайте доказательства
Готовы перейти на современную серверную инфраструктуру?
В King Servers мы предлагаем серверы как на AMD EPYC, так и на Intel Xeon, с гибкими конфигурациями под любые задачи — от виртуализации и веб-хостинга до S3-хранилищ и кластеров хранения данных.
- S3-совместимое хранилище для резервных копий
- Панель управления, API, масштабируемость
- Поддержку 24/7 и помощь в выборе конфигурации
Результат регистрации
...
Создайте аккаунт
Быстрая регистрация для доступа к инфраструктуре
Короткий вывод: когда NAT64 действительно нужен
NAT64 нужен не потому, что «IPv6 современнее», а когда workload имеет только IPv6, а обязательный внешний сервис публикует только IPv4. В этом случае DNS64 синтезирует IPv6-адрес назначения, маршрут ведёт его к translator, а stateful NAT64 создаёт IPv4 flow. Если у провайдера LLM API есть рабочая AAAA-запись, этот тракт не должен участвовать: нативный IPv6 проще, прозрачнее и не расходует pool4.
Практический default консервативный: не переводите весь egress через NAT64, пока не доказали IPv4-only dependency из namespace реального Pod. Kubernetes поддерживает single-stack IPv6, а dual-stack networking имеет статус Stable с версии 1.23, однако сама платформа не превращает IPv4-only Internet в IPv6. За эту границу отвечают DNS64, translator, маршрутизация и ваша CNI-политика, а не Service API.
Disqualifier тоже важен. NAT64 не исправит stale DNS в приложении, неправильный SNI, retry storm, сломанную PMTUD или очередь внутри inference. Он добавляет stateful control point и отдельную on-call обязанность. Выбирать его стоит только тогда, когда экономия адресного пространства и единый IPv6 dataplane перевешивают стоимость этой зависимости.
Официальная модель описана в RFC 6146 и RFC 6147. Ниже мы не строим лабораторный трюк: цель — получить цепочку доказательств, которую можно повторить во время инцидента и после rollback.
Сначала докажите симптом из effective namespace
Типичный алерт выглядит расплывчато: SDK пишет connection timeout, sidecar показывает upstream reset, а бизнес видит выросший TTFT. Начинать с установки translator рано. Зайдите в тот же network namespace, где работает клиент, и сравните A и AAAA для точного hostname. Затем создайте fresh connection, чтобы pool приложения не подменил эксперимент старым сокетом.
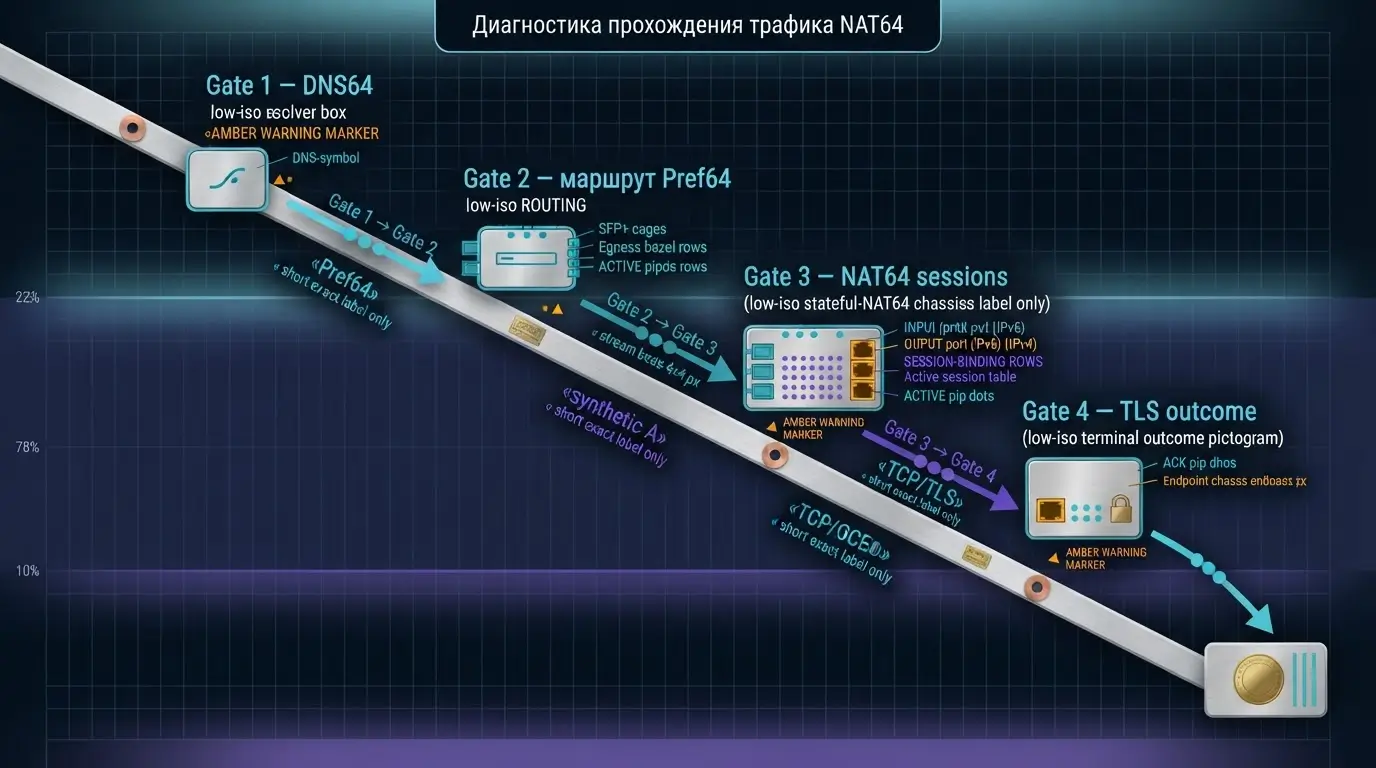
Разделите наблюдение на четыре gate. DNS answer отвечает лишь на вопрос, какой адрес получил клиент. Route gate проверяет, куда ядро отправит synthesized destination. Translation gate подтверждает BIB/session на NAT64 и фактический IPv4 peer. Application gate проверяет TLS, HTTP status, первый токен и корректное завершение SSE или gRPC stream. Пропуск одного gate превращает диагностику в догадку.
Мини-пример: Pod получает только A для API, но локальный ноутбук работает. Это не доказательство блокировки и не повод менять firewall. Ноутбук использует IPv4, а Pod — single-stack IPv6. Внутри Pod запрос AAAA останется пустым без DNS64, поэтому до TCP дело не дойдёт. И наоборот, synthesized AAAA без session на translator указывает уже не на DNS, а на route или policy.
kubectl exec -n ai-egress deploy/llm-client -- sh -ceu '
  getent ahosts api.example.net
  dig +short A api.example.net
  dig +short AAAA api.example.net
  ip -6 route get 64:ff9b::c000:0201
  curl -6 --connect-timeout 5 -sSvo /dev/null https://api.example.net/v1/models
'
Архитектура пути: DNS64 не является NAT64
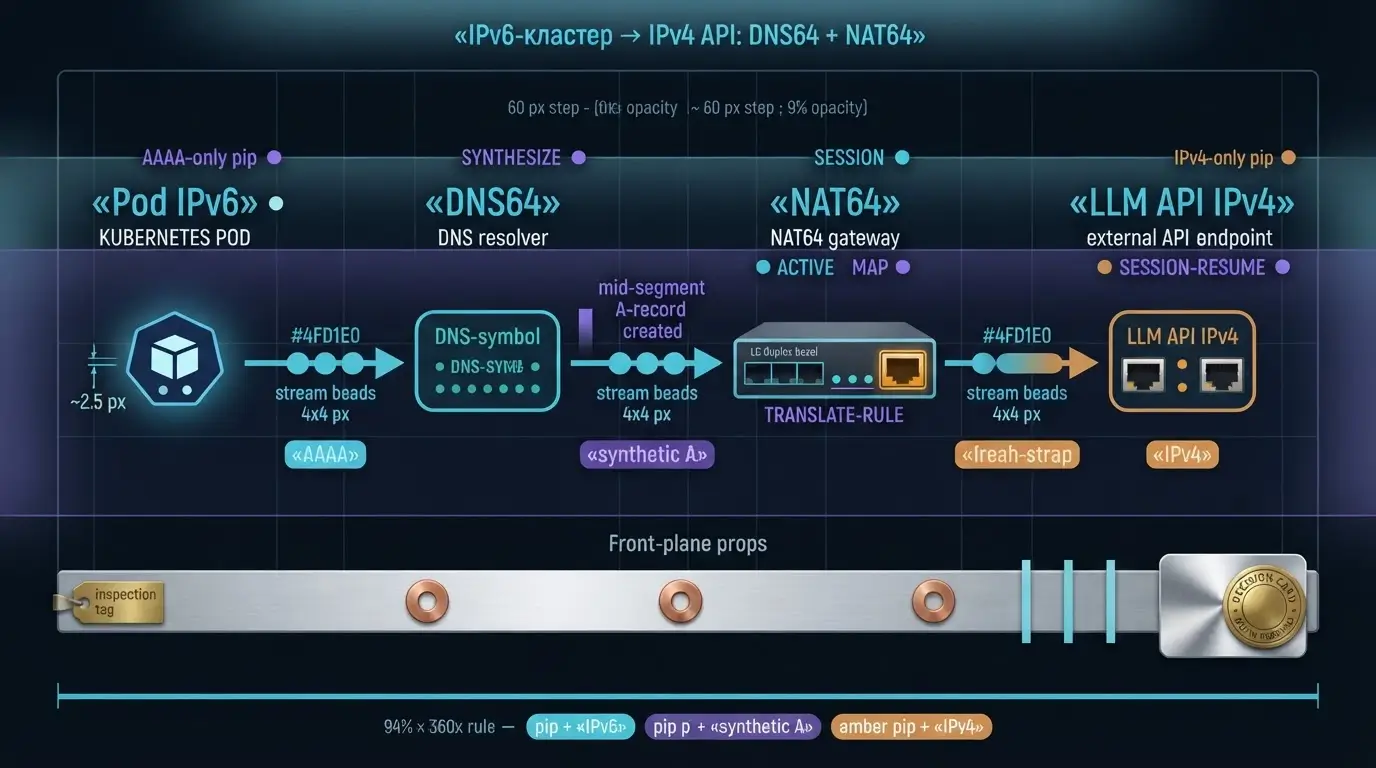
В рабочей схеме участвуют четыре независимых владельца. Рекурсивный resolver видит запрос AAAA, получает A от authoritative DNS и, если нативного AAAA нет, синтезирует адрес с Pref64. Сеть Pod знает маршрут к этому префиксу. NAT64 gateway извлекает встроенный IPv4 destination, выбирает source address и port из pool4 и хранит состояние. Внешний API видит обычное IPv4-соединение от translator.
Эта граница полезна во время инцидента. Наличие адреса вида 64:ff9b::/96 не доказывает, что NAT64 жив. Оно доказывает только политику ответа DNS64. Запись session на translator не доказывает успешный inference: TLS может завершиться ошибкой, API вернуть 429, а streaming оборваться после headers. Поэтому метрики разных слоёв нельзя складывать в один зелёный health check.
RFC 6052 задаёт форматы IPv4-embedded IPv6 address и допускает несколько длин префикса; /96 легче читать и отлаживать. Well-Known Prefix удобен, но network-specific prefix может быть уместнее в сложной маршрутизации. Критическое правило одно: DNS64 и NAT64 должны использовать один и тот же Pref64, а маршрутизаторы должны доставлять весь этот prefix к правильному translator.
Проверьте owner map до rollout. DNS-команда отвечает за синтез и DNSSEC policy, network-команда — за route и ACL, платформа — за CNI/egress, владелец приложения — за hostname, connection reuse и retry. Когда один инженер «владеет NAT64 целиком», обычно один из этих слоёв остаётся без наблюдаемости.
Настройка DNS64: синтез только там, где он нужен
Для production удобен отдельный DNS64 resolver или чётко выделенный view, а не глобальная подмена ответов для всех клиентов. Unbound документирует модуль dns64: он включается в module-config, а dns64-prefix должен совпадать с translator. Значение по умолчанию — 64:ff9b::/96. Не включайте dns64-synthall в проде: документация прямо называет его debugging feature.
Resolver должен сохранить нативный AAAA, если он существует. Это позволяет IPv6-capable API идти напрямую, а translation использовать только для IPv4-only names. В противном случае вы искусственно тянете рабочий IPv6 через IPv4 bottleneck и усложняете атрибуцию. Отдельно проверьте CNAME chain: синтез относится к конечному A RRset, а не к красивому имени в конфиге приложения.
DNSSEC требует осознанной схемы. DNS64 меняет данные ответа, поэтому валидирующий resolver должен выполнять синтез в правильной точке pipeline согласно RFC 6147. Не лечите SERVFAIL отключением validation наугад. Сравните ответ обычного validating resolver, DNS64 resolver и authoritative data; сохраните флаг AD и логи validation. Это особенно важно для внешнего AI API, где endpoint может менять CDN и набор адресов.
TTL synthesized AAAA не является временем жизни TCP-соединения. Клиентский pool способен держать старый сокет после истечения DNS cache. Этот же принцип разобран в материале о DNS failover для LLM API: DNS answer, фактический peer и application outcome нужно наблюдать отдельно.
server:
  interface: ::0
  access-control: fd20:10:20::/48 allow
  module-config: "dns64 validator iterator"
  dns64-prefix: 64:ff9b::/96
  dns64-synthall: no
Stateful NAT64: Pref64, pool4 и цена состояния
Stateful translator похож на привычный NAPT, но соединяет разные семейства адресов. Для каждого нового flow он резервирует IPv4 transport address и port, создаёт Binding Information Base и session state. Jool называет IPv4 transport pool таблицей pool4. Именно она определяет внешний source address и доступную port capacity, а не DNS64.
В Jool NAT64 префикс задаётся при создании instance. Документация предупреждает, что для NAT64 его нельзя менять на живой instance из-за синхронизации. Значит, смена Pref64 — это миграция с новым экземпляром и маршрутом, а не безобидный update flag. Конфигурацию делайте постоянной через штатный systemd/config механизм дистрибутива; tutorial-команды сами по себе reboot не переживают.
Один IPv4 address не равен бесконечному egress. Длинные SSE/gRPC connections удерживают mapping, короткие retries создают churn, а несколько tenant могут конкурировать за один pool. Наблюдайте число BIB entries и sessions по протоколам, ошибки аллокации, drops, TCP state и использование портов на каждом pool4 address. Если exhaustion проявляется только под нагрузкой, добавление CPU не исправит дефицит transport tuples.
Начальная проверка должна включать TCP, UDP и ICMP отдельно. HTTPS использует TCP, но DNS, telemetry и диагностические инструменты могут идти иначе. PMTU и ICMP translation критичны для длинных ответов: потерянный ICMPv6 Packet Too Big способен оставить handshake рабочим, а большой streaming payload — зависшим. Это тот случай, когда «curl /health работает» даёт ложное спокойствие.
sudo modprobe jool
sudo jool instance add "ai-egress" --netfilter --pool6 64:ff9b::/96
sudo jool -i "ai-egress" pool4 add --tcp 203.0.113.10 1024-65535
sudo jool -i "ai-egress" pool4 add --udp 203.0.113.10 1024-65535

sudo jool instance display
sudo jool -i "ai-egress" pool4 display
sudo jool -i "ai-egress" bib display --tcp
sudo jool -i "ai-egress" session display --tcp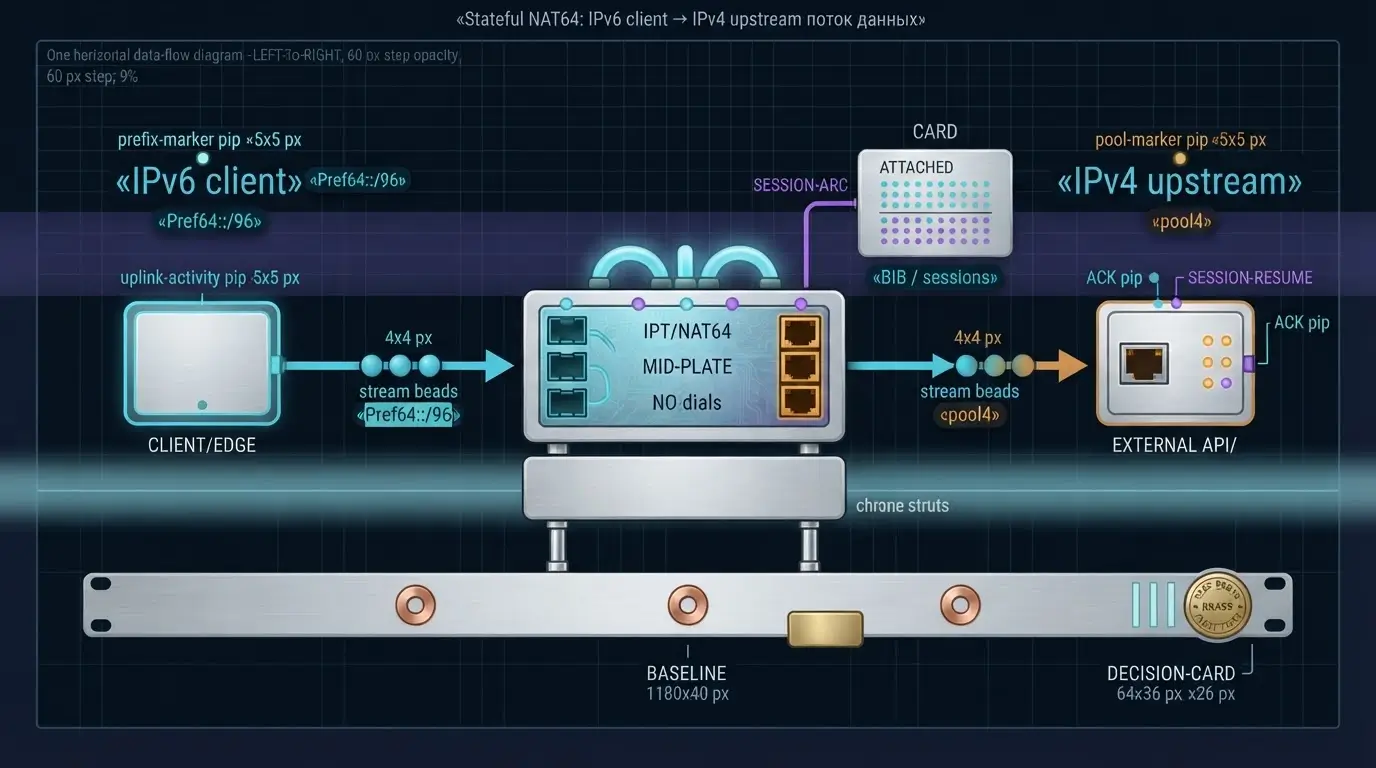
Встраивание в Kubernetes: маршрут, CNI и egress policy
Kubernetes классифицирует кластер по IP families, записанным в Pod, Service и Node objects. Дополнительный адрес на host interface сам по себе не превращает IPv6-only cluster в dual stack. Официальная документация также требует поддержки IPv6 со стороны CNI. Поэтому сначала зафиксируйте реальный Pod CIDR, Service CIDR, node addresses и поведение выбранного dataplane, а уже затем проектируйте маршрут Pref64.
Есть два распространённых размещения translator: выделенная gateway-пара или egress nodes внутри платформы. Выделенный gateway даёт ясный failure domain и независимый lifecycle. Egress node упрощает близость к Pod, но связывает translation с scheduling, upgrades и политикой CNI. В обоих случаях нужен next hop для Pref64, обратный IPv4 route к pool4 address и firewall, который различает транзитный трафик и management plane.
FQDN policy не заменяет DNS64. Она решает, какие destinations разрешены workload, но должна увидеть те адреса, которые реально использует dataplane. Если CNI кэширует DNS answers, сравните кэш endpoint с ответом resolver. Подробная схема такой проверки есть в статье о Cilium FQDN egress для LLM API. Для canary сохраните разрешённый IPv4-only hostname и запрещённый hostname как negative control.
Не завязывайте route на случайный node, который может быть drained. Используйте устойчивый next hop, ECMP только при совместимой state symmetry или state sharing, и health withdrawal, который проверяет не процесс, а способность translator создавать новые sessions. Асимметричный ответ через другой stateful gateway часто выглядит как редкий TCP reset и особенно больно проявляется на streaming.
kubectl get nodes -o wide
kubectl get pods -A -o wide
kubectl get svc -A -o custom-columns=NS:.metadata.namespace,NAME:.metadata.name,FAMILIES:.spec.ipFamilies,IPS:.spec.clusterIPs

kubectl exec -n ai-egress deploy/llm-client --   ip -6 route get 64:ff9b::c000:0201
kubectl exec -n ai-egress deploy/llm-client -- tracepath6 -n 64:ff9b::c000:0201Runbook проверки: DNS → route → session → TLS → outcome
Проверяйте один hostname и один request id по всей цепочке. Сначала получите A и AAAA через тот resolver, который записан в /etc/resolv.conf Pod. Если AAAA synthesized, извлеките embedded IPv4 и сравните его с A. Затем проверьте route к адресу и одновременно смотрите session table на translator. Только после появления state переходите к TLS и HTTP.
TLS-тест выполняйте с исходным hostname, иначе вы меняете SNI и проверку сертификата. Соединение к synthesized IP с Host header, но без корректного SNI, не эквивалентно SDK. Для streaming endpoint фиксируйте время до headers, первый data frame и нормальное завершение. Reset после headers — отдельный failure mode, его нельзя считать обычным connect error и безусловно retry.
Нужны два отрицательных контроля. Native IPv6 endpoint должен обходить NAT64 и не создавать session. Заведомо запрещённый hostname или destination должен оставаться недоступным. Если оба теста «проходят» через один gateway, policy шире ожидаемой. Ещё один полезный контроль — fresh client без connection pool: он отделяет новый DNS/route от уже открытого transport.
Соберите evidence в один временной ряд: query/answer, selected destination, route next hop, BIB/session tuple, TLS result, HTTP status и application latency. Не пытайтесь вывести улучшение SLO из роста sessions. Translator может исправно создавать state, пока upstream возвращает 429 или GPU queue растёт.
API=api.example.net

dig +dnssec AAAA "$API"
dig +dnssec A "$API"
openssl s_client -connect "$API:443" -servername "$API" -brief 
Пять отказов, которые легко принять за «сломанный NAT64»
Первый — неправильный DNS view. Инженер проверяет корпоративный resolver, а Pod использует CoreDNS с другим upstream. Снимайте ответ внутри workload. Второй — Pref64 mismatch. DNS64 кодирует IPv4 в одном prefix, а route и Jool настроены на другой. Адрес выглядит правдоподобно, но translator его не принимает.
Третий — pool4 exhaustion. Симптом возникает на пике, новые connections timeout, а существующие streams продолжаются. Считайте transport tuples и churn. Родственная диагностика разобрана в runbook про conntrack и SNAT для LLM API, но ownership таблиц здесь другой: state живёт на NAT64.
Четвёртый — PMTU black hole. TLS может пройти на небольших пакетах, а длинный ответ зависает. Не блокируйте ICMPv6 бездумно, проверяйте Packet Too Big и effective MTU через весь path. Практика похожа на расследование WireGuard MTU и PMTUD: маленький probe не доказывает здоровье data path.
Пятый — application reuse. После изменения DNS64 клиент продолжает использовать старый connection. Перезапуск Pod кажется «магическим исправлением», хотя причина в pool lifecycle. Сравните fresh и reused connections, TTL resolver cache, SDK keepalive и drain policy. Не уменьшайте TTL до секунд без нужды: это увеличивает query load, но не закрывает открытые sockets.
Canary, capacity и rollback без смены всей сети
Начните с маленькой группы Pod и одного IPv4-only dependency. Baseline должен остаться неизменным: dual-stack или существующий IPv4 egress для сопоставимой нагрузки. На canary измеряйте DNS failures, route failures, session allocation, connect latency, TLS errors, HTTP codes, TTFT и долю завершённых streams. Сравнивайте одинаковые окна и запросы, не случайный утренний baseline с вечерним пиком.
Capacity planning строится снизу вверх. Оцените одновременные transport flows, среднюю длительность streaming connection, churn от retries и запас портов на pool4. Затем проверьте CPU, память session table и throughput translator. Не публикуйте универсальное число requests per second: оно зависит от packet size, connection lifetime, реализации, kernel и observability overhead. Нагрузочный тест должен повторять ваш mix, включая отмены и half-closed connections.
Rollback должен быть симметричен rollout. Верните canary на прежний resolver/route, дождитесь drain новых NAT64 sessions и повторите те же probes. Резкое удаление Pref64 route оборвёт активные flows и смешает сетевой rollback с application errors. Зафиксируйте, кто принимает решение, какое условие останавливает расширение и как долго хранятся диагностические логи.
Выделенный VPS или dedicated gateway оправдан, когда вам действительно нужен контроль kernel/module versions, route advertisement, pool4 addresses, telemetry и change window. Он не исправит неверный DNS view, SDK pooling или upstream throttling. Коммерческая ценность здесь — воспроизводимая граница управления и предсказуемый blast radius, а не обещание «ускорить NAT» без canary evidence.
Перед расширением оцените отказ самого translator. Потеря одного gateway не должна молча отправлять Pref64 в black hole. Routing health должен убрать next hop только после проверки data path, а восстановление возвращать его постепенно. Для active/passive заранее решите судьбу существующих sessions: без репликации state они оборвутся, поэтому приложение обязано различать безопасный retry до commitment и опасный retry после начала ответа.
Что мониторить и кому отдавать on-call
Минимальный dashboard должен быть разложен по тем же evidence gates, что и runbook. Для DNS64 нужны latency, SERVFAIL/NXDOMAIN, доля synthesized answers и validation failures. Для route — reachability Pref64 и next-hop changes. Для NAT64 — BIB, sessions, allocation failures, drops, port utilization и resource saturation. Для приложения — connect/TLS error, HTTP code, TTFT, stream completion и retries.
Алерт «NAT64 down» почти бесполезен. Лучше алертировать нарушение инварианта: DNS64 выдал synthesized AAAA, но session не появилась; sessions создаются, но TLS failures выросли; TLS успешен, но completion rate упал. Такое условие сразу сужает owner и сохраняет контекст. Health probe translator должен включать реальный translation path к контролируемому IPv4 target, а не только проверку процесса.
Обновления Jool, kernel, resolver или CNI проводите раздельно. Иначе при регрессии вы не узнаете, какой слой изменил packet handling. Для HA проверьте, что routing не отправляет обратный трафик на gateway без state. Если используете active/passive, тестируйте failover с живыми и новыми flows отдельно: сохранение IP не означает сохранение session table.
Наконец, документируйте зависимости внешнего API. Endpoint может получить native IPv6, сменить CDN или добавить новый hostname. Ежемесячная проверка A/AAAA и traffic inventory позволяет удалить NAT64 из пути там, где он больше не нужен. Лучшая stateful dependency — та, которую команда умеет безопасно обойти.
Отдельно следите за экономикой отказа. Stateful gateway может быть технически здоров, но стать общей очередью для нескольких продуктов: чат-бота, batch enrichment и фоновых evals. Разделите трафик хотя бы метками, source prefixes или отдельными pool4 ranges, чтобы один tenant не выедал port budget незаметно для остальных. Квоты должны ограничивать новые flows и retries, а не только суммарные байты. Для длинного streaming-запроса количество открытых sessions важнее мгновенного RPS.
Логи translator полезны лишь вместе с correlation data, которое не раскрывает секреты. Храните время, protocol, внутренний source prefix, выбранный pool4 tuple, destination и причину drop; API keys и содержимое prompt в сетевой журнал не попадают. Синхронизация времени на nodes, resolver и gateway обязательна: без неё DNS answer и session выглядят несвязанными событиями. Установите срок хранения, достаточный для расследования редких обрывов, и проверьте, что sampling не выкидывает именно ошибки аллокации.
Для дежурного подготовьте короткую карточку решения. Если нет synthesized AAAA, владелец resolver проверяет policy и upstream A. Если AAAA есть, но route ведёт не на gateway, инцидент у network layer. Если session создаётся, но TLS не проходит, подключается владелец trust store и endpoint configuration. Если TLS успешен, а stream не завершён, приоритет у application и PMTU evidence. Такая маршрутизация сокращает переключения между командами и не превращает NAT64 в универсального виновника.
Итог: переводите адреса, но не смешивайте доказательства
NAT64 и DNS64 дают IPv6-only Pod доступ к IPv4-only LLM API, но это не единый «сетевой переключатель». DNS64 отвечает за синтез адреса, маршрут — за доставку к Pref64, translator — за stateful mapping, а приложение — за TLS и полезный результат. Когда эти доказательства разделены, timeout перестаёт быть загадкой: видно, на каком gate оборвалась цепочка.
Начните с одного hostname и canary workload. Получите A/AAAA внутри Pod, подтвердите route и session, затем проверьте SNI, HTTP и завершение stream. Сохраните native IPv6 и запрещённый destination как negative controls, а rollback прогоните теми же командами. После этого можно обсуждать расширение pool4, HA и выделенную инфраструктуру.
Практический следующий шаг прост: возьмите чек-лист canary из статьи и выполните его на staging с реальным SDK. Если owner map, метрики или rollback пока не сходятся, не расширяйте translation на весь кластер. Сначала сделайте путь наблюдаемым — это дешевле, чем искать редкий reset уже под production-нагрузкой.