Оглавление
- Быстрый диагноз: когда виноват обратный маршрут
- Нарисуйте effective path, а не желаемую архитектуру
- Как Linux выбирает таблицу и next hop
- rp_filter: защита от spoofing, которая раскрывает асимметрию
- fwmark и conntrack: как помнить входной uplink
- Kubernetes меняет owner, но не физику пути
- Evidence ladder: от пакета к ответу модели
- Canary и rollback без потери управления
- Что мониторить после исправления
- Когда нужен отдельный VPS или dedicated edge
- Итог: симметрия — не цель, цель — доказуемый path contract
Готовы перейти на современную серверную инфраструктуру?
В King Servers мы предлагаем серверы как на AMD EPYC, так и на Intel Xeon, с гибкими конфигурациями под любые задачи — от виртуализации и веб-хостинга до S3-хранилищ и кластеров хранения данных.
- S3-совместимое хранилище для резервных копий
- Панель управления, API, масштабируемость
- Поддержку 24/7 и помощь в выборе конфигурации
Результат регистрации
...
Создайте аккаунт
Быстрая регистрация для доступа к инфраструктуре
Быстрый диагноз: когда виноват обратный маршрут
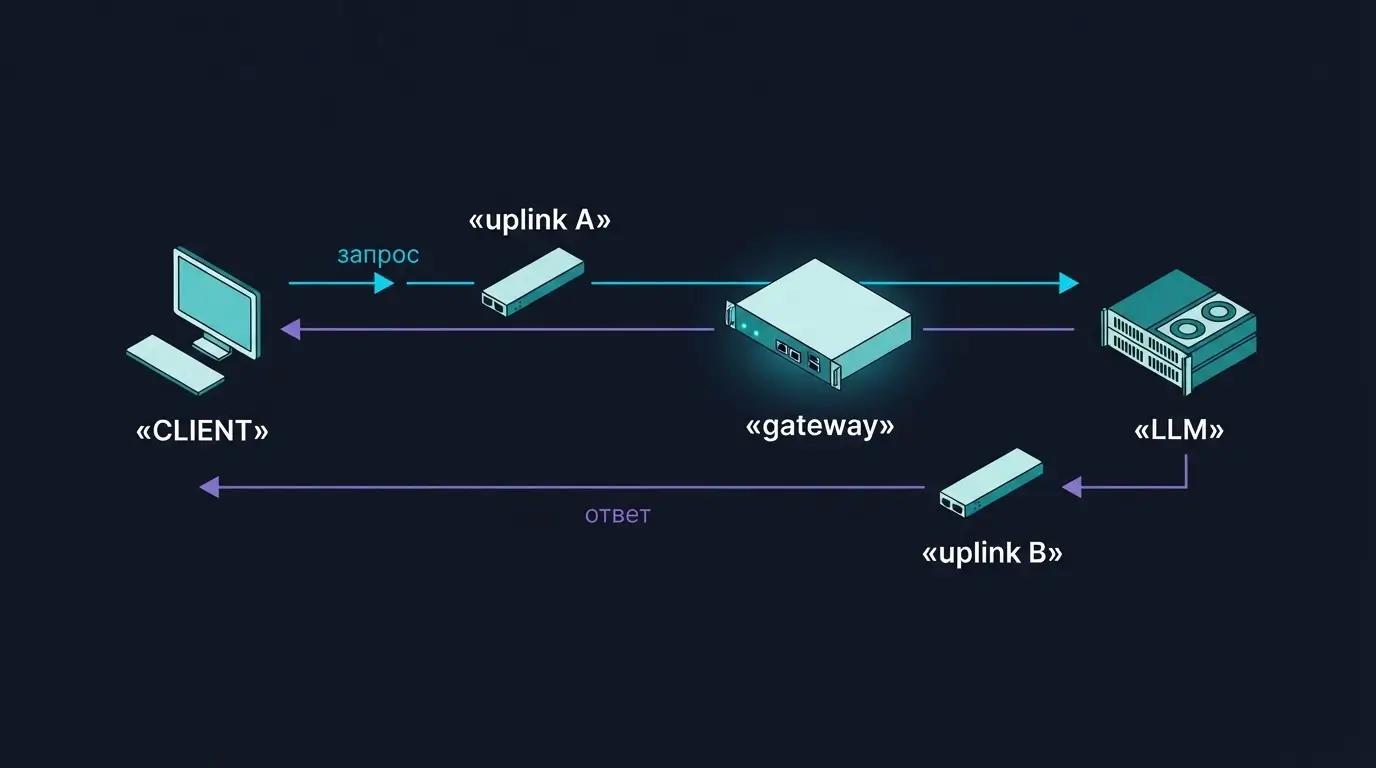
Главный признак асимметрии прост: SYN или HTTP-запрос приходит через один uplink, а Linux выбирает для ответа другой. Интернет допускает разные пути туда и обратно, но в реальном gateway между ними стоят reverse path validation, stateful firewall, NAT, балансировщик провайдера и антиспуфинг. Любой владелец состояния может отбросить пакет, хотя LLM API и GPU обслуживают соседние запросы.
Правильный default — не менять сервер и не выключать фильтрацию наугад. Сначала докажите четыре факта: на каком интерфейсе виден входящий пакет; какое решение принимает RPDB/FIB; проходит ли source validation; получает ли клиент ответ на новом соединении. Если один факт неизвестен, увеличение timeout или количества proxy workers лишь растягивает инцидент.
Типичный кейс: у gateway два публичных адреса, но в таблице main один preferred default route. Запрос к адресу uplink B приходит нормально, приложение отвечает с тем же source IP, однако маршрут до клиента выбирается через A. Ответ может потеряться у провайдера из-за source filtering или раньше — на локальном rp_filter. Симптом плавающий, потому что для части клиентов best path случайно совпадает.
Здесь мы не строим универсальную BGP-схему. Задача уже: локализовать owner асимметрии на multihomed Linux gateway, исправить policy routing минимальным изменением и проверить результат A/B/A canary. В Kubernetes сначала выясните, где живут адрес, NAT и route decision: на node, host-network proxy, внешнем балансировщике или в CNI dataplane.
Нарисуйте effective path, а не желаемую архитектуру
Возьмите одну проблемную сессию и разложите её по hop: client → provider edge → NIC gateway → nftables/conntrack → proxy → backend → обратный путь. Не подменяйте эту карту диаграммой из документации. После failover, миграции адреса или изменения CNI фактический owner route decision часто оказывается не там, где его ожидает дежурный.
Снимайте evidence одновременно на обоих внешних интерфейсах. Если входящий SYN виден на wan_b, а SYN-ACK уходит через wan_a, приложение уже оправдано: проблема ниже L7. Если SYN-ACK не появляется нигде, проверяйте локальную доставку, firewall, listen socket и source validation. Если оба направления видны на правильном интерфейсе, переносите точку наблюдения к провайдеру или клиенту.
Для LLM streaming есть ловушка. Уже установленный HTTP/2, WebSocket или SSE-сеанс может продолжать работать после смены маршрута, пока новые подключения падают. И наоборот, короткий health check зелёный, а длинный stream обрывается при state timeout. Baseline должен включать fresh connection, первый полезный байт, несколько фрагментов ответа и корректное закрытие.
Сохраните время, 5-tuple, входной интерфейс, source address и ожидаемый uplink. Полезно сверить материал о PROXY protocol и реальном IP клиента: адрес в L7-заголовке не доказывает peer, увиденный ядром.
ip -br -4 address
ip -4 rule show
ip -4 route show table all
ip -4 route get 192.0.2.44 from 203.0.113.10
sysctl net.ipv4.conf.all.rp_filter
sysctl net.ipv4.conf.wan_a.rp_filter
sysctl net.ipv4.conf.wan_b.rp_filter
tcpdump -ni wan_a 'host 192.0.2.44 and tcp port 443'
tcpdump -ni wan_b 'host 192.0.2.44 and tcp port 443'Как Linux выбирает таблицу и next hop
Обычная таблица отвечает на вопрос «куда отправить пакет к destination». Policy routing добавляет предыдущий уровень: какую таблицу спросить. По ip-rule(8), RPDB последовательно проверяет rules; меньшее число priority означает более высокий приоритет. Селектор может учитывать source prefix, incoming interface, fwmark, протокол и порты.
По умолчанию Linux создаёт rules для local, main и default. Ошибка начинается, когда команда добавляет вторую таблицу, но забывает уникальный priority, connected route или явный source. ip route show table 200 может выглядеть убедительно, а реальный lookup до клиента всё равно заканчивается в main.
Используйте ip route get, а не только show. Руководство ip-route(8) поясняет: get разрешает маршрут так, как будто ядро отправляет пакет. Передавайте destination, source, mark и при необходимости iif. Так фраза «таблицы вроде правильные» превращается в проверяемое решение.
Для локально терминированного TLS простой шаблон — source-based rule: ответы с публичного адреса B ищут маршрут в таблице B. Для транзитного proxy или NAT этого мало: исходный source на обратном пакете другой, а ingress придётся помнить через mark и conntrack. Не смешивайте два кейса в одном change.
ip route replace 198.51.100.0/24 dev wan_a src 198.51.100.10 table 100
ip route replace default via 198.51.100.1 dev wan_a table 100
ip rule add priority 100 from 198.51.100.10/32 lookup 100

ip route replace 203.0.113.0/24 dev wan_b src 203.0.113.10 table 200
ip route replace default via 203.0.113.1 dev wan_b table 200
ip rule add priority 110 from 203.0.113.10/32 lookup 200

ip route get 192.0.2.44 from 203.0.113.10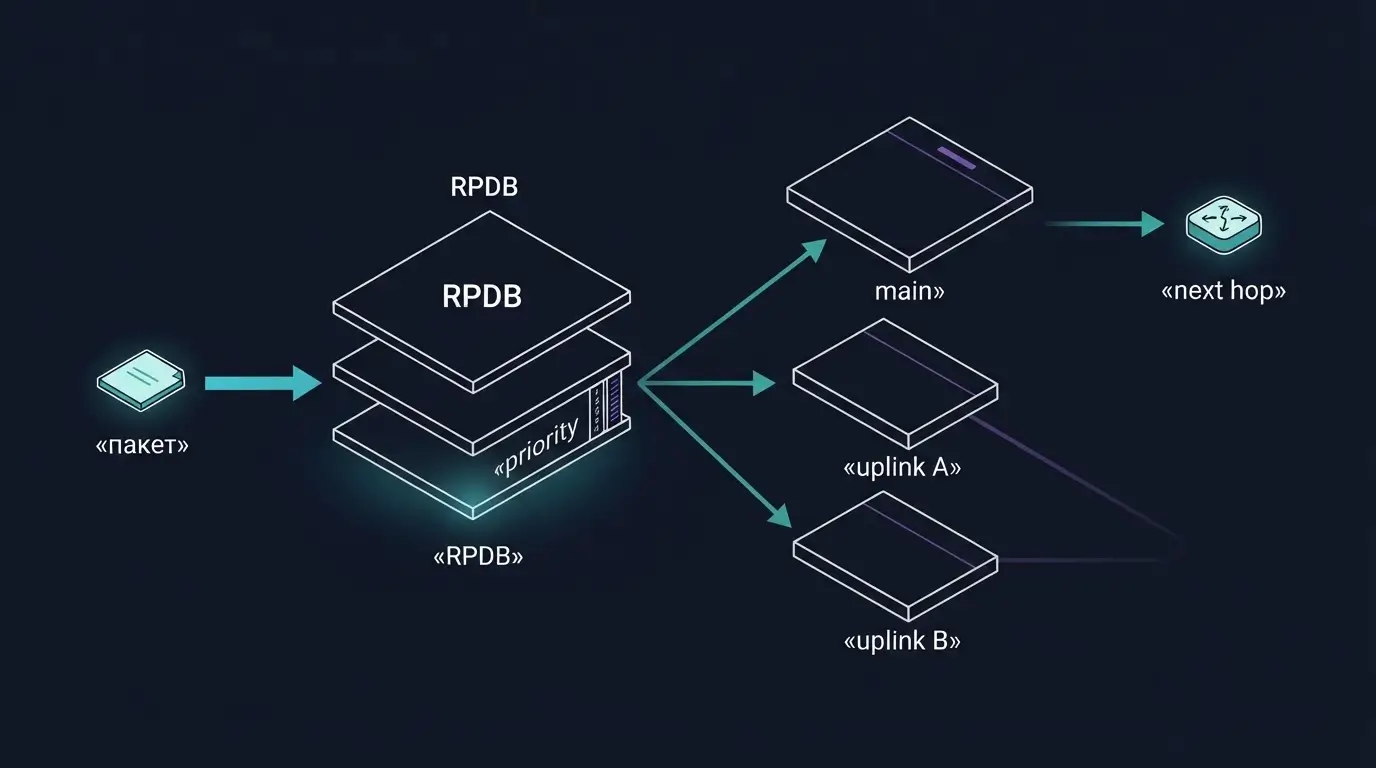
rp_filter: защита от spoofing, которая раскрывает асимметрию
rp_filter проверяет достижимость source входящего IPv4-пакета. Strict mode 1 требует, чтобы входной интерфейс совпадал с лучшим обратным путём. Loose mode 2 достаточно маршрута к source через любой интерфейс. Значение 0 отключает проверку. Определения и правило выбора максимума между conf/all и conf/interface приведены в документации Linux kernel.
Отсюда частая ошибка: инженер выставляет wan_b.rp_filter=0, но all.rp_filter=1 оставляет effective strict mode. Вторая ошибка — глобально выключить проверку, получить зелёный тест и объявить проблему решённой. Так доказана связь с reverse-path validation, но одновременно расширена trust boundary.
RFC 3704 объясняет trade-off: strict RPF подходит для симметричного пути, а при неизбежной асимметрии применяют loose RPF или более полный фильтр. Loose mode не равноценен: он проверяет наличие маршрута, но не направление. Нужны ingress ACL, anti-spoofing у провайдера и наблюдаемость martian drops.
Сначала почините RPDB, если ответ должен возвращаться через тот же uplink. Переводите конкретный multihomed interface в loose mode лишь когда асимметрия задумана. Проверяли ли вы effective значение после загрузки sysctl-профилей дистрибутива?
sysctl net.ipv4.conf.all.rp_filter
sysctl net.ipv4.conf.wan_a.rp_filter
sysctl net.ipv4.conf.wan_b.rp_filter
sysctl net.ipv4.conf.all.src_valid_mark
sysctl net.ipv4.conf.wan_a.src_valid_mark
sysctl net.ipv4.conf.wan_b.src_valid_mark
nstat -az | grep -E 'IPReversePathFilter|InNoRoutes|InDiscards'
journalctl -k --since '-15 min' | grep -Ei 'martian|reverse path'
fwmark и conntrack: как помнить входной uplink
Когда gateway пересылает трафик, source-based rule часто не выражает нужную политику. Требование иное: «ответ этой сессии должен уйти тем uplink, через который она пришла». Новый ingress flow получает ct mark, последующие пакеты восстанавливают её в packet mark, а ip rule fwmark выбирает таблицу. Mark переносит контекст между netfilter и RPDB.
Порядок hooks критичен. Mark восстанавливают до route lookup обратного пакета. Для локально созданного ответа nftables chain с hook output и type route позволяет повторить lookup; для forwarded traffic mark обычно восстанавливают в prerouting. Схема зависит от того, где заканчивается TLS и где применяется NAT.
src_valid_mark=1 включает fwmark в reverse-path lookup. Это нужно, когда одна mark-политика участвует в обоих направлениях и strict source validation должна видеть соответствующую таблицу. Не включайте параметр «на всякий случай»: сначала покажите ip route get ... mark ..., иначе появится ещё одна скрытая зависимость.
Conntrack хранит выбор пути, но не доказывает здоровье приложения. Запись ESTABLISHED не означает, что клиент получил токены. Для длинного stream проверяйте цепочку: mark восстановлена, route совпал, пакет ушёл, remote peer подтвердил получение, application SLO сохранён.
table inet route_policy {
  chain prerouting {
    type filter hook prerouting priority mangle; policy accept;
    iifname "wan_b" ct state new ct mark set 0x2
    ct mark != 0 meta mark set ct mark
  }
  chain output {
    type route hook output priority mangle; policy accept;
    ct mark != 0 meta mark set ct mark
  }
}
ip rule add priority 90 fwmark 0x2/0xff lookup 200
ip route get 192.0.2.44 from 203.0.113.10 mark 0x2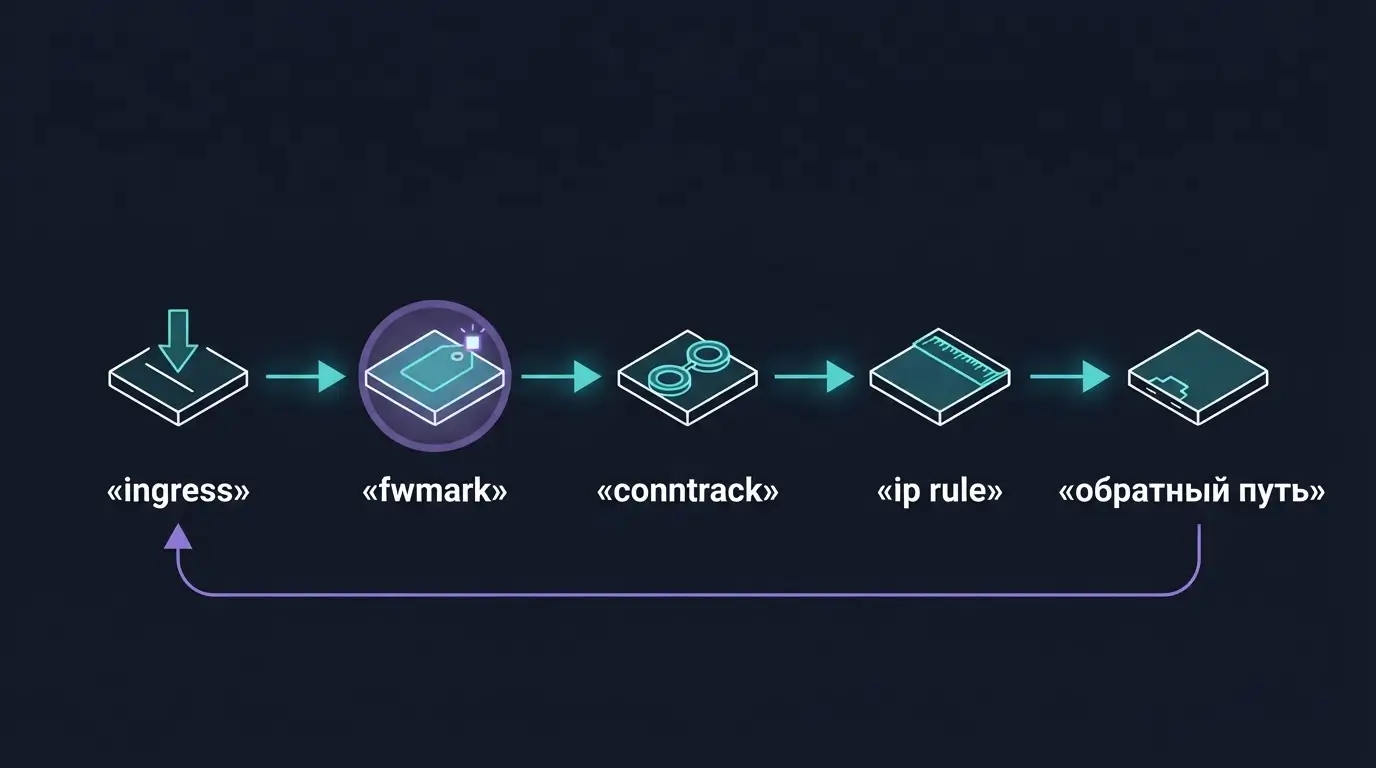
Kubernetes меняет owner, но не физику пути
В Kubernetes тот же симптом возникает на разных слоях. Service с externalTrafficPolicy: Local сохраняет client source IP и направляет внешний трафик только на nodes с local endpoint, но обратный маршрут всё равно выбирает node network stack или CNI. Host-network ingress, eBPF dataplane и iptables kube-proxy оставляют разный evidence.
Не начинайте с массового sysctl change. Выберите один адрес, одну node и один endpoint; зафиксируйте, где пакет входит в physical NIC, появляется ли в pod namespace и какой peer видит приложение. Сравните node с локальным endpoint и node без него как negative control. Разбор MetalLB, BGP и ECMP полезен уровнем выше: route advertisement не заменяет проверку обратного FIB.
Отдельно смотрите на CNI marks и rules. Dataplane может резервировать диапазоны fwmark, собственные RPDB priorities и tables. Случайный 0x2 из лаборатории способен конфликтовать с production policy. Экспортируйте state до canary, найдите владельца каждой mark и применяйте маску, согласованную с документацией вашей версии CNI.
Связь с AI здесь операционная. Один streaming request удерживает connection дольше REST-вызова; после route churn старые и новые sessions ведут себя по-разному. Проверка включает короткий запрос, streaming response и повтор после drain. Зелёный readiness probe не доказывает устойчивый inference path.
Evidence ladder: от пакета к ответу модели
Хороший runbook не прыгает от ошибки клиента к sysctl. Gate 1 — ingress: SYN пришёл на ожидаемый интерфейс. Gate 2 — policy: ip rule выбрала нужную таблицу, а ip route get вернул правильные device, gateway и source. Gate 3 — state: firewall, conntrack и source validation не уничтожили пакет. Gate 4 — outcome: новый клиент получил прикладной ответ.
Для каждого gate нужен negative control. Сравните здоровый клиентский prefix, второй публичный адрес или baseline через один uplink. Если оба пути ломаются одинаково, асимметрия не объясняет симптом. Если проблема следует за адресом B, но не за node, проверяйте policy и upstream. Если следует за node при любом адресе, owner, вероятно, локален.
Снимайте capture ближе к провалу. Захват на any удобен сначала, но скрывает направление и offload-агрегацию. Нужны отдельные interface captures с одинаковым filter. Материал о RSS, RPS и IRQ affinity поможет, если путь верен, а потери связаны с RX queue или CPU; это соседний класс причин.
Не добивайтесь симметрии любой ценой. Иногда requirement — принимать через любой edge и отвечать через preferred egress. Тогда проверяется contract: upstream принимает source prefix, stateful middleboxes видят обе стороны либо не зависят от состояния, а ingress filtering остаётся полным.
Canary и rollback без потери управления
Canary должен менять одного owner. Если одновременно добавить table, переключить rp_filter, обновить CNI и перенести VIP, зелёный результат не объяснит причину. Начните с временной rule для одного source address или fwmark, направьте synthetic traffic и сохраните baseline через старый путь.
Перед изменением запишите ip rule save, затронутые tables, nftables ruleset и sysctl. Но rollback — не просто удаление. После возврата повторите те же probes: route lookup, capture на interfaces, fresh application request. Если симптом не вернулся в A/B/A, связь вероятна, но не доказана.
Stop condition задайте заранее: connection errors, неожиданный egress, отсутствие client response, martian drops или конфликт mark. Не ждите массового SLO breach. Для streaming API canary проходит handshake, первый token, несколько chunks и normal close; не используйте production prompts с чувствительными данными.
После успеха закрепите configuration в network manager или automation. Ручные ip rule add исчезнут после reboot или пересоздания namespace. Проверяйте cold boot, failover каждого uplink и возврат primary path. Самый неприятный вариант — схема работает после ручного вмешательства, но пропадает при плановом обновлении.
Что мониторить после исправления
Маршрут может быть правильным во время canary и снова сломаться после DHCP renewal, cloud-init, network manager reload или смены BGP next hop. Проверяйте effective state, а не файл конфигурации. Собирайте snapshot rules и tables после каждого change event; сравнивайте priority, default route, preferred source и fwmark masks.
Полезны counters nftables rules, martian logs в ограниченном режиме, conntrack insert/drop, interface drops и доля новых соединений без application response. Метрики связывайте временем и адресом. Рост InDiscards без проблемного flow — слабое evidence; capture конкретного SYN и отсутствующего SYN-ACK сильнее.
На L7 отделяйте connect failure, TLS failure, time to first byte, межфрагментный timeout и premature close. Асимметричный path чаще поражает создание соединения или state transition, тогда как inference queue ухудшает time to first token при здоровом transport. Routing change не лечит backend queue, proxy buffering, retry storm или перегруженный GPU.
Проверяйте dual-stack раздельно. IPv4 rp_filter ничего не говорит о IPv6 path. Happy Eyeballs может маскировать отказ одной семьи fallback-ом; подробный подход есть в статье про IPv6 и Happy Eyeballs.
Когда нужен отдельный VPS или dedicated edge
Procurement default консервативен: не меняйте платформу, пока не доказан control gap. Ошибочный priority в RPDB одинаково ломает VM и dedicated server. Loose rp_filter без ingress policy не становится безопаснее от дополнительного CPU.
VPS подходит, когда нужен отдельный software edge с двумя логическими uplink, воспроизводимой ОС и независимым change window, а физический NIC ownership не критичен. Dedicated edge оправдан, когда команда контролирует NIC, queue/NUMA placement, driver/firmware, upstream sessions и failure domain. Managed load balancer снимает часть on-call, но оставляет меньше packet evidence.
Ценность — не обещание меньшей latency. Это возможность закрепить route tables, sysctl, firewall, telemetry и rollback за одним владельцем, проверить reboot/failover и сохранить baseline между узлами. Если workload упирается в inference queue, исправляйте scheduler или capacity. Если проблема в route ownership, отдельный edge сокращает число скрытых участников.
Общий контекст архитектуры есть в руководстве по Private AI API на своих серверах. Оно отвечает, где разместить gateway и observability; этот runbook закрывает более узкий вопрос — как доказать правильный обратный путь.
Итог: симметрия — не цель, цель — доказуемый path contract
Асимметричная маршрутизация сама по себе не ошибка. Ошибка появляется, когда Linux, firewall, provider filtering и приложение по-разному понимают допустимый путь. Исправление начинается с одного flow: ingress interface → RPDB/FIB → source validation и state → application outcome.
Для локального proxy часто достаточно source-based tables с явными priorities. Для forwarded/NAT path понадобится сохранение mark в conntrack и восстановление до route lookup. rp_filter выбирайте как часть threat model: strict для симметричного edge, loose только для доказанной асимметрии с компенсирующей ingress-защитой.
Следующий шаг — взять один проблемный клиентский адрес, выполнить baseline, провести A/B/A canary и записать owner каждого решения. Если control gap остаётся в общей инфраструктуре, перенос gateway на VPS или dedicated edge становится инженерным решением с понятной причиной, а не дорогой попыткой угадать.