Power cap для GPU в LLM inference: production-runbook без гадания по ваттам
Практический runbook для безопасного ограничения мощности GPU: baseline, canary, DCGM и vLLM-метрики, energy-per-token, rollout и rollback.
Production-runbook по fs-verity для весов LLM: pinned revision, дерево Меркла, trusted manifest, systemd gate, отрицательные тесты и безопасный rollback на GPU-сервере.
Практический runbook по I/O-изоляции LLM-узла: cgroup v2 io.max, systemd slices, PSI, два gate, canary rollout и rollback.
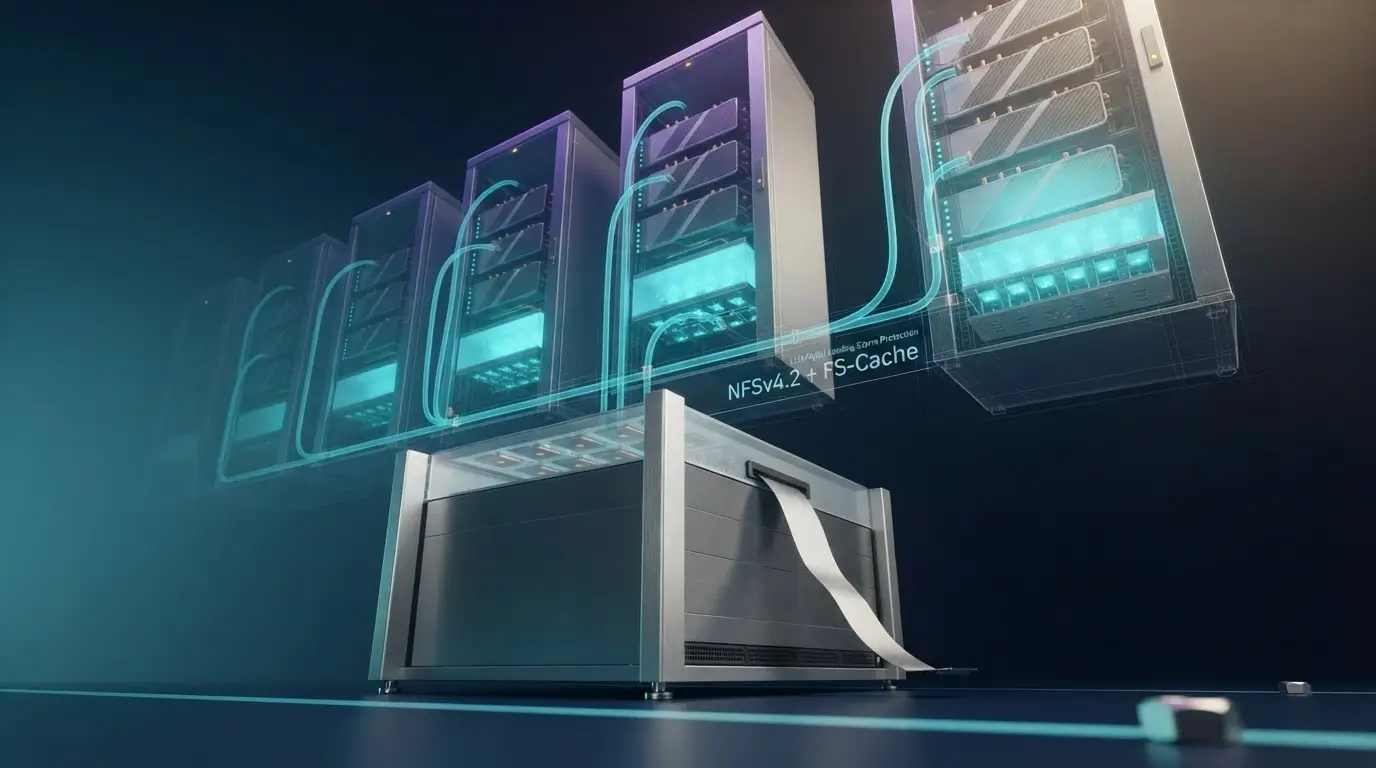
Практический runbook по NFSv4.2 и FS-Cache для весов LLM: локальный NVMe-кэш, прогрев, два уровня gates, rollout, наблюдаемость и rollback.
Практический runbook для защиты LLM-инференса от дефицита host RAM: PSI, cgroup v2, systemd-oomd, лимиты vLLM, алерты и аварийное восстановление.