Оглавление
- Быстрый вердикт: когда BGP-режим оправдан
- Как запрос доходит до GPU Pod
- ECMP и хеш: почему соединения распределяются неровно
- externalTrafficPolicy: Local или Cluster
- Базовая конфигурация FRR-K8s
- Диагностика по трём evidence gate
- Failover, BFD и Graceful Restart
- Canary rollout и симметричный rollback
- Граница контроля и выбор инфраструктуры
- Вывод и следующий шаг
VIP LLM API отвечает, BGP-сессии зелёные, но после перезапуска одного speaker поток токенов внезапно обрывается у сотен клиентов. В такой аварии легко обвинить GPU, ingress или модель, хотя реальная причина находится между ECMP-хешем маршрутизатора, набором BGP next hop и политикой Service. MetalLB не превращает bare-metal Kubernetes в магический облачный балансировщик: он публикует маршрут, а дальнейшее поведение определяют сеть и kube-proxy. Ниже — runbook, который отделяет принятие маршрута, фактический путь и результат запроса, а затем проводит изменение через canary и обратимый rollback.
Готовы перейти на современную серверную инфраструктуру?
В King Servers мы предлагаем серверы как на AMD EPYC, так и на Intel Xeon, с гибкими конфигурациями под любые задачи — от виртуализации и веб-хостинга до S3-хранилищ и кластеров хранения данных.
- S3-совместимое хранилище для резервных копий
- Панель управления, API, масштабируемость
- Поддержку 24/7 и помощь в выборе конфигурации
Результат регистрации
...
Создайте аккаунт
Быстрая регистрация для доступа к инфраструктуре
Быстрый вердикт: когда BGP-режим оправдан
BGP-режим MetalLB подходит, когда кластер стоит на bare metal или в среде без управляемого LoadBalancer, а сетевые маршрутизаторы умеют принимать несколько равнозначных маршрутов к одному VIP. Каждый speaker устанавливает BGP-соседство и объявляет адрес сервиса; маршрутизатор выбирает next hop, после чего kube-proxy или eBPF dataplane доставляет пакет до endpoint. Такая схема использует стандартный routing control plane и не требует отдельной appliance на каждый сервис.
Default-решение при этом простое: не включайте BGP только потому, что он выглядит «более production». Для небольшого кластера с одним входным узлом L2-режим или существующий внешний балансировщик могут иметь меньшую эксплуатационную цену. BGP имеет смысл, если нужны несколько активных путей, интеграция с ToR-маршрутизаторами, предсказуемая маршрутизация по стойкам и наблюдаемая политика анонсов.
Для LLM API важна оговорка: ECMP распределяет соединения, а не токены и не GPU-работу. Один длинный SSE-поток закрепляется за выбранным путем, а десятки запросов из одного NAT могут попасть на один узел при бедном 3-tuple хеше. Проверяли ли вы, какие поля реально использует ваш маршрутизатор и сколько независимых клиентских потоков есть в workload?
Не путайте этот runbook с общим обзором BGP Anycast. Здесь один Kubernetes-кластер, один VIP и локальный ECMP; цель — доказать, что маршрутизация не создаёт blackhole и не усиливает перекос GPU-нагрузки.
Как запрос доходит до GPU Pod
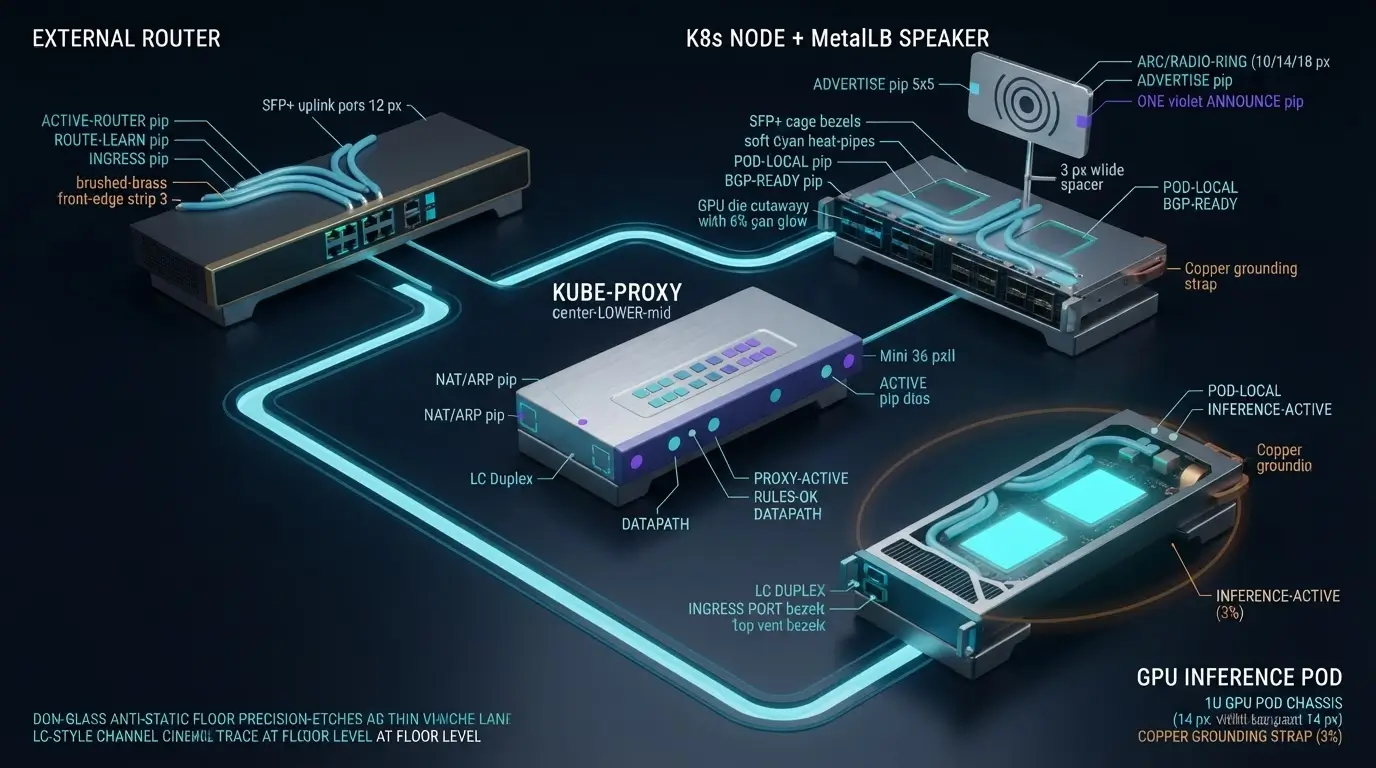
Разложите путь на владельцев. MetalLB controller назначает IP из IPAddressPool, speaker формирует анонс, FRR-K8s поддерживает BGP-сессию, маршрутизатор устанавливает маршрут и выбирает next hop, а узел Kubernetes решает, к какому endpoint отправить пакет. Ни один из этих компонентов сам по себе не подтверждает успех inference: Established у BGP означает лишь живую control-plane сессию.
Практический пример: VIP 203.0.113.50 объявляют три узла. Маршрутизатор видит три равных next hop и отправляет новый TCP-поток на node-b. При externalTrafficPolicy: Cluster node-b может переслать его к Pod на node-c. При Local node-b должен иметь локальный ready endpoint, иначе трафик не будет обслужен. Поэтому таблица маршрутов, EndpointSlice и фактический remote peer должны читаться вместе.
Начните с owner map: сеть отвечает за принятие и ECMP маршрута; MetalLB — за корректность анонса; Kubernetes — за endpoint eligibility; gateway — за HTTP/SSE lifecycle; inference runtime — за очередь и генерацию. Если TTFT вырос, но next hop и endpoint не изменились, тюнинг BGP вряд ли поможет. Если же после удаления speaker меняется peer и одновременно растут reset/timeout, связь уже предметная.
ECMP и хеш: почему соединения распределяются неровно
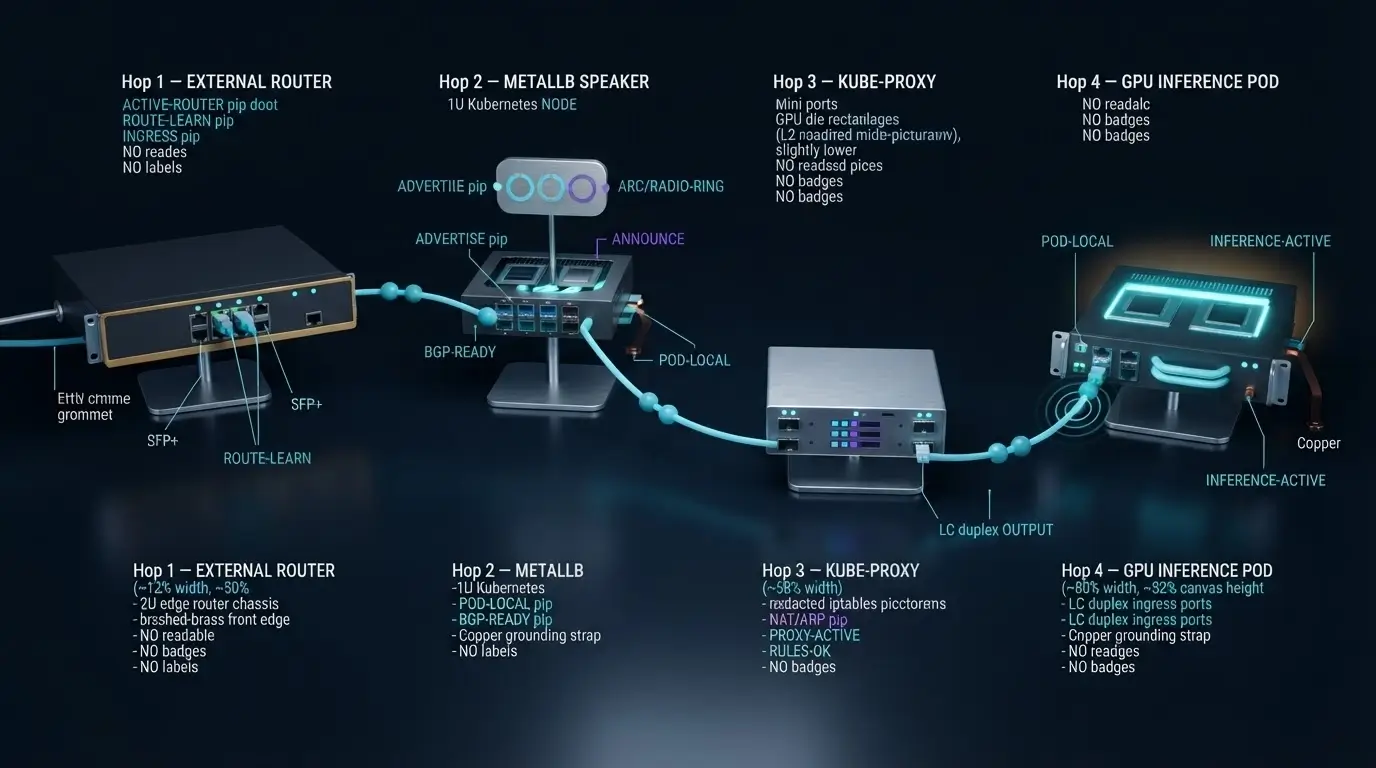
В BGP-режиме несколько узлов публикуют равнозначный маршрут, но сам факт наличия путей не гарантирует равномерность. Маршрутизатор обычно выбирает next hop по хешу полей пакета. При 5-tuple учитываются протокол, адреса и порты источника и назначения; при 3-tuple два порта не участвуют, поэтому множество соединений между одной парой адресов может прилипнуть к одному узлу.
Для LLM streaming это особенно заметно. Один корпоративный NAT скрывает сотни пользователей за одним source IP, соединения живут минуты, а нагрузка внутри каждого потока различается. Даже хороший 5-tuple балансирует количество flow, а не prompt length, KV cache или время генерации. Поэтому ECMP-гистограмму по next hop надо сопоставлять с активными соединениями gateway и GPU queue, не с числом пакетов в отрыве от приложения.
Официальная документация MetalLB предупреждает и о втором эффекте: когда набор next hop меняется, большинство обычных ECMP-хешей пересчитываются. Пакет существующего TCP-соединения может прийти на узел, который не знает его state, и клиент увидит reset. Resilient ECMP уменьшает долю перемещённых потоков, но его наличие и алгоритм зависят от конкретного маршрутизатора. Это не свойство MetalLB, которое можно включить одним CRD.
Соберите baseline до изменений: число путей к VIP, используемый hash policy, распределение новых соединений, resets, SSE disconnects и application success. Затем удалите только один canary next hop. Если маршруты перестроились, но существующие потоки не пострадали, это доказательство поведения вашего оборудования; если пострадали, ретраи допустимы лишь для идемпотентных запросов до application commitment.
externalTrafficPolicy: Local или Cluster
externalTrafficPolicy определяет, что происходит после попадания пакета на Kubernetes-узел. Значение Cluster разрешает доставку к ready endpoint на другом узле и обычно делает входной слой терпимее к неравномерному placement Pod. Цена — дополнительный hop, возможный SNAT и более сложное доказательство реального client IP.
Local сохраняет source IP и ограничивает выбор локальными endpoint. Это полезно для сетевой политики, аудита и уменьшения межузлового трафика, но создаёт жёсткий инвариант: каждый рекламирующий VIP узел должен действительно иметь локальный serving endpoint. Иначе control plane показывает маршрут, а data plane получает blackhole. Недавний отдельный материал про source IP раскрывает границу доверия PROXY protocol; здесь важнее eligibility узла.
Kubernetes поддерживает ProxyTerminatingEndpoints: при Local и наличии только terminating local endpoints kube-proxy может продолжить направлять к ним трафик для graceful drain. Это поведение стабильно с Kubernetes 1.28, но оно не заменяет readiness, terminationGracePeriodSeconds и корректное завершение gateway. Terminating означает «ещё способен обслуживать», а не «можно принимать новую тяжёлую генерацию без ограничений».
Выбор делайте через требование. Нужен исходный IP и строго node-local путь — Local, но speaker placement, endpoint placement и drain становятся единой операционной системой. Нужна доступность при разреженных GPU Pod — Cluster часто безопаснее, а client identity лучше переносить на доверенный L7-слой. Не переключайте policy одновременно с BGP backend: иначе при сбое не поймёте, какая граница изменила outcome.
Базовая конфигурация FRR-K8s без скрытых допущений
Актуальная документация MetalLB на дату запуска называет FRR-K8s default BGP backend. Старый прямой FRR mode помечен deprecated и должен уступить FRR-K8s. Не переносите старую values-конфигурацию вслепую: сначала зафиксируйте версию chart и CRD, затем проверьте API поля в установленном кластере командой kubectl explain.
Минимальный набор состоит из IPAddressPool, BGPPeer и BGPAdvertisement. Пример использует документационные адреса RFC 5737 и private ASN; замените их на свой адресный план. Peer должен быть доступен с выбранного source address, а маршрутизатор — разрешать multipath для одинакового префикса. Без multipath вы получите BGP, но не active-active ECMP.
apiVersion: metallb.io/v1beta1
kind: IPAddressPool
metadata:
  name: llm-public
  namespace: metallb-system
spec:
  addresses:
    - 203.0.113.48/29
---
apiVersion: metallb.io/v1beta2
kind: BGPPeer
metadata:
  name: tor-a
  namespace: metallb-system
spec:
  myASN: 64512
  peerASN: 64500
  peerAddress: 192.0.2.1
---
apiVersion: metallb.io/v1beta1
kind: BGPAdvertisement
metadata:
  name: llm-public
  namespace: metallb-system
spec:
  ipAddressPools:
    - llm-public
aggregationLength: 32Анонс отдельного IPv4 VIP как /32 проще наблюдать и отзывать, чем агрегат, который продолжает существовать при исчезновении конкретного сервиса. Агрегация нужна, если upstream не принимает более специфичные маршруты, но тогда вы обязаны иметь корректный маршрут к каждой части агрегата. Иначе «красивый» /24 превращает отсутствие сервиса в сетевой blackhole.
Ограничивайте анонсы через nodeSelectors и serviceSelectors, когда ownership различается по стойкам или окружениям. Это не оптимизация ради YAML: она уменьшает число next hop, за которыми команда реально способна поддерживать endpoint, BFD и change window. Пример с тремя GPU-узлами лучше десяти speaker-узлов, если только три из них входят в проверенный failure domain.
Перед apply сохраните текущие CRD и маршрутный baseline. Не используйте main-образы: официальный репозиторий прямо предупреждает, что development branch может быть несовместимым. На дату исследования актуальный стабильный релиз следует перепроверить в release notes и закрепить digest в вашем deployment-процессе; статья намеренно не обещает, что номер версии останется прежним.
Диагностика по трём evidence gate
Первый gate — route acceptance. Убедитесь, что speaker считает сессию Established, нужный префикс экспортируется, peer его принимает, а FIB содержит ожидаемое число next hop. Лог MetalLB без таблицы маршрутизатора — половина доказательства: route-map, max-prefix или фильтр длины могут молча изменить результат.
Второй gate — фактически выбранный путь. Выполните несколько новых соединений из контролируемых source IP и портов, затем сопоставьте packet capture или flow telemetry на ToR и узле. Старый keepalive нельзя использовать как тест нового ECMP: он уже закреплён за прежним next hop. Для SSE отдельно пометьте соединения до и после изменения набора путей.
Третий gate — application outcome: HTTP status до начала stream, получение первых токенов, корректное завершение и отсутствие повторной обработки. Один успешный TCP handshake не означает, что запрос дошёл до нужного GPU runtime. Полезно сравнивать с неизменным endpoint и одинаковым prompt-классом, но не публиковать latency как универсальный benchmark: она зависит от модели, batching и очереди.
kubectl -n metallb-system get bgppeers,bgpadvertisements,ipaddresspools
kubectl -n metallb-system get pods -l app.kubernetes.io/component=speaker -o wide
kubectl -n inference get svc llm-api -o yaml
kubectl -n inference get endpointslices \
  -l kubernetes.io/service-name=llm-api -o wide
kubectl -n metallb-system logs -l app.kubernetes.io/component=speaker \
  --since=10m --prefix
curl --no-keepalive --connect-timeout 3 \
-sS -D - https://llm.example.net/healthz -o /dev/nullКоманды на маршрутизаторе различаются по vendor, поэтому статья не подменяет их выдуманным универсальным CLI. Нужны четыре факта: статус peer, received/accepted prefix, installed multipath next hop и счётчики пакетов по каждому пути. Зафиксируйте их в change ticket вместе с точным временем, чтобы связать с Kubernetes events и application logs.
Типичная ловушка — смотреть legacy Endpoints. Kubernetes помечает этот API deprecated с версии 1.33; EndpointSlice содержит ready, serving, terminating и node name, нужные для разбора Local/drain. Другая ловушка — считать route count метрикой capacity. Четыре next hop могут вести к одному перегруженному GPU deployment.
Если симптомы похожи на DNS или egress, не растягивайте BGP-гипотезу на весь путь. Отдельный runbook Cilium FQDN egress показывает, как разделять resolver, policy и application cache. Здесь VIP уже разрешён, а исследуем мы ingress route и endpoint.
Failover, BFD и Graceful Restart: не смешивайте цели
BFD ускоряет обнаружение недоступного forwarding path. Graceful Restart решает другую задачу: позволяет временно сохранить маршруты во время восстановления BGP control plane, если forwarding plane продолжает работать. Включить оба механизма и назвать это «быстрым безопасным failover» нельзя. RFC 5882 отдельно разбирает их взаимодействие и зависимость от того, разделяют ли BFD и control plane общую судьбу.
MetalLB допускает enableGracefulRestart на BGPPeer и прямо предупреждает: совместная работа GR и BFD зависит от реализации vendor и требует теста. Поле GR immutable, поэтому эксперимент должен учитывать пересоздание peer и возможный flap. Не включайте его первым изменением на production VIP.
Опасный сценарий выглядит так: speaker или узел уже не способен форвардить, но peer сохраняет stale route на время restart timer. Клиенты продолжают попадать в blackhole. Обратный риск — слишком агрессивный BFD рвёт peer при кратком control-plane событии и провоцирует ECMP rehash, который сбрасывает активные SSE-потоки. Настраивать таймеры нужно от failure budget приложения, а не от желания увидеть минимальное число в конфиге.
Проведите два разных drill. В первом перезапустите только FRR-K8s/speaker при сохранном forwarding plane и проверьте, удержался ли путь. Во втором реально разорвите link или остановите узел и убедитесь, что stale route не переживает data-plane отказ. В обоих случаях измеряйте новые соединения и уже начатые stream отдельно.
apiVersion: metallb.io/v1beta2
kind: BGPPeer
metadata:
  name: tor-a-gr-canary
  namespace: metallb-system
spec:
  myASN: 64512
  peerASN: 64500
  peerAddress: 192.0.2.1
  enableGracefulRestart: true
  nodeSelectors:
    - matchLabels:
network.kingservers.com/bgp-canary: "true"Если клиент автоматически повторяет запрос после reset, проверьте application commitment. До отправки headers и первого токена retry часто безопаснее; после начала SSE клиент мог уже показать часть ответа, а backend — записать usage или tool action. Подход к connection lifecycle и drain подробнее разобран в материале про HTTP/2 GOAWAY и gRPC keepalive. Для BGP правило то же: сетевой failover не даёт идемпотентность бизнес-операции.
Canary rollout и симметричный rollback
Безопасный rollout начинается не с изменения общего BGPAdvertisement, а с отдельного canary VIP или ограниченного набора узлов. Пометьте один узел label, создайте advertisement с node selector и направьте на VIP синтетический и небольшой реальный трафик. Production baseline остаётся неизменным и служит отрицательным контролем.
Порядок проверки фиксирован. Сначала peer и accepted route, затем установленный next hop, потом local endpoint/forwarding и лишь после этого LLM outcome. Если пропустить середину, успешный ответ может случайно прийти через старый путь. Если смотреть только сеть, можно не заметить duplicate request после клиентского retry.
Для canary нужны заранее определённые abort conditions: потеря маршрута, неожиданный next hop, отсутствие local endpoint, рост reset/timeout, незавершённые stream или расхождение application success с baseline. Пороговые значения берите из собственного SLO и наблюдаемого baseline; чужие проценты из статьи были бы ложной точностью.
Расширяйте охват по одному измерению: сначала ещё один узел в той же стойке, затем второй ToR, затем дополнительный failure domain. Не меняйте одновременно hash policy, BFD timers, externalTrafficPolicy и deployment placement. Четыре рычага дают 16 комбинаций причин, а аварийное окно редко позволяет разбирать их спокойно.
Rollback должен быть симметричен rollout: убрать canary advertisement или selector, дождаться withdrawal на peer, подтвердить возврат FIB и повторить те же fresh-connection и application probes. Простое «вернули YAML» ничего не доказывает, если peer продолжает держать stale route или клиентский pool использует старое соединение.
Граница контроля и выбор инфраструктуры
MetalLB BGP переносит часть функции балансировщика в существующую сеть. Вы получаете контроль над VIP, ASN, communities, rack-aware peering и change window, но вместе с ним — ownership маршрутизаторов, FRR-K8s, observability и failure drills. Это не бесплатная замена managed load balancer.
Shared VM подходит для лаборатории и внутренних сервисов, если сеть не обещает BGP peering и отказ домена не критичен. Выделенный network edge и dedicated/GPU-узлы оправданы, когда команда контролирует физические интерфейсы, ToR policy, MTU, BFD/GR compatibility, maintenance window и placement inference endpoint. Коммерческая ценность здесь в воспроизводимой границе управления, а не в обещании «меньше latency» без canary.
Disqualifier обязателен: новое железо не исправит 3-tuple hotspot за корпоративным NAT, неверный externalTrafficPolicy, retry storm, очередь внутри inference или плохо настроенный drain. Сначала докажите узкое место через route → peer → outcome. Только если проблема действительно в недоступной сетевой политике, noisy neighbor или невозможности согласовать failure domain, меняйте платформу.
Полезный вопрос для владельца сервиса: кто может в одном change window увидеть RIB/FIB маршрутизатора, EndpointSlice Kubernetes и завершение конкретного LLM stream? Если ответ распределён между тремя командами без общей временной шкалы, первый инфраструктурный апгрейд — наблюдаемость и owner map. Серверы следует выбирать уже под подтверждённую модель ответственности.
Для более широкого контекста Kubernetes AI-платформы пригодится материал про KServe, GPU Operator, Kueue и autoscaling. Он отвечает за размещение и масштабирование inference, тогда как этот runbook ограничен входным сетевым путём.
Вывод: сначала доказательство пути, затем тюнинг
MetalLB в BGP-режиме даёт bare-metal Kubernetes несколько активных путей к VIP, но не гарантирует равномерную GPU-нагрузку и бесшовность существующих соединений. Надёжная эксплуатация строится на трёх независимых доказательствах: маршрутизатор принял и установил ожидаемые next hop, конкретный новый поток пришёл на eligible endpoint, а LLM API корректно начал и завершил ответ.
ECMP-хеш, externalTrafficPolicy, BFD и Graceful Restart решают разные задачи. Их нельзя включать одним пакетом и оценивать по одной зелёной BGP-сессии. Сохраните неизменный baseline, выделите canary VIP или узел, меняйте по одному параметру и повторяйте одинаковые probes после rollback.
Практический следующий шаг — составить owner map и выполнить read-only диагностику из раздела выше: peer, accepted prefix, FIB next hop, EndpointSlice, fresh connection и application outcome. Если цепочка уже наблюдаема, назначьте небольшой failover drill на период низкой нагрузки. Если нет, сначала добавьте telemetry; именно она превращает BGP из сложной магии в управляемый production-инструмент.