Оглавление
- Что происходит с VPN и где проходит безопасная граница
- Почему отказ удалённого доступа особенно болезнен для AI API
- Как отличить ограничение от обычного сетевого инцидента
- Карта зависимостей: USER → ACCESS → ID → AI API → OBS
- Observability до инцидента: что измерять без анализа содержимого
- Архитектура непрерывности без обхода ограничений
- Runbook инцидента: DETECT → DECIDE → RECOVER
- Право, безопасность и коммуникации: что нужно согласовать заранее
- Когда помогают VPS, dedicated и операторская связность
- Как провести безопасное учение и не устроить настоящий outage
- Вывод: устойчивость начинается с доказательств, а не с обходных приёмов
Готовы перейти на современную серверную инфраструктуру?
В King Servers мы предлагаем серверы как на AMD EPYC, так и на Intel Xeon, с гибкими конфигурациями под любые задачи — от виртуализации и веб-хостинга до S3-хранилищ и кластеров хранения данных.
- S3-совместимое хранилище для резервных копий
- Панель управления, API, масштабируемость
- Поддержку 24/7 и помощь в выборе конфигурации
Результат регистрации
...
Создайте аккаунт
Быстрая регистрация для доступа к инфраструктуре
Что происходит с VPN и где проходит безопасная граница
Для инфраструктурной команды важно разделить три разных явления: ограничение доступа к конкретному сервису, деградацию определённого сетевого пути и общий сбой у оператора. Снаружи они похожи: туннель не поднимается, сессия обрывается, удалённый сотрудник теряет доступ к внутреннему AI API. Но выводы и ответственные стороны различаются.
Официальные и правовые источники подтверждают, что в России действуют меры против VPN-сервисов, не исполняющих требования законодательства. В письме Минцифры от 27 апреля 2026 года говорится о мерах против таких сервисов и возможности ограничения доступа при невыполнении требований. Одновременно критерии, действующие с 1 марта 2024 года, охватывают материалы, которые объясняют способы обхода блокировок, побуждают к нему или предлагают доступ к VPN именно для обхода. Поэтому эта статья не описывает способы обхода, маскировку трафика, смену портов, подбор протоколов для противодействия фильтрации и доступ к запрещённым ресурсам. Источники: письмо Минцифры и разъяснение о критериях.
Наша задача уже и практичнее: помочь владельцу легальной корпоративной системы понять, почему пропадает доступ к собственным ресурсам, какие доказательства собрать, как снизить зависимость от одного канала и как согласовать непрерывность с юристами, ИБ и провайдером. Это статья про resilience, а не про обход. Если организация работает в регулируемой отрасли или обрабатывает чувствительные данные, конкретную схему следует отдельно проверить с юридической службой.
Полезный первый вопрос: «Что именно недоступно и у кого?» Если не открывается один внешний ресурс, это одна история. Если из двух офисов и домашней сети одновременно недоступен ваш разрешённый корпоративный gateway, это уже инцидент доступности, которому нужны факты и владелец.
Почему отказ удалённого доступа особенно болезнен для AI API
В обычном веб-приложении пользователь иногда может дождаться восстановления или продолжить работу локально. В AI-контуре за одной точкой доступа часто стоят prompt gateway, хранилище документов, векторная база, GPU inference, аудит и система квот. Обрыв пути выключает не один экран, а целую рабочую цепочку: поддержка не получает подсказки, разработчик не проверяет модель, агент не завершает операцию.
Типичная ловушка — считать VPN самостоятельным продуктом. На практике это лишь транспортный слой. До первого токена запрос проходит через DNS, сеть оператора, точку удалённого доступа, проверку identity, policy engine, API gateway и очередь inference. Ответ затем должен вернуться по тому же или корректно согласованному пути. Сбой любого звена выглядит для пользователя как «AI не работает».
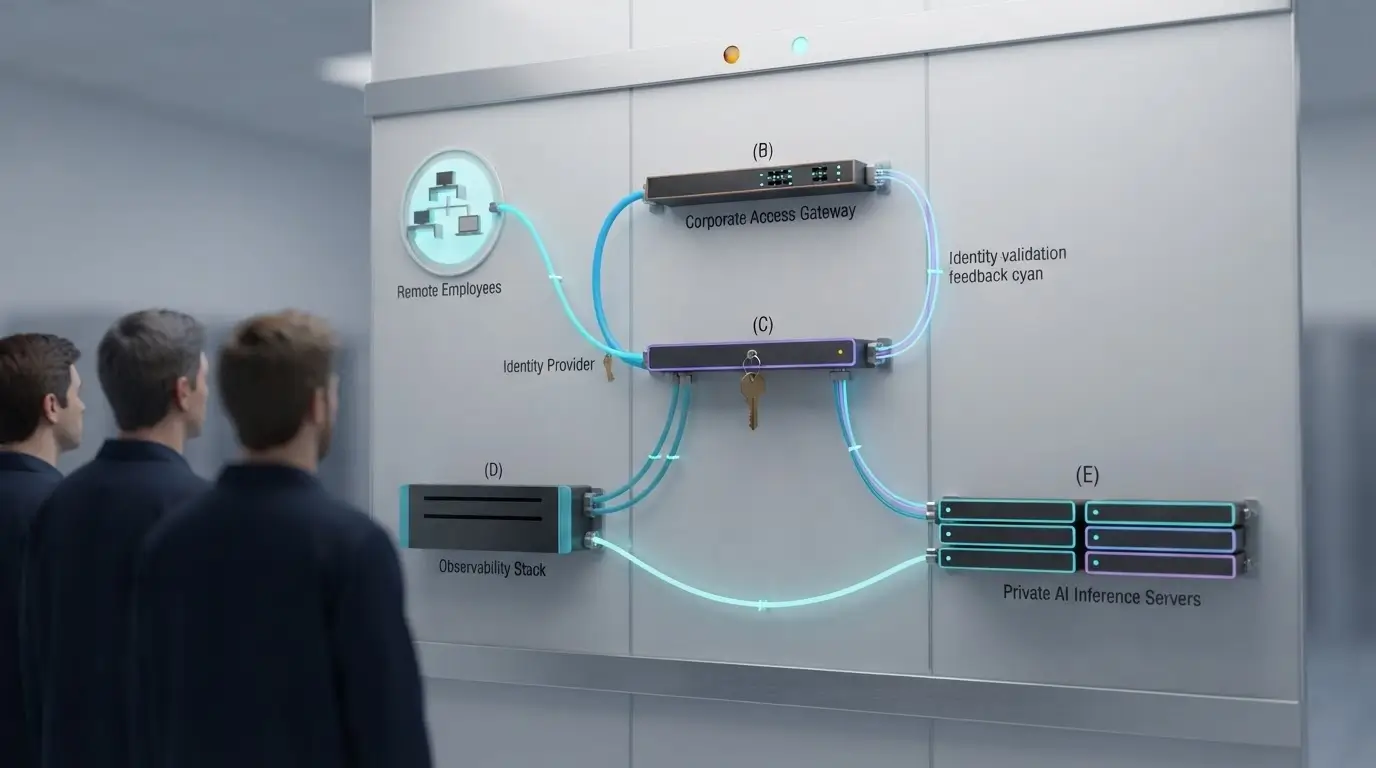
Составьте service map от пользователя до результата. Для каждого звена запишите владельца, SLO, способ проверки и допустимый fallback. Например, команда сети отвечает за достижимость gateway, IAM — за выдачу и отзыв identity, платформа — за AI API, владелец продукта — за корректность ответа. Эта карта отделяет отказ транспорта от истёкшего сертификата, ошибки авторизации, переполненной очереди GPU и проблем клиентского приложения.
Близкие материалы блога помогают развести уровни: архитектура Private AI API описывает сам сервис, а сравнение VPN, mTLS и IP allowlist показывает, какую identity доказывает каждый механизм. Здесь же фокус на непрерывности и управлении инцидентом.
Как отличить ограничение от обычного сетевого инцидента
Фраза «нас заблокировали» удобна, но плохо подходит для postmortem. Она объединяет разные причины и провоцирует рискованные изменения. Начните с воспроизводимого симптома: время, оператор, тип подключения, адрес разрешённого корпоративного endpoint, стадия соединения, доля затронутых пользователей и длительность.
Проверка должна быть безвредной и относиться только к вашей инфраструктуре. Используйте штатный клиент, официально разрешённый endpoint и согласованные тестовые учётные данные. Сравните офисную сеть, мобильного и фиксированного оператора, но не пытайтесь менять сигнатуру трафика или скрывать назначение соединения. Для каждого теста фиксируйте DNS-ответ, достижимость транспортной точки, успешность аутентификации и результат простого запроса к health endpoint собственного AI API.
Симптомы дают направление, а не окончательный вердикт. Timeout до gateway может означать маршрут, перегрузку, ACL, DDoS-защиту или ограничение на пути. Быстрый отказ после соединения чаще указывает на policy или authentication. Успешный вход с медленным первым токеном ведёт к очереди inference, модели или storage. Проверяли ли вы, что «сетевой» инцидент исчезает при обращении к тому же сервису из внутреннего сегмента?
Нужен и отрицательный контроль. Выберите другой разрешённый сервис на том же uplink и тот же AI API из доверенной внутренней сети. Если оба внешних сервиса деградируют, проблема шире VPN. Если внутренний запрос тоже медленный, смена доступа не вылечит GPU или базу. Такой контрфакт экономит часы и защищает от хаотичного тюнинга.
- Не делайте вывод по одному пользователю и одному оператору.
- Не смешивайте отказ соединения и отказ авторизации.
- Не принимайте успешный ping за доказательство работы приложения.
- Не меняйте прод без зафиксированного baseline и владельца rollback.
Карта зависимостей: USER → ACCESS → ID → AI API → OBS
Устойчивая архитектура начинается не со второго туннеля, а с границ ответственности. У пользователя есть устройство и локальная сеть. ACCESS отвечает за достижимость корпоративной точки. ID подтверждает личность или workload. AI API применяет авторизацию, квоты и маршрутизацию. OBS доказывает, что запрос действительно прошёл и дал приемлемый результат.
Эти уровни нельзя считать взаимозаменяемыми. Сетевой адрес не равен личности, наличие туннеля не означает право вызвать модель, а валидный токен не гарантирует достижимость endpoint. Если резервный транспорт автоматически наследует более широкие права, вы обменяли availability incident на security incident. Именно поэтому в плане непрерывности сначала фиксируют invariant: identity, least privilege, аудит и запрет прямого доступа к inference остаются неизменными.
Для каждого уровня запишите положительный и отрицательный тест. ACCESS: разрешённый endpoint доступен, а прямой origin закрыт. ID: активный сотрудник входит, отозванная credential отклоняется. AI API: тестовый запрос получает ожидаемый тип ответа, а запрос без scope — 403. OBS: событие видно в журнале с correlation ID, но секреты и содержимое чувствительных prompt не попадают в лог.
IETF в RFC 3809 рассматривает availability и stability VPN как отдельные требования и подчёркивает цену резервирования. Для практической команды вывод простой: разнообразие пути полезно только тогда, когда оба пути наблюдаемы, управляемы и не размывают модель доступа.
Observability до инцидента: что измерять без анализа содержимого
Если метрики появились после жалобы, команда уже работает вслепую. Нужен синтетический canary, который из согласованных точек проверяет ваш корпоративный endpoint и минимальный application outcome. Он не должен обходить контроль, передавать реальные данные или постоянно генерировать дорогие запросы к модели. Его задача — дать временную шкалу и разделить слои.
Минимальный набор включает успешность DNS, время установления транспортной сессии, результат аутентификации, HTTP-код health endpoint, latency gateway и отдельное время до первого токена тестовой модели. Добавьте operator/region label, но избегайте персональных данных. Для long-lived соединений отдельно учитывайте обрывы уже установленной сессии: они не видны в метрике connect success.
Не стройте детектор на одной средней. Пять минут полного отказа у одного оператора могут раствориться в глобальном 99,9%. Полезнее видеть долю ошибок по независимым vantage point, p95 установления сессии и число повторных подключений. Однако эти метрики не должны превращаться в обещание конкретного SLA без данных вашей системы.
Для AI workload добавьте очередь inference и saturation GPU. Иначе команда примет медленный первый токен за сетевую фильтрацию. Хороший alert отвечает на вопрос: «На каком слое началась деградация?» Плохой сообщает только: «VPN down». В материале про MTU и PMTUD для LLM API показан тот же принцип: низкоуровневый сигнал подтверждает механизм, а application canary подтверждает результат.
Практичная временная шкала
- T0: первый синтетический отказ и список затронутых vantage point.
- T+5: проверка gateway, IdP, сертификатов и внутреннего AI API.
- T+10: сравнение независимых операторов и открытие тикета провайдеру.
- T+15: решение incident commander по согласованному плану непрерывности.
Архитектура непрерывности без обхода ограничений
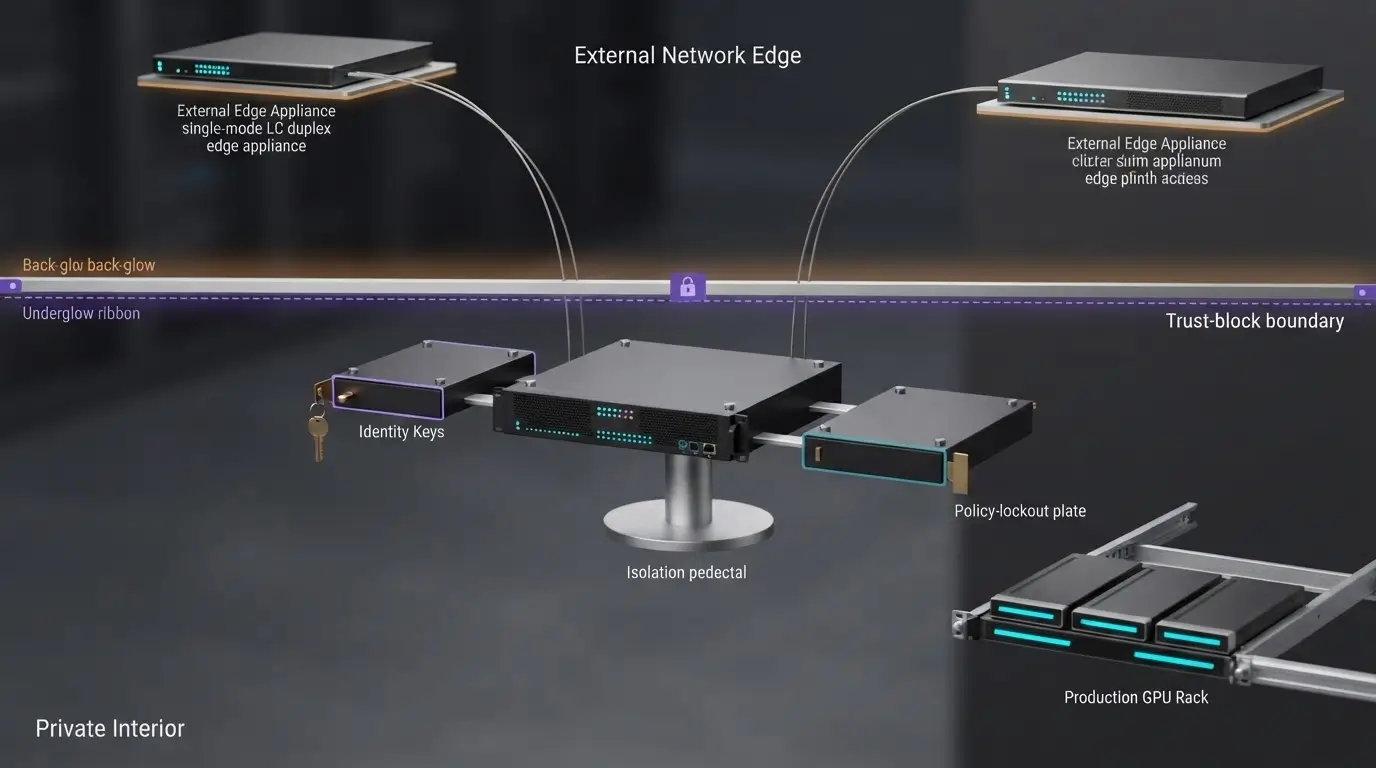
Правильный default — не изобретать «незаметный» протокол. Для законной корпоративной системы рассматривайте только согласованные каналы: операторскую корпоративную связность, частные межплощадочные услуги, доступ через разрешённые точки присутствия, локальную обработку критичных функций и организационные fallback-процессы. Конкретный выбор зависит от юрисдикции, договора, класса данных и заключения юристов.
Первый архитектурный приём — убрать единственную точку отказа за пределами вашей зоны контроля. Два gateway в одном дата-центре и один uplink не дают path diversity. Разные DNS-имена, ведущие в тот же балансировщик, тоже. Нарисуйте физический путь: last mile, оператор, межоператорское соединение, точка присутствия, firewall, identity и приложение. Затем спросите, какие элементы действительно независимы.
Второй приём — отделить доступ человека от server-to-server интеграций. Критичный batch, который вызывает частный AI API из вашего же серверного сегмента, не обязан зависеть от домашнего удалённого доступа сотрудника. Workload identity, отдельные квоты и service accounts уменьшают blast radius. Но не переносите пользовательские полномочия в безличный общий ключ: это разрушает аудит.
Третий приём — graceful degradation. Если AI-функция не является safety-critical, продукт может временно перейти в очередь, read-only режим или ручную обработку. Например, система поддержки сохраняет заявку и показывает оператору, что генерация подсказки задержана, вместо бесконечных retry. Это сохраняет данные и не создаёт шторм на gateway после восстановления.
Наконец, заранее согласуйте stop conditions. Если резервный канал не прошёл identity negative control, журналирование или проверку прямого origin, его нельзя активировать ради красивой зелёной метрики. Availability без security и compliance не считается восстановлением.
Runbook инцидента: DETECT → DECIDE → RECOVER
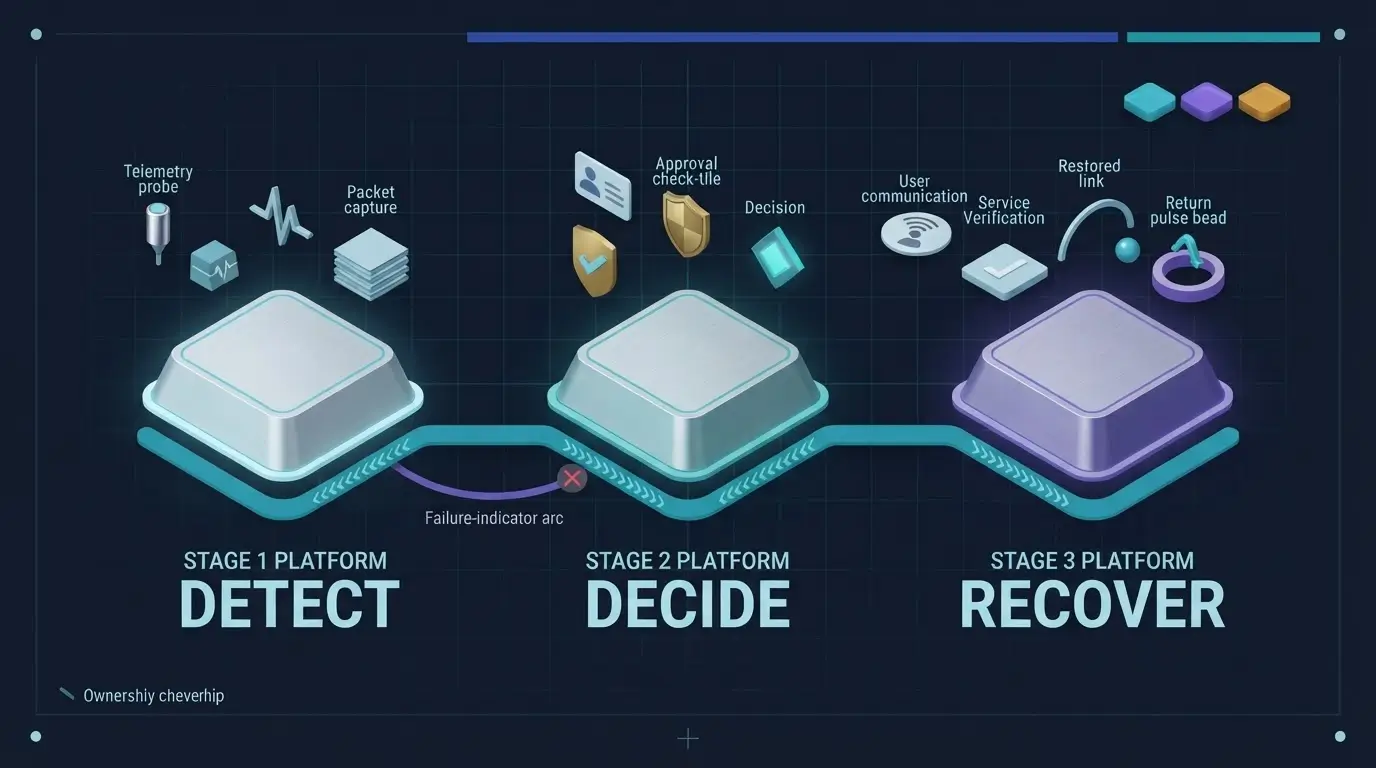
Runbook нужен не для того, чтобы автоматически менять сетевую схему при первом timeout. Его задача — быстро собрать факты, назначить владельца решения и восстановить разрешённый сервис предсказуемым способом. Incident commander должен быть один; сеть, ИБ, платформа, support и юристы дают ему данные в заранее оговорённом формате.
DETECT: зафиксировать симптом
Сохраните время начала, оператора, географию, тип сети и correlation ID тестов. Проверьте внутренний AI API, IdP, сертификат и доступность gateway из доверенного сегмента. Сравните не меньше двух независимых разрешённых vantage point. Не объявляйте причину до завершения этих проверок.
DECIDE: выбрать допустимое действие
Сверьте incident с юридически и технически утверждённой матрицей. Можно ли активировать заранее согласованный корпоративный канал? Должен ли продукт перейти в очередь или ручной режим? Кто уведомляет сотрудников и клиентов? Решение должно содержать scope, owner, время следующей оценки и stop condition. «Попробовать другой протокол» без согласования в такой матрице не является планом.
RECOVER: доказать результат
После изменения повторите ту же цепочку: ACCESS, ID, AI API, OBS. Проверьте положительный canary, отрицательный identity test и закрытый origin. Затем наблюдайте error rate, reconnect storm, очередь gateway и inference saturation. Возвращение одной сессии не означает восстановление сервиса.
Rollback симметричен rollout. Верните baseline тем же механизмом управления, повторите те же тесты и сохраните временную шкалу. Если переключение нельзя отменить контролируемо, его не следует выполнять в разгар инцидента. В postmortem отделите подтверждённые факты от предположений о внешней причине.
Право, безопасность и коммуникации: что нужно согласовать заранее
Повторим ключевой дисклеймер: этот материал не предлагает обход блокировок и не содержит инструкций по доступу к запрещённым ресурсам. Мы рассматриваем доступность собственной корпоративной инфраструктуры и разрешённые меры business continuity. Правовой режим меняется, поэтому статья не заменяет консультацию юриста и условия договора с оператором.
У плана должны быть три подписи: технического владельца, ИБ и legal/compliance. Технический владелец подтверждает работоспособность и rollback. ИБ проверяет identity, сегментацию, журналирование и секреты. Юристы оценивают назначение канала, контрагентов, трансграничную передачу данных, рекламу и применимые ограничения. Для персональных данных добавляется владелец privacy-процесса.
Коммуникация сотрудникам должна быть скучной и точной. Не отправляйте в общий чат непроверенные «лайфхаки» и ссылки на случайные клиенты. Сообщите статус, затронутые функции, разрешённый временный процесс, канал поддержки и время следующего обновления. Если доступа нет, так и напишите; не подталкивайте людей к самостоятельным экспериментам на рабочих устройствах.
Внешнее сообщение ещё строже. Называйте пользовательский эффект, а не недоказанную причину. Формула «часть пользователей из некоторых сетей не может подключиться; данные сохранены; работает ручной fallback; следующее обновление в 14:00» полезнее, чем «нас блокирует РКН», если подтверждения нет. Это снижает юридический риск и помогает support отвечать одинаково.
Храните решение об активации fallback рядом с incident timeline: кто разрешил, на каком основании, какие данные проходят по пути, когда решение истекает. Временное исключение без срока быстро становится постоянной дырой.
Когда помогают VPS, dedicated и операторская связность
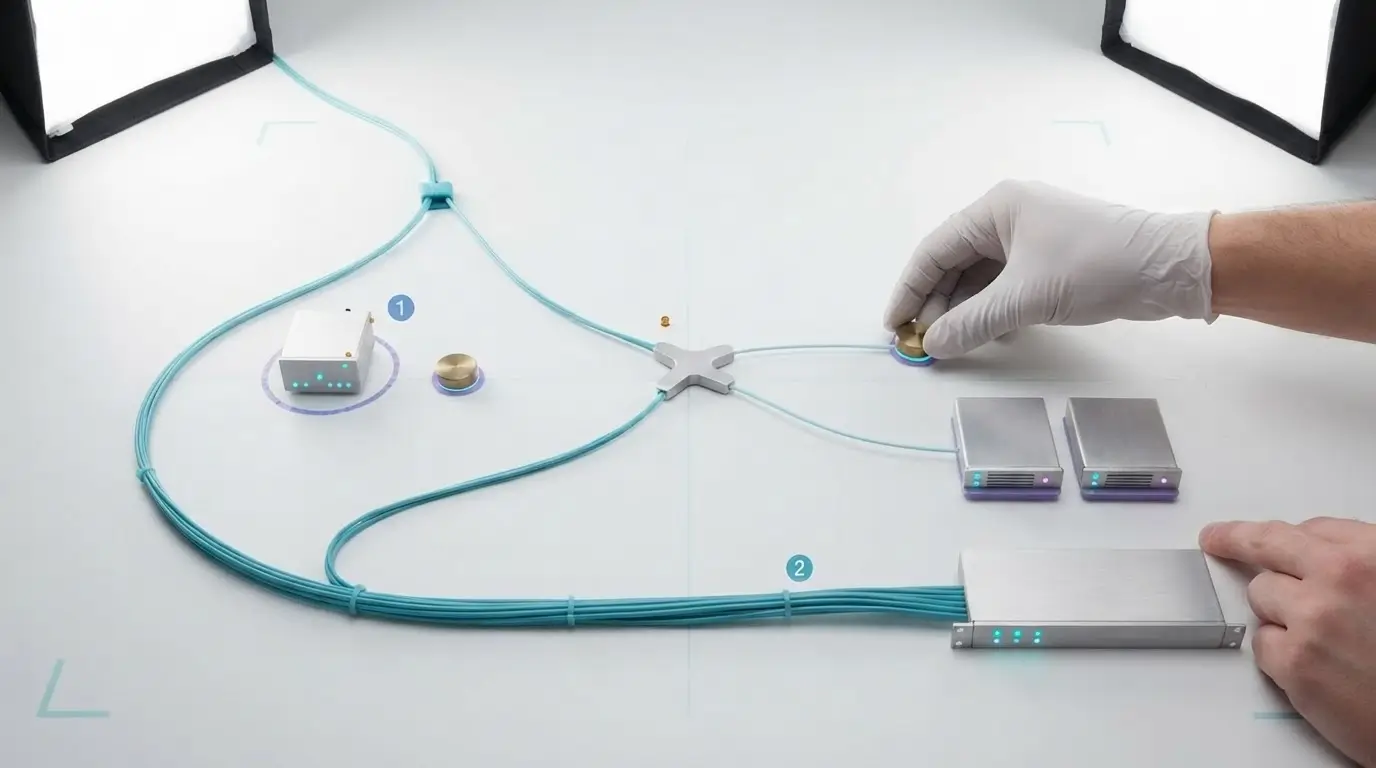
Новая инфраструктура помогает только после доказанного bottleneck и понятной границы контроля. VPS может быть разумной площадкой для небольшого корпоративного gateway, synthetic probes или изолированного canary, если провайдер, юрисдикция и назначение соответствуют требованиям компании. Выделенный сервер полезен, когда нужны предсказуемый resource envelope, собственное change window и отсутствие noisy neighbor на сетевом или криптографическом контуре.
Но железо не исправляет всё. Новый dedicated server не лечит истёкший сертификат, ошибочную policy, retry storm, утечку соединений, перегруженную модель или юридически недопустимый сценарий. Два сервера за одним uplink не дают независимости. А перенос gateway без сохранения identity lifecycle способен увеличить риск сильнее, чем исходный downtime.
Операторская корпоративная связность часто дороже и медленнее внедряется, зато даёт договорную границу, техническую поддержку и возможность обсуждать SLA. Для критичных площадок это может быть сильнее случайного набора интернет-туннелей. IETF отдельно отмечает сложность гарантировать высокую доступность через нескольких провайдеров без согласования уровня сервиса; резервирование требует ресурсов и управления.
Практичный decision helper сравнивает варианты по пяти колонкам: owner пути, identity, data jurisdiction, change window и rollback. Добавьте стоимость on-call, а не только аренды. Чем больше независимых компонентов, тем больше сертификатов, журналов, тестов и людей должны работать ночью. Иногда лучший выбор — не усложнять сеть, а вынести критичный server-to-server workload внутрь контролируемого сегмента и дать пользователям graceful degradation.
При выборе площадки для AI-контура полезно отдельно оценить compute и access. GPU может жить на выделенном GPU-сервере, а gateway — на иной управляемой точке с меньшим blast radius. Не связывайте жизненный цикл модели и удалённого доступа одним изменением.
Как провести безопасное учение и не устроить настоящий outage
План, который существует только в документе, почти наверняка подведёт. Но учение не должно имитировать регуляторное ограничение методами сокрытия трафика. Достаточно контролируемо отключить один разрешённый тестовый путь в собственной среде или изолировать canary-группу на уровне вашего gateway. Цель — проверить людей, наблюдаемость и переключение, а не соревноваться с внешней фильтрацией.
Начните с tabletop exercise. Дайте участникам сценарий: часть сотрудников у одного оператора теряет доступ, внутренний AI API здоров, gateway доступен не со всех vantage point. Пусть команда назовёт владельца, первые четыре проверки, канал legal approval, сообщение пользователям и stop condition. Уже на этом этапе обычно находятся отсутствующие телефоны и непонятные полномочия.
Затем проведите технический canary на малой группе. Зафиксируйте baseline, окно, максимальную длительность и автоматический возврат. Проверьте не только connect success, но и identity negative control, application outcome, журналирование и закрытый origin. Если растёт очередь, появляются повторные подключения или теряется аудит, остановите тест.
Метрики учения должны описывать управляемость: время до обнаружения, время до правильной классификации, время до утверждённого решения, доля успешных canary, полнота журнала и время rollback. Не выдумывайте универсальные целевые минуты: они зависят от бизнеса и SLO. Важнее сравнить повторные учения одной команды и закрыть конкретные пробелы.
После возврата к baseline удалите временные исключения, отзовите тестовые credential, приложите логи к отчёту и назначьте владельцев action items. Проверяли ли вы, что временный fallback действительно выключен, а не просто перестал использоваться?
Вывод: устойчивость начинается с доказательств, а не с обходных приёмов
Ограничения работы VPN-сервисов и нестабильность отдельных путей — реальный риск для компаний, которые построили удалённый доступ к внутренним AI-системам вокруг единственного канала. Но безопасный ответ состоит не в поиске маскировки или очередного «неблокируемого» протокола. Он состоит в том, чтобы знать цепочку USER → ACCESS → ID → AI API → OBS, различать симптомы, заранее согласовать допустимые каналы и уметь доказать application outcome.
Начните с малого: нарисуйте service map, назначьте владельцев, добавьте два независимых canary и проведите tabletop exercise. Затем вместе с ИБ и юристами решите, нужна ли операторская связность, отдельный VPS, dedicated gateway, локальный server-to-server путь или всего лишь исправление сертификата и retry policy. Default простой: не меняйте инфраструктуру, пока не доказана причина.
Финальный дисклеймер: KingServers и автор не предлагают обход блокировок, доступ к запрещённым ресурсам или сокрытие назначения трафика. Материал посвящён только законной эксплуатации собственной инфраструктуры, безопасности и непрерывности бизнеса. Перед внедрением конкретной сетевой схемы проверьте актуальное законодательство, требования к данным и договоры с операторами.
Если вашей команде нужен контролируемый baseline для частного AI API, gateway или наблюдаемости, начните с инвентаризации workload и failure domain. Так разговор о VPS или выделенном сервере будет предметным: какой ресурс изолируем, какой SLO проверяем и как откатываемся. Хороший план непрерывности не обещает отсутствие инцидентов. Он делает следующий шаг понятным, разрешённым и проверяемым.