


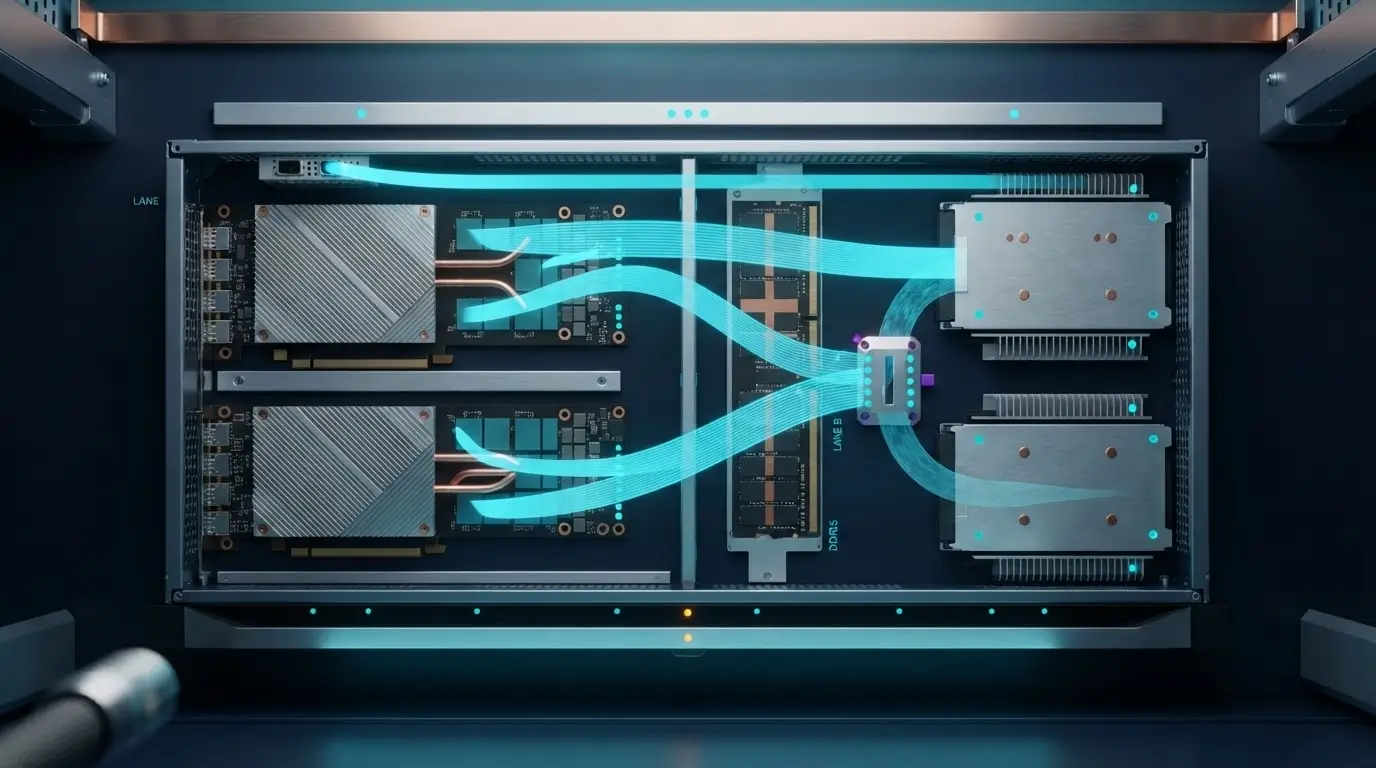
I/O-изоляция LLM-узла: cgroup v2 и systemd против штормов NVMe
Практический runbook по I/O-изоляции LLM-узла: cgroup v2 io.max, systemd slices, PSI, два gate, canary rollout и rollback.
Андрей Минин, автор блога

Быстрая установка и выдача VPS/VDS серверов в течение <5 минут.

Виртуальный частный сервер (VPS) с Windows

Для проектов, ориентированных на аудиторию в Российской Федерации и ближайших странах. Соблюдение 152-ФЗ.

Отлично подойдут для проектов под американскую аудиторию.

Идеальная локация для глобальных проектов. Лояльное законодательство

Эффективная защита от DDoS-атак уровня L2-L7. Многоуровневая фильтрация.
Получите готовый сервер в течение 1 рабочего дня.

Сконфигурировать сервер под заказ на новейшем серверном оборудовании.

Серверы с безлимитными каналами 1 Гбит/с, 10 Гбит/с, 20 Гбит/с и 40 Гбит/с

Высокопроизводительные серверы на AMD EPYC.
Высокопроизводительные серверы на AMD RYZEN.

Сбалансированное решение для средних и крупных проектов.

Серверы с GPU процессор для машинного обучения, 3D-моделирования, рендеринга и других ресурсоемких задач.

Узнайте больше о дата-центрах, которые использует наша компания.

Узнайте больше об использовании серверов в жизни и в бизнесе.

Больше об опыте наших клиентов.

Зарабатывайте до 35% от стоимости услуг хостинга на протяжении всего периода пребывания клиентов.

Свяжитесь с нашими специалистами, для заказа услуг или решения технических вопросов.

Ознакомиться с информацией о нашей компании, оборудовании и инфраструктуре
Практический runbook по I/O-изоляции LLM-узла: cgroup v2 io.max, systemd slices, PSI, два gate, canary rollout и rollback.
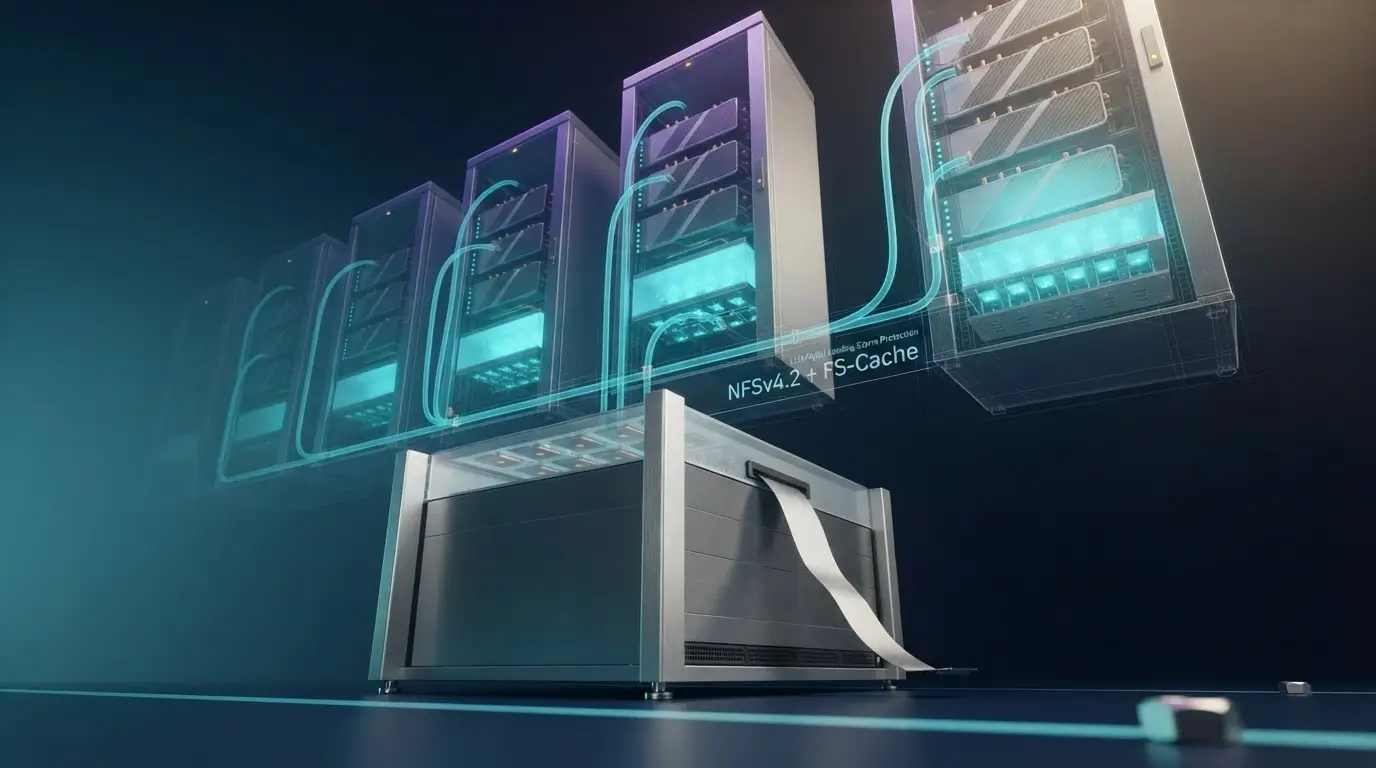
Практический runbook по NFSv4.2 и FS-Cache для весов LLM: локальный NVMe-кэш, прогрев, два уровня gates, rollout, наблюдаемость и rollback.
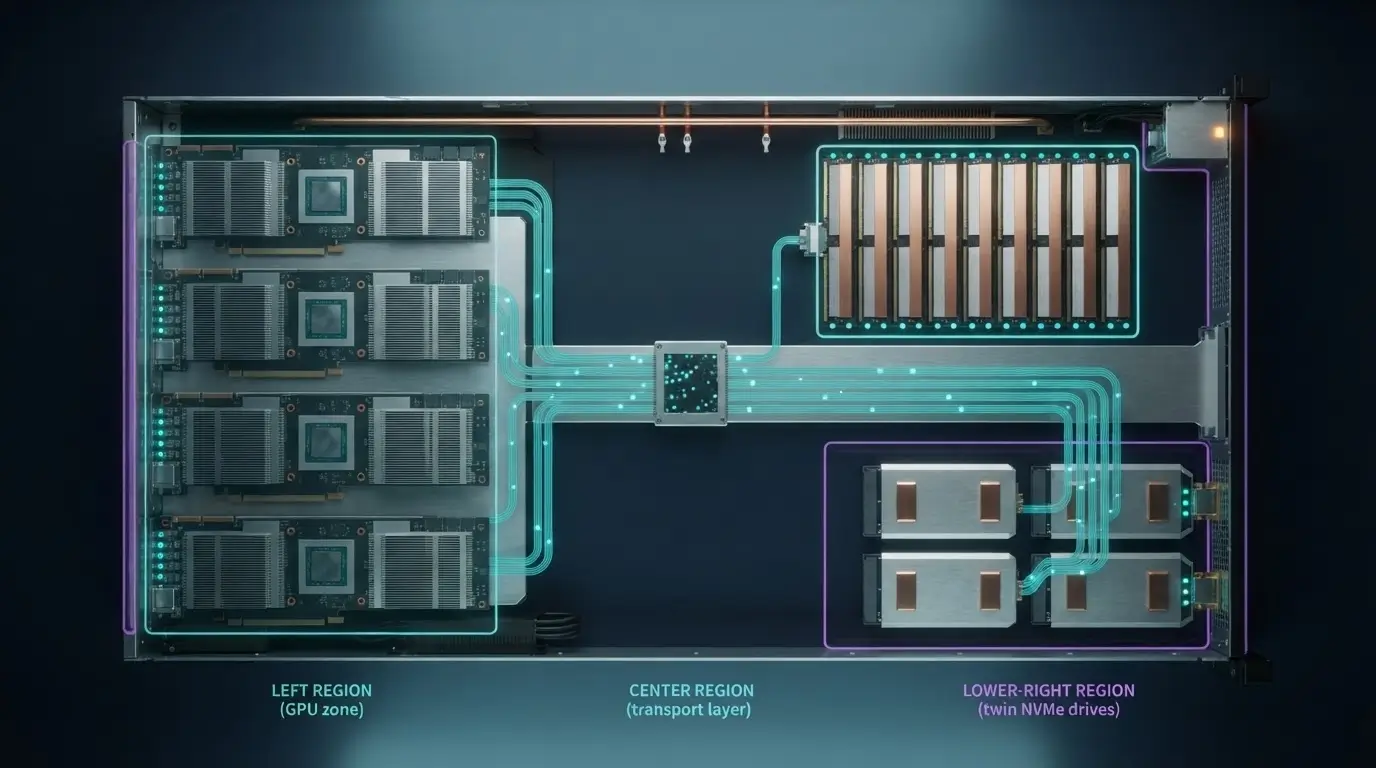
Практический runbook по LMCache MP для vLLM: архитектура node-local KV-кеша, resource budget, проверки hit/miss, Kubernetes, метрики и rollback.
Практический runbook для защиты LLM-инференса от дефицита host RAM: PSI, cgroup v2, systemd-oomd, лимиты vLLM, алерты и аварийное восстановление.
Практический runbook: NVIDIA Container Toolkit CDI, rootless Podman и Docker, выбор GPU/MIG, запуск vLLM, hardening, обновления и rollback.
Практический гид по Kubernetes DRA для GPU: ResourceClaim, DeviceClass, NVIDIA DRA Driver, canary-rollout, RBAC, наблюдаемость и безопасный откат.
Практический runbook по NVIDIA Xid: сбор доказательств, ECC и row remapping, Xid 79, DCGM Diagnostics, reset GPU и безопасный drain Kubernetes-узла.
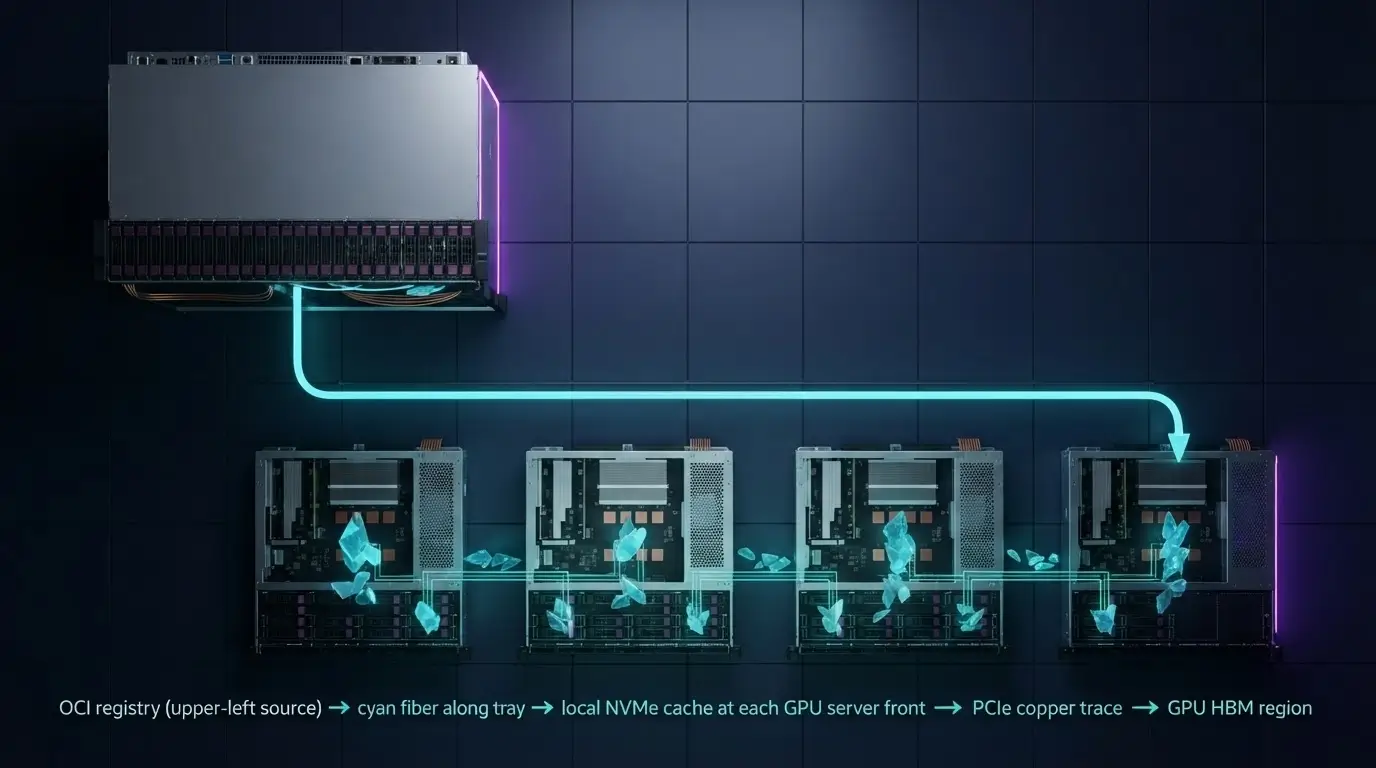
Практическая схема доставки и кэширования весов LLM: OCI-артефакты, Kubernetes ImageVolume, KServe LocalModel и локальный NVMe без повторных загрузок.
Как использовать CXL Type-3 memory expansion в AI inference: Linux, NUMA, vLLM offload, memory pooling, ограничения и практический чек-лист.
